株式会社ZOZO の技術ブログ
全1072件
はじめに こんにちは。MA部MA開発ブロックの平井です。 ZOZOTOWNでは、プッシュ通知・LINE・メール・サイト内お知らせなどを通じてキャンペーン配信をしています。 MA部ではそれらの配信を担うマーケティングオートメーション(MA)システムの開発を担当しています。 私たちは現在、マーケティングプラットフォーム「ZOZO Marketing Platform(ZMP)」の開発を進めています。 そのプロジェクトの一環として、リアルタイムマーケティングシステムのリプレイスを実施しました。 ZMPの詳細については、以下のテックブログをご参照ください。 techblog.zozo.com 本記事では、リプレイス後の新システムの概要と、安全に本番リリースをするために実施した「シミュレーション試験」についてご紹介します。 目次 はじめに 目次 リアルタイムマーケティングシステムのリプレイスについて リアルタイムマーケティングシステムとは リプレイスの目的 システム課題の解決 キャンペーン運用管理コストの低減 リプレイス前のアーキテクチャ リプレイス後のアーキテクチャ 各モジュールの説明 管理画面API アクセスログ集計 データ基盤連携 トリガー判定 セグメント抽出 最適化 配信ワークフロー基盤、配信基盤 技術選定 アプリケーションインフラ データベース 言語 シミュレーション試験について 実施背景 実施するための準備 検証項目 試験を実施した結果 データベース負荷トレンドの把握 BigQueryコストの把握 監視設定の精度向上 データマートのチューニングによるキャンペーン精度の向上 バグの事前発見 リプレイスの結果 まとめ リアルタイムマーケティングシステムのリプレイスについて リアルタイムマーケティングシステムとは リアルタイムマーケティングシステムでは、ユーザの行動や商品情報等データの変更を検知し、ユーザへリアルタイムでアクションを行います。 例えばある商品の値段が下がったとき、その商品情報をリアルタイムに検知し、その商品をお気に入りしているユーザに対して配信します。 リプレイスの目的 リプレイスの目的は大きく2つありました。 システム課題の解決 キャンペーン運用管理コストの低減 システム課題の解決 既存のシステムでは、JBoss Data Grid(JDG)というインメモリな分散キャッシュデータストアを使用していました。 また、JavaアプリケーションとJDGを同一のJVMで動かす構成になっていました。 上記の構成はパフォーマンスを最大化するための構成でした。また、コスト制約や運用方針に起因する以下のような課題が存在していました。 スケーラビリティが低い ミドルウェアの制約でスケーラビリティに制限がある。 システムメンテナンス性が低い リリース時にキャッシュの再ロードのためにメンテナンス作業が必要。 システム耐障害性が低い キャッシュが壊れた際のメンテナンス対応に時間がかかる。また、JDGの情報がインターネット上に少なく、障害対応等が行いづらい。 開発コストが高い 知見の少ないフレームワークのため機能改修に時間がかかる。 既存システムで利用されていた技術や課題の詳細については以下テックブログを参照ください。 techblog.zozo.com キャンペーン運用管理コストの低減 既存のシステムでは、キャンペーン周期などキャンペーンに関わるルールをExcelファイルで管理していました。 マーケターがキャンペーンのルールを変更したい場合は、エンジニアがExcelファイルを修正してリリース作業を行う必要があり、運用しづらい状況でした。 そこで、管理画面からキャンペーンを管理できるようにして、マーケターが運用できるようにする必要がありました。 リプレイス前のアーキテクチャ リプレイス前はEC2上にモノリスな形でJavaアプリケーションが構築されていました。 リプレイス後のアーキテクチャ 上記課題を解決するリプレイス後のアーキテクチャは以下のとおりです。 既存システムはAWS上に構築されていましたが、新システムは他システムとの連携などを考慮してGoogle Cloud上に構築されています。 モジュール毎にアプリケーションが分かれていて各モジュールはPub/Sub経由で連携することで、スケーラビリティを実現しています。 各モジュールの説明 データ基盤連携がトリガーとなり、トリガー判定、セグメント抽出、最適化、配信処理という処理の順番で配信処理が動作します。 管理画面API このAPIはマーケターが利用する管理画面からリクエストされます。キャンペーン情報がAPIを通じてデータベースに登録され、管理画面上でマーケター自身によって運用・管理できるようになりました。 アクセスログ集計 ユーザーのZOZOTOWNへのアクセスログを集計しています。そのデータは後続のセグメント抽出などで利用されます。 データ基盤連携 ZOZOTOWNの商品情報、在庫情報などを連携しています。ここでの在庫、価格更新がトリガーとなり後続の処理が動きます。 トリガー判定 ZOZOTOWN側でのデータ更新が各キャンペーンで定義されている条件に当てはまるかを判定しています。条件に当てはまった場合は後続の処理に続きます。 セグメント抽出 トリガー判定された情報を元に対象の会員を抽出します。キャンペーン毎に対象のセグメント情報が設定されています。 最適化 最後に、ユーザーにとってより良い訴求になるように時間帯やチャネルの最適化を行います。ここまでがリアルタイムマーケティングシステムの責務です。 配信ワークフロー基盤、配信基盤 最適化で生成された配信情報を元に、配信処理を行います。 メール配信を担当するメール配信基盤については以下テックブログを参照ください。 techblog.zozo.com 技術選定 アプリケーションインフラ 以下の理由からCloud Runをアプリケーションインフラに利用しています。 部内で利用実績がある。 スケーラビリティが高いため。 データベース 以下の理由からAlloyDBをデータベースとして利用しています。 大規模テーブルに対するリアルタイム分析(OLAP)と在庫・価格変動の即時トラッキング(OLTP)を同時に行う、HTAP(ハイブリッド・トランザクション/アナリティカル・プロセッシング)を実現するため。 読み取りプールを構成でき、用途にあったインスタンスを構築できる。 既存システムでPostgreSQLを利用している部分があり、同じインタフェースを持っている。 言語 以下の理由からGoをアプリケーションの実装に利用しています。 全社的に推奨されている言語の中で、部内での利用実績がある。 パフォーマンスが良く、高負荷システムに向いている。 シミュレーション試験について 実施背景 上記のシステムアーキテクチャで一通り開発が完了し、システムの信頼性やパフォーマンスが担保できているかを検証するために障害試験や各モジュールの負荷試験を行いました。 ただ、システム負荷や生成される配信情報はキャンペーン設定、実際の商品在庫データの変動に依存する部分が多く、より安定したリリースを実現するためには本番相当の設定での検証が必要でした。 そこで、本番相当の環境を構築し実際のZOZOTOWNの基盤データを連携することでより本番に近い形で検証するシミュレーション試験を実施しました。 実施するための準備 シミュレーション試験を実施するために以下を準備しました。 本番環境のアクセスログ、データ基盤連携Pub/Subトピックに、試験用のサブスクリプションを追加する。 本番同様のキャンペーンを設定する。 テスト環境に本番相当スペックのインフラを構築する。 データ基盤連携システムは、ZOZOTOWN本体におけるデータベースの差分更新を検知し、その差分データをPub/Subメッセージとしてパブリッシュしています。 リアルタイムマーケティングシステムは、データ基盤連携がトリガーとなり後続の配信処理が動くため、データ基盤システムのPub/Subメッセージをサブスクライブすることで実際の配信処理を再現できます。 インフラに関しては、当初予想された本番環境で必要なスペックのリソースを構築しました。実際に処理を動かしていく中でスペックを調整しました。 リリース時はシミュレーション試験を行なっていた環境に構築されたインフラと同じスペックのものを本番環境に構築しました。 検証項目 シミュレーション試験では以下の項目を検証しました。システムパフォーマンス的な観点に加え、システムが意図した挙動をしているかという点で配信予定数も確認しました。 各種キャンペーンの配信予定数などが予測値と乖離がないこと。 システム全体が負荷に耐えられていること。 SLAを満たしていること。 致命的なバグが発生しないこと。 試験を実施した結果 本番に近い環境で以上の検証項目を確認する中で、実際の運用に役立つ多くの気づきを得ることができました。以下はその中でも特に重要だったポイントです。 データベース負荷トレンドの把握 午前中のキャンペーン配信が集中する時間帯に、システム負荷が高くなる傾向は当初から予測していました。本番相当の環境下での検証により、その傾向が確実なものとして裏付けられました。 以下の画像はデータベースのCPU使用率のグラフですが、特定の時間帯の負荷が高いことを確認できます。 この明確なトレンドをもとに、アイドル時間帯(負荷が低い時間帯)にはAlloyDBの一部読み取りインスタンスを自動で停止する運用を導入しました。これにより、不要なリソースの稼働を抑え、柔軟なリソース管理とコスト削減を実現しています。 特にAlloyDBの柔軟なインスタンス管理機能を活用することで、パフォーマンスを維持しながらも、無駄のない運用が可能となり、クラウドコストの最適化に大きく貢献しました。 BigQueryコストの把握 検証中に、BigQueryの利用コストが予想以上に高いことが判明しました。 特に、アーキテクチャ図の「配信ワークフロー」部分からわかるように、ワークフロー内で参照しているBigQueryのクエリがコストの主因となっていました。 幸いにも、既に運用としてクエリにクエリラベルを付与する仕組みが整備されていたため、これを活用して分析を実施しました。 クエリラベルの情報をもとにクエリごとのスキャン量を可視化することで、特にスキャン量が多くコストに影響しているクエリを特定し改善できました。 監視設定の精度向上 本番相当の負荷をかけることで、より本番運用を考慮した監視アラートの閾値を特定できました。 また、監視が不足しているケースが明らかになりました。 これを受けて、閾値を調整し、より実運用に即した監視体制を構築しました。 データマートのチューニングによるキャンペーン精度の向上 シミュレーション試験を通じて、実際の配信予定数を事前に確認できました。試験結果をもとに、ユーザーごとに最適なキャンペーン訴求が行えるよう、データマート生成ロジックなどのチューニングを実施しました。 この取り組みにより、配信精度の向上と無駄な配信の削減が実現し、より効果的なキャンペーン運用につながりました。 バグの事前発見 開発環境では再現できなかった以下のような本番特有のバグも、本番環境を再現することで発見できました。 BQクエリにおける UPDATE、DELETE、MERGE DML同時実行上限 の超過 該当クエリはMERGE句を利用していましたが、上記DMLステートメントと競合しないWRITE_APPEND方式に変更した。 また、リアルタイムマーケティングシステムと連携する配信システム側でも修正すべき点が見つかり、 本番リリース前にクリティカルな問題を事前に対処できました。 リプレイスの結果 本番相当のシミュレーション試験を事前に実施したことで、大きな問題なくリリースを迎えることができました。 リプレイスした結果、前述した課題は以下のように解決できました。 システム課題 スケーラビリティ メインアプリケーションをCloud Run上に構築したことで、負荷に応じて自動でスケーリングされるようになり、ピーク時でも安定した配信が可能になった。 システムメンテナンス性 リリース作業時のメンテナンスが不要になった。 システム耐障害性 フルマネージドなクラウドサービスを利用しているため障害対応が容易になった。また、AlloyDBのリージョンインスタンスタイプを利用していて高可用性を担保できた。 開発コスト 部内で知見のあるGoを採用したことで、機能改修がスムーズに行えるようになった。 キャンペーン運用管理コスト キャンペーンの情報をデータベースで管理するようにしたため、既存の管理画面からマーケター自身で運用可能になり、運用負荷が軽減された。 また、アーキテクチャの見直しと使用技術の刷新から、配信処理にかかる時間も大きく改善されました。 以下は、とあるキャンペーンの時間毎の配信数のグラフです。縦軸が配信数で横軸が時間、赤線がリプレイス前で青線がリプレイス後です。 グラフからわかる通りリプレイス後の方が短時間で全ての配信を処理できていて、ユーザーに対するより素早い訴求が可能となりました。 まとめ 今回のリアルタイムマーケティングシステムのリプレイスでは、技術的な刷新だけでなく、運用面・パフォーマンス面でも大きな改善を実現できました。 また、リリース前にシミュレーション試験を実施したことで安全にリリースできました。 ZOZOでは、一緒にサービスを作り上げてくれる方を募集中です。ご興味のある方は、以下のリンクからぜひご応募ください。 corp.zozo.com
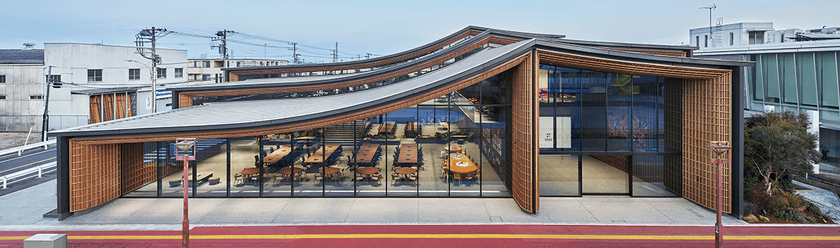
こんにちは、WEAR Webフロントエンドチームでテックリードを務めている冨川( @ssssota )です。2025年9月6日に北海道は札幌市、エア・ウォーターの森にて フロントエンドカンファレンス北海道2025 が開催されました。本記事では、会場の様子や印象に残ったトークについてご紹介します。 フロントエンドカンファレンス北海道とは フロントエンドカンファレンス北海道は、Webフロントエンド領域に関心のあるエンジニアやデザイナーを対象とした技術イベントです。2024年に初開催され、今年で2回目の開催となります。 今回は、台風15号の影響で飛行機が遅延になるなどのハプニングもありましたが、無事に参加できました。 会場の様子 会場は札幌市にあるエア・ウォーターの森で、2024年12月にオープンしたばかりの新しい施設です。 施設中央は吹き抜けになっており、自然光が差し込んでいました。 トークの内容 どのトークも非常に興味深い内容でしたが、そのうち特に印象に残ったトークを紹介します。 「フロントエンドで1,000万件のデータをリアルタイム処理しろですって?😱」WebGL2を活用したGPGPUの世界へ WebGPUを使わず、WebGL2でGPGPUを実現している事例を紹介していました。 発表内では、CPU vs GPUのパフォーマンス比較を実際に行い、CPUが2分かけている処理をGPUが1秒未満で処理するデモを披露していました。CPUが処理している間の2分間は、会場全員で静かに見守るというシュールな光景が広がっていました。 WebGPUがまだ広く普及していない現状において、WebGLを活用したGPGPUの手法が存在することはなんとなく知っていましたが、実際にパフォーマンス比較を見たのは初めてで非常に興味深かったです。 「待たせ上手」なスケルトンスクリーン、そのUXの裏側 スケルトンスクリーンについて、心理学的な視点から解説するLTでした。 ローディングのUIには様々な種類がありますが、スケルトンスクリーンがもたらす心理学的な効果について研究を引用しながら解説していました。 フロントエンドエンジニアとしてUI/UXを学ぶだけではなく、その背景にある心理学的な視点も理解できると、より良いユーザー体験を提供できるのだと感じました。 ES2026 対応:acorn への Explicit Resource Management 構文サポート実装 JavaScriptパーサーのAcornに、 using 構文を実装した際の裏側を紹介していました。 Explicit Resource Managementは、 using というキーワードで変数を宣言することで、変数のスコープを抜ける際に自動でクリーンアップ処理を実行できる仕組みです。 using というキーワードは、現時点で予約語ではないため、変数名や関数名としても使用できてしまいます。そのような曖昧な構文に弱いLLパーサーであるAcornへ using 構文を実装した際の苦労が語られていました。 LLパーサー・LRパーサーの違いや、 using 構文の曖昧さなど、あまり意識したことのなかったパーサーの内部実装について学ぶことができ、非常に興味深かったです。 Viteのプラグインを作ると内部をイメージできるようになる 私もViteプラグインに関する発表をしました。 Viteのプラグインを実際に作るハンズオン(ライブコーディング)を通して、プラグイン作成の簡単さや、ViteがどのようにJavaScript、TypeScriptを処理しているかを確認しました。 ライブコーディングのパートが多い関係で資料は公開していないので、アーカイブの公開をお待ちください。 おわりに 今回のイベントを通して、フロントエンド技術のトレンドや動向について多くの知見を得ることができました。同時に、Webフロントエンドという領域の幅広さと奥深さを改めて実感できました。各発表、登壇、懇親会など非常に刺激的な一日でした。 最後になりますが、このようなイベントを企画・運営してくださったスタッフのみなさま、本当にありがとうございました。 ZOZOでは一緒に働く仲間を募集しています。ご興味のある方は、ぜひ以下のリンクからご応募ください。 corp.zozo.com
ZOZO開発組織の2025年8月分の活動を振り返り、ZOZO TECH BLOGで公開した記事や登壇・掲載情報などをまとめたMonthly Tech Reportをお届けします。 ZOZO TECH BLOG 2025年8月は、前月のMonthly Tech Reportを含む計9本の記事を公開しました。特に次の3記事はとても多くの方に読まれています。 techblog.zozo.com techblog.zozo.com techblog.zozo.com 登壇 Google Cloud Next Tokyo 25 8月5日、6日に東京ビッグサイトにて「 Google Cloud Next Tokyo 25 」が開催され、ZOZOから4名のエンジニアが登壇しました。 ⬜ 8/5(火)14:00 - 14:30 🟥 DAY 1 セッション(D1-APP-04) #ZOZOTOWN の 大規模マーケティング メール配信を支える アーキテクチャ ✉️ https://t.co/camTqrqb0P #CloudRun の 3 つの実行モード(リクエストベース、常時稼働 CPU、ジョブ)を用途に応じて使い分け👍 #GoogleCloudNext 🗼 pic.twitter.com/oRQcpONDAk — Google Cloud Japan (@googlecloud_jp) 2025年7月24日 🩶 8/5(火)16:00 - 16:30 💚 DAY 1 セッション(D1-BFE-01)🧑💻👩💻 予測不能な時代を生き抜く #エンジニア のキャリアについて考える ✏️ https://t.co/87VMwQw8br 多様なバック グラウンドを持つエンジニアが、自身のキャリア形成における思想や具体的な道のりをお話しします! #GoogleCloudNext 🗼 pic.twitter.com/0HBQIrhrbk — Google Cloud Japan (@googlecloud_jp) 2025年7月23日 ⬜ 8/6(水)13:00 - 13:30 🟨 DAY 2 セッション(D2-AIML-10) ファッション コーディネート アプリ「WEAR」における、 #VertexAI Vector Search を利用したレコメンド機能の開発・運用で得られたノウハウの紹介 👗 https://t.co/rJi9Dl6GSE #ZOZO #GoogleCloudNext 🗼 pic.twitter.com/K3piy3n94q — Google Cloud Japan (@googlecloud_jp) 2025年7月23日 イオン×ZOZO×『Web配信の技術』著者が語るパフォーマンスチューニング:60分で掴む劇的改善術 8月26日に開催された「 イオン×ZOZO×『Web配信の技術』著者が語るパフォーマンスチューニング:60分で掴む劇的改善術 」に、EC基盤開発本部の秋田が登壇しました。 🗣️ 本日 12:00 開催! 『イオン×ZOZO×『Web配信の技術』著者が語るパフォーマンスチューニング:60分で掴む劇的改善術』にSRE部の秋田が「ZOZOTOWNリプレイスで得たパフォーマンス改善の知見と、チームで継続するための取り組み」というタイトルで登壇します! https://t.co/4jnAv8ZuIa #aeon_tech_hub — ZOZO Developers (@zozotech) 2025年8月26日 掲載 oceanα これからの海を持続可能に共創していくダイバーと海の総合サイト「 oceanα 」に、ZOZOMETRYのオーダーウエットスーツ製作に関する記事が掲載されました。 oceana.ne.jp corp.zozo.com Girls Meet STEM 8月18日に、「 Girls Meet STEM 」プログラムの一環として、中高生女子を対象とした体験イベント「 ZOZOTOWNとWEARを支える技術と働き方をのぞいてみよう! 」を開催しました。 techblog.zozo.com このイベントの内容が複数メディアに掲載されました。 www.nikkei.com www.nikkei.com www.sankei.com ソフトバンクニュース Webメディア「 ソフトバンクニュース 」に、生産プラットフォーム開発本部本部長の鈴木が取材された記事が掲載されました。サステナビリティ観点でのMade by ZOZOの強みや「キヤスクwith ZOZO」など周辺の取り組みが紹介されています。 www.softbank.jp 以上、2025年8月のZOZOの活動報告でした! ZOZOでは、一緒にサービスを作り上げてくれる方を募集中です。ご興味のある方は、以下のリンクからぜひご応募ください。 corp.zozo.com
.entry .entry-content ul > li > ul { display: none; } .entry-content td { text-align: left; } こんにちは。技術戦略部 CTOブロックの ikkou です。ZOZOでは毎年、独自の新卒研修を実施していますが、今年は日本CTO協会の新卒エンジニア合同研修にも参加することにしました。参加は任意として、興味を持つ研修を自身で選択できるようにしました。遠方に住んでいるメンバーも参加できるように調整の上、ZOZOからは通算11名の新卒エンジニアが参加しました。本記事では参加者によるレポートをお伝えします。 日本CTO協会 新卒エンジニア合同研修とは 第1回:Google Cloud のスペシャリストと学ぶ! BigQuery & Gemini(講師:グーグル・クラウド・ジャパン合同会社) Google Cloud プロダクトの魅力に触れる 生成 AI をテーマとしたグループワーク 懇親会での交流 まとめ 第2回:CTOから新卒に向けた講話(講師:日本CTO協会 / 株式会社LayerX) / 生成AI時代のソフトウェアエンジニアとしての働き方の期待値(株式会社Progate) AI時代に必要なキャッチアップとアウトプット 解像度を高め、目の前の仕事を明文化する 投資家的にキャリアを考える 最初の10年:時間と健康をレバレッジにする 環境が人をつくる 最後に 第3回:AWS 初学者向け合同研修 / AWS JumpStart (講師:アマゾンウェブサービスジャパン合同会社) Day0 事前課題「Cloud Practitioner Essentials」でウォームアップ Day1 講義とハンズオン Day2 アーキテクチャ検討会 最後に 第4回:サーバー解体研修(講師:GMOペパボ株式会社) 解体の前に いよいよサーバ解体! 1. 物理サーバのほとんどの部品は工具なしで解体可能 2. メモリには刺す順番が重要 3. 物理サーバにおける冗長化の仕組み まとめ 第5回:日本CTO協会ISUCON新卒研修*1 + 解説(株式会社PR TIMES) ISUCONとは、 研修の目的 実際にISUCONをやってみて 1. ログからボトルネックを見つける nginxのアクセスログを見る プロセスごとのCPU負荷を確認する スロークエリログを有効化 2. チューニング インデックスの追加 LIMIT句の付与 静的ファイルはnginxに任せる 懇親会の交流 まとめ 第6回:生成AIに関する講義(講師: 日本マイクロソフト株式会社) AIネイティブ時代 エンジニアの未来 Azure AI Foundryとモデルの進化 まとめ おわりに 日本CTO協会 新卒エンジニア合同研修とは 本合同研修は、日本CTO協会の会員企業の新卒エンジニアを対象とした取り組みで、初回の2024年度に続き今回が2年目です。ZOZOは初年度に参加していなかったので、今回が初参加となります。 cto-a.org 研修は全6回で構成され、すべてオフラインで実施されました。 研修内容 講師 第1回:Google Cloud のスペシャリストと学ぶ! BigQuery & Gemini グーグル・クラウド・ジャパン合同会社 第2回:CTOから新卒に向けた講話 / 生成AI時代のソフトウェアエンジニアとしての働き方の期待値 日本CTO協会 / 株式会社LayerX、株式会社Progate 第3回:AWS 初学者向け合同研修 / AWS JumpStart アマゾンウェブサービスジャパン合同会社 第4回:サーバー解体研修 GMOペパボ株式会社 第5回:日本CTO協会ISUCON新卒研修 *1 + 解説 株式会社PR TIMES 第6回:生成AIに関する講義 日本マイクロソフト株式会社 各回の内容について3名からのレポートをお届けします! 第1回:Google Cloud のスペシャリストと学ぶ! BigQuery & Gemini(講師:グーグル・クラウド・ジャパン合同会社) 第1回は坂元が担当いたします! 今回は、渋谷ストリームにある Google さんのオフィスにお邪魔して、研修に参加してきました。 この研修回では大きく分けて講義・グループワーク・懇親会の3つに分けて、各パートをご紹介いたします! Google Cloud プロダクトの魅力に触れる 研修の前半では、Google Cloud が提供するさまざまなプロダクトの講義がありました。中でも特に印象的だったのが「 BigQuery 」と「 NotebookLM 」に関するセッションです。 普段、弊社でも BigQuery を使ってデータ分析や開発を行っていますが、正直なところこれまでは「高速で使いやすい分析基盤」という、少しふんわりとしたイメージしか持っていませんでした。しかし、今回の研修を通じて、BigQuery の内部構造の仕組み(Borg による実行、Colossus でのストレージ管理、Jupiter によるネットワーク制御など)を学び、弊社含め多くの企業が採用している理由がはっきりと見えてきました。 さらに印象的だったのが、他の Google サービスとの高い親和性です。例えば、Gemini in BigQuery を使うことで、自然言語で質問するだけで自動的に SQL クエリを生成してくれる機能があります。そこから Google Chat とつなげることで、BigQuery を直接開かなくてもデータにアクセスできる仕組みが実現できるという話もあり、そんな未来的な活用例に、純粋にワクワクしました! そして、個人的に一番「すぐに使えそう!」と感じたのが「NotebookLM」のセッションです。NotebookLM は、資料や会議内容などをアップロードしておくと、そこから要約やアイデア出しまでしてくれます。このサービスは、日々大量の情報をキャッチアップする新卒の立場にとって本当にありがたい存在です。しかも、アップロードする資料に基づいて推論してくれるため、自身の業務ドメインに特化したような回答を得ることができるのです。 ここで重要なのが、プロンプトの工夫です。今回の講義では、実務でもすぐに使えるプロンプト改善のポイントを5つ教わりました。 詳細かつ明確な指示を出す - 具体的な情報を提供し、期待する回答の方向性を明確に 役割を与える - 例「あなたは優秀なデータサイエンティストです」 “Don't”よりも“Do”を使う -「しないで」ではなく「する」と指示する 回答できない場合の代替案を提示する - 例「わからない場合は、関連する情報を提供してください」 繰り返し試行してフィードバックを与える - 一度で正解を求めず、やり取りを重ねる意識を持つ このポイントを意識してプロンプトを作ってみたところ、 より想定していた回答に近いアウトプットが返ってきて、次の日の業務からさっそく活かすことができました。 普段、社内のツールをなんとなく使ってしまうこともありましたが、今回の研修を通して「なぜこのツールを使うのか」「どう活用すればもっと便利になるのか」という、日々の業務ではなかなか得られない知識を深めることができました。その結果、業務の理解や活用スキルの底上げにもつながり、実際の仕事にもすぐに役立てることができました。 生成 AI をテーマとしたグループワーク 研修の後半では、10人弱のグループに分かれて「 新卒研修期間、またその後に直面するであろう業務の課題に対し、生成 AI をどのように役立てられるか 」というテーマでグループディスカッションが行われました。私のチームでは、新卒ならではの悩み(例:ドキュメントが未整備、情報が属人化している、AI 利用ポリシーが曖昧)に対して、以下のようなアイデアが出ました。 NotebookLM に関連情報をアップロードし、キャッチアップを効率化 ドキュメントだけでなく、会議音声やメモもアップロード MCP 経由での情報提供 退職者に聞くような感覚で情報を引き出すことで、属人化の解消にもなる AI 利用ポリシーを監視するようなエージェントの設置 同じ新卒という立場からこそ、業務の中での小さな悩みや課題を共有し合うことができた時間でした。最後には他チームの発表もあり、「確かにそんな課題もあるな」「こんなふうに AI を活用する視点があるのか」といった新たな気づきがあり、すごく参加者の皆が近くに感じられて楽しかったです。また、「新卒だからこそ、生成 AI と一緒にできることがある」という前向きな議論が多く、頼もしい仲間の存在を感じることができました。 懇親会での交流 研修の締めくくりには、懇親会が行われました。本研修では、毎回最後に懇親会が設けられており、普段なかなか話す機会のない他の新卒メンバーや、開催企業の社員の方々と交流できます。今回は、Google Cloud の社員の方々とお話しする機会があり、普段の業務や Google Cloud のプロダクトの活用方法について、ざっくばらんにお話しできました。特に、懇親会で開催されたクイズ大会では、Google Cloud に関する知識を深めるとともに、他の新卒メンバーとの親睦も深めることができました。ありがたいことに、クイズ大会では入賞でき、「Google Cloud ではじめる実践データエンジニアリング入門」という書籍をいただくことができました! まとめ 今回の研修を通じて、Google Cloud のプロダクトの魅力や生成 AI の活用方法について深く学ぶことができました。明日から生かせるような実践的なお話も多く、研修後すぐに業務に活かし、さらに学びを深められるきっかけになりました! 第2回:CTOから新卒に向けた講話(講師:日本CTO協会 / 株式会社LayerX) / 生成AI時代のソフトウェアエンジニアとしての働き方の期待値(株式会社Progate) 第2回は三山が担当いたします! 今回はProgate CTOの島津真人さんによる「 AI時代の新卒エンジニアに必要な変化と学習 」と、LayerX代表取締役CTOの松本勇気さんによる「 キャリアの考え方、フォロワーシップ 」についての貴重なお話を伺うことができました。CTOの方々から直接お話が聞ける機会は滅多にないことなので、とても楽しみでした。 前半は島津さんによる「AI時代の新卒エンジニアに必要な変化と学習」についての講義をしていただきました。特に印象に残ったのは、AI時代におけるエンジニアの実践として、以下の2点でした。 キャッチアップとアウトプットを循環させること 解像度を高め、仕事を明文化すること AI時代に必要なキャッチアップとアウトプット AIは日進月歩で進化しており、私たちも継続的にアップデートを重ねる必要があります。ここで重要になるのが キャッチアップとアウトプット です。現在はAIが台頭し始めたばかりで、AIの活用法に明確な答えは見つかっていません。AIに仕事が代替される可能性を懸念する声も少なくありませんが、島津さんは「AIを使ってみないことには、活用されるイメージも、代替されるイメージも湧いてこない」とおっしゃっていました。確かに、AIの基本的な使い方は理解していても、それが自分の仕事に対して十分に活用できているかは疑問でした。そのため、まずはAIを積極的に使っていくことが重要だと感じました。 島津さんが強調されていたのは、 キャッチアップとアウトプットの循環 を作ることです。 自分で試行錯誤を重ねて局所最適を積み重ねる。 得られた知見をチームや組織、コミュニティに共有していく。 このサイクルを高速に回し、AIに関する知識を継続的にアップデートしていくことが大切だということでした。このサイクルを意識して業務でもどんどんAIを使い、活用法をチームに還元していきたいと思いました! 解像度を高め、目の前の仕事を明文化する 業務でAIを使っていると、回答の質がプロンプトの質に大きく依存していることを実感します。期待から外れた回答が返ってくる背景には、往々にして 「自分の理解が浅い」または「表現が曖昧」 という問題が潜んでいます。これに対して島津さんは、 「自分の仕事を文章に起こせるほどに明確に理解すること」 が重要だとおっしゃっていました。 私自身も業務でChatGPTを使用する機会が多いのですが、複数の受け取り方ができるような曖昧な表現をした時は、確かに期待した回答が得られません。こうした場面では決まって、タスクに対する理解度が低く、全体像は捉えているものの具体的な部分の理解が浅い状態にありました。だからこそ 前提・制約・期待する結果を言語化する 用語を揃える 曖昧さを排除する といった「解像度を上げるプロセス」そのものがAIを正しく使いこなす力につながると感じました。タスクをやり始めるとわからないことだらけですが、曖昧な部分を極力無くし詳細な説明がいつでもできるようなレベルまで解像度を高くすることを意識して業務に取り組んで行きます! 研修の後半では、LayerX CTOの松本さんによる「キャリアの考え方とフォロワーシップ」についての講義が行われました。 急速な技術革新や働き方の変化が続く中で、キャリアに不安を抱く新卒の方も多いはずです。私自身、3年後・5年後はおろか、1年後さえどうなっているのか想像がつきません。ここでは、 後悔のないキャリアを築くための 3 つのポイント を整理して共有します。 投資家的にキャリアを考える 松本さんは、後悔しないキャリアを築くための鍵として 「投資家の視点を持つこと」 を挙げられました。投資家は自身の資産を元手にリスクを取り、将来のリターンを狙い資産を増やしていきます。キャリアの世界での “資産” は、 信頼・信用、知識・経験、スキル(技術力/マネジメント力) など。これらを元手に、やりたい方向へ効率よく投資し、リターンを最大化する——それが「投資家的に考えるキャリア」です。 「信頼やスキルの量によって任される仕事の大きさが変わる」という実感は、多くの人がうなずけるはずです。一方で、新卒の私たちはまだこの資産を十分に持っていません。では、何を元手にすればよいのでしょうか。 最初の10年:時間と健康をレバレッジにする 私たちは資産が乏しいように見えて、実は 「時間」と「健康」 という、誰もが喉から手が出るほど欲しい資産を持っています。家庭を持つ前の20〜30代は、もっとも自由に時間を使え、もっとも動ける時期です。だからこそ、この10年をフル投資期間として、将来の資産(信頼・知識・スキル)へ大胆に投資していくことが重要です。 具体的には 小さなプロジェクトでも締切と品質を徹底し、信頼を積み上げる 登壇や記事執筆で学びを発信し、知識と信用を広げる 少し背伸びしたタスクを引き受け、成功すれば実績、失敗しても経験を資産化する 行動にはリスクが伴いますが、 行動 → 学習 → 振り返り のサイクルを短く回すほど、同じ成果をより小さなリスクで得られるようになります。時間と健康というレバレッジを効かせ、投資を続けていきます。 環境が人をつくる 「人は周囲の5人の平均である」という言葉があります。私自身、所属するコミュニティの価値観や考え方に大きく影響を受け、それが今の自分を形作っていると感じます。松本さんは、 意思の力に頼るより、環境を選ぶこと の重要性を強調していました。努力する仲間の姿を見れば自然と自分も頑張れますし、同僚の昇進に悔しさを覚えることも「健全な嫉妬」として行動エネルギーに変えられます。自らも行動し発信することで、周囲にポジティブな刺激を与える存在になることもできます。 最後に 今回は島津さんと松本さんのお二方からお話を聞く機会を設けて頂きましたが、お二方とも口を揃えて仰っていたことは行動と学習のサイクルを回すことの重要性です。当たり前なこのサイクルを高い質で回せるようになるためにもまずはたくさん行動して経験を積み重ねていきたいと思いました。このような貴重な機会をいただき、本当にありがとうございました! 第3回:AWS 初学者向け合同研修 / AWS JumpStart (講師:アマゾンウェブサービスジャパン合同会社) 第3回も三山が担当いたします! 今回はアマゾンウェブサービスジャパン合同会社による「 AWS JumpStart 」でした。 本研修はAWSの初心者から中級者を対象としたもので、オンラインで2日間かけて開催されました。研修内容としてはAWSサービスを利用してアプリを作成するために必要となる知識を講義とハンズオン形式で学び、その後チームに分かれて与えられた要件に沿うアーキテクチャを検討するグループワークを行いました。最後はチームごとにアーキテクチャをテーマとした発表会を行いました。 Day0 事前課題「Cloud Practitioner Essentials」でウォームアップ 今回の研修は初学者を対象としていますが、2日目にはチームでのアーキテクチャ検討会もありますし、知識不足で何もできないのではないか? と少し不安でした。しかし、公式が提供するAWS Cloud Practitioner Essentialsを事前に学べる機会が用意されていました。「サービス名は知ってるけど、どこでどんな目的で使われてるのかわからない」状態だった私も、しっかりと土台を築けました! このAWS Cloud Practitioner Essentialsは、資格を取得のための講座ですが、具体例がとてもわかりやすくここでAWSへの理解がかなり深まったと思っています。誰でも受けられる講座なので、AWSをこれから学びたい! と思っている初心者の方はまずこの講座を受けることをお勧めします! Day1 講義とハンズオン 初日は、事前学習で得た知識の振り返りとチームを組んでTODOアプリをクラウド上に構築するハンズオンを行いました。ハンズオンは2、3人でチームを組みモブプロ形式で進めていきました。 モブプロは、画面操作をするドライバーと口頭で指示を出すナビゲーターに分かれて行いました。オンラインでの作業であったため、ドライバー役の時は「インスタンスタイプをt2.microにします」と実況しました。ナビゲーター役の時も「右側上部のオレンジのボタン「インスタンスを起動」を押してください」というように具体的な指示を出すことで、スムーズに進めることができました。 ハンズオンでは、ALBを使ったマルチAZ方式で可用性を担保した構成をECS/Fargateで構築しました。そして、データベースもAurora MySQLのWriter/Reader構成で構築しました。これによりアプリ、DBの双方で冗長性が確保され、片方のAZで障害が発生してもサービスを継続できるようになります。 モブプロで作成したアプリケーションのインフラ構成図(JumpStart2025-スケーラブルハンズオン(モブプロver)より引用 今回は実際に障害が起こった際、どのようにして自動で復旧するのかを確認するために、Writerを停止してその挙動を観察しました。Writerがダウンしてもフェイルオーバーが発生し、自動で復旧することが確認でき、冗長構成にする大切さを学びました! サービスを運用するにあたり、冗長性や可用性はとても大切な要素になります。それがどのように実現されているのかを手を動かしながら学ぶことで理解が深まりました! Day2 アーキテクチャ検討会 2日目は1日目の振り返りを行ったあと、1チーム5、6人のグループに分かれアーキテクチャ検討会を行いました。グループワークでは、" 全員退職した EC チームの代打 "という設定で、半年後にローンチ予定のECサイトのAWS構成を今日中に提案するという、ドラマ仕立ての課題に取り組みました。 弊社もECサイトを運営しているため、このテーマをもらった時は全体像を想像しやすかったです。実際に取り組んでみると、さまざまな課題が与えられました。「アクセス数が増加する時間帯に応じてスケールさせる」「ユーザーの購買ログをためてAIに解析させる」「利用者が10倍に増えても同じ構成で捌ききれるのか」など、運用を考慮した課題ばかりでした。アーキテクチャ設計の難しさを感じました。 しかし、チームメイトと協力し意見を出し合いながら進められた点は面白く、自分では考えていなかった気づきを共有してくれてとても充実した1日を過ごせたと思っています。改善の余地はあるものの、チームとして納得できるアーキテクチャ構成図を作成できました! 2日目に作成したアーキテクチャ構成図 最後に 始まる前はAWSの構成図を見ただけでは何がどうなっているのか全くわからない状態でした。しかし今では、アプリを運用するための基本的なサービスの役割を理解し、何を行っているかがわかるレベルまで来られたと感じています。今回はGUI操作でWebアプリの環境構築を体験しました。AWSにはCloudFormationやCDKといったIaC(Infrastructure as Code)と呼ばれるコードベースで環境構築する手法もあります。次はコードデプロイに挑戦してみたいと思います! 2日間かけてAWSのサービスについてゼロから学び、非常に充実した研修となりました。今後のAWS構成の考え方や、知識を広げていく方法も掴めた実感があります。今回の学びを業務や個人の成長に活かしていきたいと思いました! 第4回:サーバー解体研修(講師:GMOペパボ株式会社) 第4回も坂元が担当いたします! 今回は、GMOペパボさんのオフィスにお邪魔して、「 サーバ解体研修 」に参加してきました。普段はクラウドや仮想環境上で開発することが多い私にとって、物理サーバに直接触れて解体するということが初めてということで、人一倍ワクワクしながら向かいました。 解体の前に 実際に解体する前に、まずはサーバの構成に関する座学が行われました。どんな部品があり、それぞれの部品がどのような役割を果たしているのかを事前に学んでおくことで、サーバ解体体験の解像度が一気に高まります。 いよいよサーバ解体! 講義の後にいよいよ研修のメインイベントであるサーバ解体に進みます。1チーム十数人に分かれて大きなテーブルを囲み、用意された実機のサーバを順に分解していきます。 最初は「壊してしまわないか」と不安に思いながら慎重に触れていたのですが、徐々に慣れてくると、「ここって外れるのか?」という探究心が勝り、夢中になって作業していました。普段ソフトウェアを扱うことが多いからこそ、こうしてハードウェアに直接触れられる貴重さを改めて実感しました。解体を通じて、多くの気づきや驚きがありましたが、その中でも特に印象的だった3点を紹介します。 1. 物理サーバのほとんどの部品は工具なしで解体可能 一番初めに驚いたのは、物理サーバは工具なしで解体できるということです。てっきりネジをドライバーで外していくものだと思っていたので、最初に大きな衝撃を受けました。このような設計になっているのは、サーバを常時稼働させながらパーツを交換するためです。いわゆるホットスワップに対応しており、停止時間を最小限に抑えたメンテナンスが可能になります。また、サーバ内部のパーツにはオレンジ色と青色のハンドルがあり、色によって交換の可否が区別されていました。 オレンジ:ホットスワップ対応(稼働中に交換可能)。 青:コールドスワップ対応(シャットダウンが必要)。 ホットスワップのパーツはサーバラックから下ろさずとも交換できるという話を伺い、メンテナンスを考慮した合理的な設計になっていることに感動しました。 2. メモリには刺す順番が重要 2点目は、メモリには“推奨の挿入順序”が存在するということです。順番が異なってもサーバは動作しますが、システム側での最適な構成が取れず、パフォーマンスに影響を及ぼす可能性があります。クラウドでは、抽象化されたリソースとして最適化が自動的に行われるため、普段はあまり意識することがありません。しかし今回の研修を通じて、物理サーバならではの視点や工夫を知り、それらがハードウェアレベルで実現されていることを体感しました。 3. 物理サーバにおける冗長化の仕組み クラウドにも冗長構成がありますが、もちろん物理サーバにも冗長性を担保する構成が存在します。例えば、RAID構成によるディスクの冗長化や電源ユニットの二重化など、障害耐性を高める工夫が随所に見受けられました。先述したホットスワップの考え方ともつながり、物理インフラでも「止めないこと」がいかに重視されているか、そしてどのように実現されているかを学ぶことができました。また、物理サーバとクラウドを比較することで、オンプレ構成のことはもちろんクラウドの構成に関してもより理解が深まりました。 自チームの解体作業が終わった後は、他テーブルの様子も見学しました。解体しているサーバはテーブルごとに異なり、NVIDIA製のGPUが搭載された高性能なサーバを解体しているテーブルもありました! そのテーブルでは、GPUの仕組みや冷却構造に注目しながら、より技術的な会話が交わされていて、一段と白熱した議論が交わされていました。 そして最後に、解体したサーバを再び元に戻して終了となります。「どこに何があったっけ…?」と苦戦しながらも、チームで協力して慎重に戻していきました。 ※写真は撮り忘れてしまいましたが、無事に元の状態に戻せました! まとめ 今回のサーバ解体研修を通じて、単にパーツ構成を学ぶだけではなく、なぜこのような構造になっているのか、どんな工夫が詰め込まれているのかを学ぶことができました。また、オンプレの知識を得たことでクラウドへの理解もさらに深まりました。今まで、物理サーバはどこか遠く難しいものだと敬遠してしまっていた部分がありましたが、今回手で触れることによってより身近な存在に変わったと実感しています。今回の学びを今後の業務にも活かしていきたいと思います! 第5回:日本CTO協会ISUCON新卒研修*1 + 解説(株式会社PR TIMES) 第5回はもみじこと皇映が担当いたします! 今回は、東京都千駄ヶ谷のピクシブ本社にお邪魔しました! 研修のテーマは「 ISUCON新卒研修 」になります! ISUCONとは、 ISUCONとは、「 Iikanjini Speed Up Contest(いい感じにスピードアップコンテスト) 」の略で、お題となるWebサービスを決められたレギュレーションの中で限界まで高速化を図るチューニングバトルです! ISUCONはLINEヤフー社が主催しており、毎年開催されています。ISUCONでは3人以下のチームで参加でき、優勝賞金はなんと100万円です! これはモチベが上がりますね! それだけでなく、ISUCONで学んだ知識は、実際の現場にも通じるものがたくさんあるため、実践的なスキルを習得するとても良い機会です! 研修の目的 今回の研修では2人または3人のチームで、ISUCONとほぼ同様なWebサービスをお題に、チーム対抗でスコアを競い合うISUCON研修を実施しました! また研修の目的としては、ISUCONを体験するだけでなく、チームでの活動を通して、実際の業務で「周りの力を活用し、問題解決する」力を養い、自分起点で質問をして協力を得る姿勢を習得することです! 実際にISUCONをやってみて 私は3人チームでWebチューニングを行いました! 競技時間は10:00〜18:00でしたが、あっという間に時間が過ぎ、正直時間があればもっとできたなと悔しかったです! Webのチューニングの基本はシンプルです、「計測して、いちばん時間を食っている部分から手を入れる」これにつきます! ここでは、今回のお題で私たちが取り組んだ具体的なステップと最適化手法について紹介します! 1. ログからボトルネックを見つける nginxのアクセスログを見る 今回のフロントエンドにはnginxが入っているので、まずは access.log を解析しました。ログにリクエストのメソッドやURI、応答時間を出力することで、どのリクエストに時間を要しているのかを調査しました。解析ツール(alpなど)を使うことにより、重いリクエストをすぐに抽出できます。 プロセスごとのCPU負荷を確認する htop や top でCPU使用率を見ることで、時間がかかっているプロセスを見つけることができます。今回のお題ではMySQLでCPUを多く使用しており、DBにボトルネックがあることを発見できました。 スロークエリログを有効化 スロークエリログを有効化し、すべてのクエリをロギングすることにより、最も時間のかかるクエリを調べることができます。また、EXPLAINでインデックス利用状況をチェックすることにより、「インデックスが適切に使われているか」や「filesortが発生していないか」を確認できます。 2. チューニング 調査から得られた情報をもとに、具体的なチューニングを行なっていきます。今回のお題では以下のようなチューニングを行いスコアを向上させました。 インデックスの追加 今回のお題では、複合インデックスを追加することで、filesortがなくなり大幅に高速化できました。 LIMIT句の付与 アプリケーション側でLIMIT句により取得数の制限をかけることにより、ネットワーク転送やメモリ使用量を削減し、高速化に繋げることができました。 静的ファイルはnginxに任せる 画像やCSS、JavaScriptはアプリケーションサーバーを経由せず、nginxの try_files や expires ディレクティブで直接返すことにより、アプリケーションのリソースを必要な処理に集中でき、高速化が図れました。 懇親会の交流 懇談会では、高得点をとったチームの人にスコアアップの秘訣を聞きました! 限られた時間の中でいかに「調査→改善」のサイクルを回すことができるかが重要であると感じました! 研修に参加した人の中には、早くも冬に行われるISUCON本番に向けて、準備を始める人もいました!(私も参加する予定です!) まとめ 今回のISUCON新卒研修では、ISUCONというお題を通して、チームで課題解決に向かう力と共に、適切な技術を用いて課題を解決することの大切さを学びました。これは実際の業務にも強く生きる内容であると感じました。また、ISUCONという競技の楽しさ・技術の面白さを改めて強く感じる研修でした! 今回研修に参加された皆さん、研修を支えてくださった皆様、本当に貴重な体験と良い学びをありがとうございました! 第6回:生成AIに関する講義(講師: 日本マイクロソフト株式会社) 第6回ももみじこと皇映が担当いたします! 今回は、品川の日本マイクロソフト株式会社にお邪魔しました! 研修のテーマは「生成AIに関する講義」になります! 講義は柳原( @yanashin18618 )さんに行なっていただきました! AIネイティブ時代 今年で創立50周年を迎えるMicrosoftでは、2025年を「AIエージェント元年」と位置づけているほど、今年は新たな時代を迎える1年です。Microsoftが目指すAIの世界は、自然言語を使い、私たちがPCやサービスを直感的に操作する未来を描いています。 Microsoftが推進するAIのキーワードは、この2つです。 Copilot(コパイロット)– ユーザーの相棒のように作業をサポートするAI Agent(エージェント)– 人間が委任したタスクを自律的に完遂するAI どちらの言葉も近年私たちの日常でも聞くようになりましたね! GitHub Copilotは既に世界で1,500万人以上が利用し、Microsoft Copilotは2,000万〜3,000万人のアクティブユーザーを抱えているそうです! 人間とAIが伴走したり、AIに自律的に任せたりすることが当たり前の社会が形成されていきそうです! エンジニアの未来 今回の講義でとても興味深かったのが「Agent」のお話です! 私はこれまでも仕事においてAIを活用していました。これまでのAIは人間の“助手”として動く存在でしたが、Agentはそれを一歩超えて、まるで有能な同僚のように仕事を丸ごと任せるように仕事をすべてAIによって完了させることができます! さらに面白いのは「マルチエージェント」の仕組みです! 複数のエージェントが会話しながら協力し、コードの生成から運用・監視まで一貫して行う、まるで人間のチームメンバー同士のやり取りがAIに置き換わるイメージです! これからは、エンジニアの役割は単純なコーディングから「AIに何を任せるかを設計する側」へとシフトしつつあります! Azure AI Foundryとモデルの進化 MicrosoftはこのAI革命を支える基盤として、Azure上で動作する「Azure AI Foundry」を構築しています。Azure AI Foundryとは、Azureが提供する統合型AIプラットフォームです。開発者・企業が生成AIアプリやエージェントを安全かつスケーラブルに構築できるように設計されたサービスになります。Azure AI Foundryでは、OpenAIのGPTシリーズ(GPT-3、GPT-4、GPT-4o)やMicrosoft独自のLLM/SLMを自由に組み合わせ、AIエージェントの作成からモデルのチューニングまで一気通貫で行うことができます! このようなサービスが提供されている中で、「どんなエージェントを作るのか」「何を任せたいのか」を明確に描ける人こそが、これからのエンジニアリング世界で強くなると感じました! AIネイティブな時代において 「AIが作業をすべてやってくれるなら、人間は何をする?」 という疑問があります。 今回の講義を通して、 人間の役割は「手を動かすこと」から「考えること・創ること」へシフトしていく と強く感じました。AIに仕事を委任できるからこそ、人間は「なぜそれをやるのか」「どんな価値を生むのか」という上流の設計・判断・クリエイティブな発想がより重要になります。 エンジニアはコードを書く“職人”ではなく、AIを使いこなす“ディレクター”のような立ち位置に進化していくのではないでしょうか! まとめ 今回の研修では生成AIの活用について学びました! AIネイティブ時代のエンジニアとして生成AIを活用し、AIと共存していく未来がすぐそこまできています。AIに何をさせるか、何をして欲しいのかを明確に伝えることによりAIの性能を引き出すことが求められます。今後はAIの性能を最大限引き出しながら、効率的に開発し、よりクリエイティブなエンジニアになれるように頑張ります! おわりに 参加した新卒エンジニアは各研修を通じて、さまざまな内容を幅広く学べたのではないでしょうか。また、オフライン開催ということで、他社の同期との交流もあり、きっと刺激を受けることもあったと考えています。これらの経験は、今後の業務においても大いに役立つことでしょう。みんなの活躍を期待しています! ZOZOでは、新卒・中途に限らず、一緒にサービスを作り上げてくれる方を募集中です。ご興味ある方は以下のリンクからぜひご応募ください。 corp.zozo.com corp.zozo.com *1 : 「ISUCON」は、LINEヤフー株式会社の商標または登録商標です。
.table-of-contents ul ul { display: none; } はじめに こんにちは、SRE部カート決済SREブロックの伊藤( @_itito_ )です。普段はZOZOTOWNのカート決済機能のリプレイス・運用・保守に携わっています。また、データベース(以下DB)領域でのテックリードを担っており、DBREとしてDB周りの運用・保守・構築に関わっています。 弊社のDBRE活動については、以前次の記事で紹介しました。 techblog.zozo.com この活動の中で、DBのテーブル定義の設計レビューを行っています。この運用にAWSのBedrockを用いて自動化を組み込んだ取り組みを紹介します。 目次 はじめに 目次 背景・課題 DB設計レビューの課題 レビュー工数と「トイル化」の問題 開発者によるガイドライン遵守度のばらつき DBレビューフローの変更方針 自動レビューBotの設計・実装 技術選定 作成するレビューシステムとSlackとの連携 Confluenceとの連携方法 LLMモデルの選定 AWS Bedrockのナレッジベースの使用是非 システムの全体構成 AWSリソースについて Bedrockアクセス用のInference Profileについて Lambda上で動かすPythonコードの実装について 重複実行対策 Bedrockの呼び出しコード Slackのイベントに応じた処理の実装 Bedrockに渡すプロンプト リリース後の効果 レビュー時の指摘件数の減少 リリース後のコスト まとめと展望 背景・課題 弊社では2020年頃から、ZOZOTOWNに関わるDBのテーブルや列の「追加・更新・削除」を行う際には、設計レビューを必須としています。これは、主に以下の3つの目的で開始されました。 リプレイスが進むZOZOTOWNのDB周りの全体像把握のため 秘密情報の含まれたデータがマスク化などのアクセス制御が行われずにリリースされることを防ぐため 開発ガイドラインに沿った設計をしているかを確認するため 秘密情報の取扱いルールについては以下で紹介しています。 techblog.zozo.com また、弊社では各プラットフォームごとに開発ガイドラインが定められています。例えば以前本ブログで紹介されたものとしてはバッチの開発ガイドラインがあります。 techblog.zozo.com DBの設計においては、命名規約やテーブル設計時の注意点、データ保護のためのルールなどが定められています。 DB設計レビューの課題 上記のような目的で行われているDB設計レビューですが、運用する中でいくつか課題を抱えていました。 レビュー工数と「トイル化」の問題 レビュー依頼は週に多くても10件程度と、件数自体は多くありません。しかし、そのほとんどが「開発ガイドラインに沿っているか」を確認する定型的な作業であり、一種のトイル(手作業による非効率な繰り返し作業)となっていました。 開発者によるガイドライン遵守度のばらつき ZOZOTOWNの開発には、多くの社員やパートナー会社のエンジニアが関わっています。これは私たちの強みである一方、開発ガイドラインへの遵守度に大きく差が生まれる側面もありました。ガイドラインにまだ慣れていないメンバーの設計では、基本的な指摘が多くなるケースもあり、レビューにかかる工数・負荷の増加につながっていました。 DBレビューフローの変更方針 これまでDB設計レビューを次のようなフローで行っていました。 開発者がConfluence上に設計書を作成 Slackの専用チャンネルにてワークフローからレビュー依頼を投稿 DBREメンバーがレビューを実施 設計レビュー承認後に実装を開始 このフローの改善を考える中で、根本から仕組みを見直すことも検討しました。例えば、設計書をMarkdownでGit管理してプルリクエストでレビューするフローへと切り替えるとCopilotによる自動レビューなどが可能になります。 しかしER図のような視覚的な表現が難しくなる点や、大きな変更はかえって開発者側の負担を増やしてしまう懸念がありました。 そこで、既存フローの途中でBotによる自動レビューを組み込むことにしました。 開発者がConfluence上に設計書を作成 Slackの専用チャンネルにてワークフローからレビュー依頼を投稿 BotがConfluenceからテーブル構造を読み取り、レビューを実施 DBREメンバーがBotで判断できなかった部分を追加でレビュー 設計レビュー承認後に実装を開始 実際に手順3の自動レビューの流れを、実装後のキャプチャを用いて図示したのが次の画像です。 この仕組みを構築するにあたって使用した技術や実装の詳細について、次の章で紹介します。 自動レビューBotの設計・実装 技術選定 システムを構築するにあたり、必要となる技術の調査および選定をしました。 作成するレビューシステムとSlackとの連携 上記のレビューフローを実現するためにはSlack上での投稿をトリガーとして処理を開始し、結果をSlack上に投稿する仕組みが必要です。 このためにSlack Appを作成し、Botとして動作させることにしました。開発にはSlack公式のPython向けフレームワークである「 Slack Bolt for Python 」を使用することにしました。 Slack Boltではリクエスト署名の検証といったセキュリティ対策がデフォルトで有効になっている点も大きなメリットでした。 Confluenceとの連携方法 Botがレビューをするには、まずConfluenceから設計書の内容の取得が必要です。 ここでポイントとなったのが、弊社が利用しているConfluenceがServer版である点です。Cloud版であればMCPのようなモダンな連携方法も考えられますが、Server版では利用できません。さらに、将来的にはCloud版へ移行するという話もあったため、移行後も動き続ける仕組みが必要でした。 この状況から、技術選定では以下の2点を重視しました。 Cloud版とServer版の両方に対応できること 最低限の機能として、テーブル設計の記載されたページが取得できること この方針のもと、最終的にConfluence REST APIを直接利用するシンプルな方法を選びました。実装には、両方のバージョンをサポートしているライブラリ「 Atlassian Python API 」を活用しています。 LLMモデルの選定 私たちのインフラはAWSをメインで利用していること、セキュリティの観点からモデルの学習にデータが使われないようオプトアウト設定も可能なことから、実行環境にはAWS Bedrockを選択しました。 Bedrockでは多くのモデルが利用できますが、以下の3つのモデルを候補としました。 Titan Text G1 - Express Claude 3.5 Sonnet Claude 3 Haiku 開発元 Amazon Anthropic Anthropic モデルの位置づけ 速度とコスト効率を重視した汎用モデル 知能、速度、コストのバランスに優れた主力モデル 最速・最軽量・低コストなエントリーモデル 入力トークン 1,000 個あたりの価格 USD 0.000275 USD 0.003 USD 0.00025 出力トークン 1,000 個あたりの価格 USD 0.000825 USD 0.015 USD 0.00125 レビュー精度 × ◯ △ 検証結果 指摘すべき点を見逃した ガイドラインに沿った指摘ができた 一部、誤った指摘があった モデルのレビュー精度を確かめるため、意図的にアンチパターンを含んだテーブル定義と設計ガイドラインを渡し、各モデルにレビューさせてみました。 結果は表の通り、 Anthropic Claude 3.5 Sonnet が最も的確な指摘をしてくれました。価格は3つの中で最も高価ですが、Botの利用頻度は1日数回程度です。そのため、コストは数円から数十円の範囲に収まり、精度の高さを考えれば十分に許容できると判断しました。現在はその後継である最新版のSonnetモデルを利用しています。 AWS Bedrockのナレッジベースの使用是非 Botの回答精度を高めるには、私たちのDB設計用の開発ガイドラインをLLMに伝える必要があります。その方法として、AWS Bedrockの「ナレッジベース」機能の利用を検討しました。 これは、S3などにあるドキュメントを読み込ませるだけで、簡単にRAG(検索拡張生成)を実現できる便利な機能です。 しかし、調査を進めるとコスト面が課題となることがわかりました。ナレッジベースの裏側では、ベクトルデータベースとしてAmazon OpenSearch Serviceが利用されます。これにより、最低でも月数万円の固定費が発生する見込みとなりました。 今回Botに与えたい知識は「開発ガイドライン」の、DB項目のさらに一部だけです。データ量はそこまで多くなく、更新頻度も高くありません。このためだけに常時稼働のデータベースを用意するのは、費用対効果が見合わないと判断しました。 結果として、よりシンプルに 必要なガイドライン情報を、都度プロンプトに直接埋め込む 方式を採用しました。シンプルながら、私たちのユースケースにはこれが最適なアプローチでした。 システムの全体構成 上記を踏まえ、以下のようなアーキテクチャとしました。 Confluenceから取得したデータはそのままだとHTML形式の文字列のため、これをパースして情報を一度まとめてからJSON形式に変換しています。 この変換はレビューの精度を向上させるために行っています。検証の結果、HTMLをそのまま渡すよりも、整形済みのデータを渡すことで、モデルが意図した情報を正確に理解しやすくなりました。 また、パースには当初PythonのライブラリのBeautiful Soupを使用する考えでしたが、自由な構造に対応できるように、ここでもBedrockを使用することとしました。 AWSリソースについて AWSリソースはCloudFormationで管理しており、主に以下のリソースを作成しています。 S3 Bucket ソースコードを格納するためのバケット API Gateway Slackからのリクエストを受け取るためのエンドポイント AWS Lambda Pythonで実装したSlackアプリケーションを実行するためのLambda関数 Secrets Manager 各種トークン情報を安全に管理するためのシークレット Inference Profile Bedrockでモデルを利用する際に使用するプロファイル Bedrockアクセス用のInference Profileについて AWS Bedrockでは、有効化した時点でそのモデルを利用可能となります。ただし、デフォルトの推論プロファイルを使用すると、どのアプリケーション・ユーザーがコストを発生させたのかを追跡できません。これにより、コストの配分や分析が難しくなります。 そのため次のようなコードでコスト配分タグを付与したアプリケーション推論プロファイルを作成して使用することにしました。 Resources : InferenceProfileDBDesignReviewBot : Type : AWS::Bedrock::ApplicationInferenceProfile Properties : InferenceProfileName : !Sub "${AppNameDBDesignReviewBot}-inference-profile" ModelSource : CopyFrom : !Sub "arn:aws:bedrock:ap-northeast-1:${AWS::AccountId}:inference-profile/apac.anthropic.claude-sonnet-4-20250514-v1:0" Tags : - Key : Name Value : !Sub "${AppNameDBDesignReviewBot}-inference-profile" - Key : CostEnv Value : !Ref CostEnv - Key : CostTeam Value : !Ref CostTeam Lambda上で動かすPythonコードの実装について ここからは、このBotを実現しているAWS LambdaのPythonコードについて、ポイントを絞って紹介します。 Pythonと主要ライブラリのバージョン Python : 3.13 atlassian-python-api : 4.0.4 slack_bolt : 1.23.0 重複実行対策 SlackからのリクエストをLambdaで処理する際、注意したいのがタイムアウトによるリトライです。AWS Lambdaのコールドスタートなどで処理に3秒以上かかると、Slackは「応答がない」と判断し、同じリクエストを再送してきます。これにより意図せず処理が重複して実行される可能性があります。 そのため、リトライを表すヘッダーが付与されている場合はSkipすることで重複処理を回避するようにしました。 def lambda_handler (event, context): """ Lambda Functionのハンドラーに設定する関数 """ headers = event.get( "headers" , {}) if "X-Slack-Retry-Reason" in headers: logger.info( "Slackリトライリクエストを無視します" ) return { "statusCode" : 200 , "body" : "" } return slack_request_handler.handle(event, context) Bedrockの呼び出しコード AWSが提供しているBedrockのAPI呼び出しの方法として、「InvokeModel」と「Converse API」の2種類が存在しています。 docs.aws.amazon.com 両者の大きな違いの1つとして、柔軟性の違いがあります。実際にテストコードを基にした例が次の画像です。InvokeModelを使用した場合は、リクエストボディやレスポンスの解析をモデルごとに行う必要があります。 InvokeModelでモデルが異なる場合の実装例 一方、Converse APIを使用するとこれが共通のコードで実装できるようになります。 ConverseAPIでモデルが異なる場合の実装例 LLMの進化は速いため、将来のモデル変更に備えて、柔軟性の高いConverse APIを選択しました。 Slackのイベントに応じた処理の実装 Slackで発生する様々なイベントに応じた処理は、Boltのデコレータを使って実装します。例えば、Botへのメンションをきっかけに入力フォームを開く処理は、以下のコードで実現しています。 @ app.event ( "app_mention" ) def handle_app_mentions (body, say): thread_ts = body.get( "event" , {}).get( "thread_ts" ) or body.get( "event" , {}).get( "ts" ) send_review_request_message(say, thread_ts) def send_review_request_message (say, thread_ts): """ 自動レビューに必要な情報を送信するためのフォームをスレッドに送信します。 """ say( blocks=[ { "type" : "header" , "text" : { "type" : "plain_text" , "text" : "DB設計自動レビュー依頼" , } }, { "type" : "section" , "text" : { "type" : "mrkdwn" , "text" : f "お疲れ様です。DB設計自動レビューBotです。 \n 設計書の自動レビューを行いたい場合、以下を入力して送信ボタンを押してください。 \n\n 利用マニュアル: <{BOT_MANUAL_URL}|{BOT_MANUAL_TITLE}> \n *注意: テンプレートに沿ったConfluenceのURLのみレビュー可能です。* \n " } }, ... 上記コードによって、前述の自動レビューの全体像のこの部分が実行されます。 Slack上でのメッセージの見た目を整え、入力欄やボタンの配置には、Slack公式の Block kit Builder を活用しています。 Bedrockに渡すプロンプト レビュー時に使用するプロンプトは以下のように定義しています。Confluenceから取得した「テーブル設計情報」と、「開発ガイドライン」をこのプロンプト内に動的に埋め込めるようにしました。なお、プロンプトエンジニアリングについての知見がまだ少ない状態での実装のため、あくまで一例としてご覧ください。 prompt_data = f """ あなたはデータベースのテーブル設計の専門家です。 テーブル設計情報と、開発ガイドラインの情報を渡しますのでレビューしてください。 ガイドラインに沿っていない項目に関しては「指摘箇所」として、 注意事項リストに該当する項目の場合は「注意箇所」として、 その他のコメントがあれば「その他」として出力してください。 出力フォーマットは以下の通りです。 ``` 提供されたテーブル設計情報に基づいて、ガイドラインに沿ってレビューを行いました。 ーーーーーーーーーーーーーーーーーーー :rotating_light:指摘箇所:rotating_light: 【1】<指摘対象> ・ 指摘内容: <指摘内容> ・ ガイドラインの対応項目: <ガイドラインの対応項目> ・ 修正案: <修正案> 2. <指摘対象> ... ーーーーーーーーーーーーーーーーーーー :warning:注意箇所:warning: 【1】<注意内容> ・注意理由: <注意理由> 【2】<注意内容> ーーーーーーーーーーーーーーーーーーー :memo:その他:memo: ・ <その他のコメント> ``` 指摘内容がある場合の出力例 ``` :rotating_light:指摘箇所:rotating_light: 【1】テーブル名: Member ・ 指摘内容: テーブル名が単数形になっている ・ ガイドラインの対応項目: テーブルおよびカラムにプレフィックスをつけず、テーブル名は複数形にする(MUST) ・ 修正案: テーブル名をMembersに変更する 【2】カラム名: MemberID ... ``` 指摘内容がない場合の出力例 ``` :rotating_light:指摘箇所:rotating_light: 特に指摘箇所はありませんでした。 ``` テーブル設計情報は次のようにJSON形式で提供されます。 テーブル設計情報: {table_design_json} ガイドラインは以下の通りです。 {BASE_GUIDELINES} {guidelines_by_db_engine} 注意事項リストは以下の通りです。 {WARNING_LIST} 現在弊社でレビュー依頼のあるDBは、「SQL Server」と「MySQL」の2種類が多くを占めていますが、それぞれでガイドラインに違いがあります。そのためSlack上での入力フォームでどちらか選択できるようにし、選択されたDBに応じたガイドラインが使われるようにしています。 また、これまでレビュー時に注意喚起を行なっていた項目なども、注意リストとして定義し、プロンプトへと埋め込むようにしました。例えば秘密情報が含まれたカラムを追加する場合には、運用フローに則って別途対応が必要となるため、そちらの対応を促すようにしています。 ガイドラインや注意リストを渡すだけでもレビューはできますが、それだけでは指示された項目しかチェックできません。そこで、プロンプトの冒頭で「あなたはデータベースのテーブル設計の専門家です」という役割を設定しています。これにより、私たちが明示的に定義していない事柄についても、LLMが持つ知識を活かし、プラスアルファの指摘をしてくれます。 リリース後の効果 レビュー時の指摘件数の減少 リリース前後10件のレビューにおける、レビュアーからの指摘件数を比較した結果が以下のグラフです。 Botにより必要な指摘の約7割が自動で行われるようになり、レビュアーの負荷が軽減されました。 ガイドラインには「ローマ字表記や省略形の英単語は使わず、完全な英単語を使用する」という項目もあり、見落としがちなスペルミスなども自動的に拾われて修正されるなど嬉しい効果もありました。 リリース後のコスト 運用開始後のコストを、以下にまとめました。 レビューBotを動かす環境は、「開発者からのレビュー依頼を受ける環境」と、「Botの改修時に使用する環境」として2環境を用意しています。当初想定していなかった規模の大きなテーブルがレビュー依頼となり、改修とリトライを繰り返したことで最初の2日間は他の日と比べてコストが高くなっています。その後は安定しており、1日あたり数十セント程度のコストで運用できています。 AWSのサービスで見た場合には、次のようになっています。Secrets Managerへの保存によって若干のコストがかかっている他は、ほとんどがBedrockのコストです。 約1か月運用してかかった実際のコストとしては約7.62ドルであり、コストを大きく抑えて運用できました。 まとめと展望 本記事では、長年手動で対応していたDB設計レビューのフローに自動化を組み込んだ事例について紹介しました。 Slackを起点としてPythonのアプリを動かし、Confluenceからテーブル設計情報を読み取り、Bedrockを用いて開発ガイドラインに基づいて自動レビューする仕組みとしています。 今回の仕組みのターゲットは設計書のレビューでしたが、その設計書通りに実装できているかプルリクエストに対してレビューする仕組みなどにも応用は効きそうです。LLMを活用することによる運用負荷軽減を実現するための取り組みは引き続き進めていきたいと思います。 ZOZOでは、一緒にサービスを作り上げてくれる方を募集中です。ご興味のある方は、以下のリンクからぜひご応募ください。 hrmos.co
はじめに こんにちは。Developer Engagementブロックの @wiroha です。8月18日(月)に、ZOZOにて中高生女子を対象とした体験イベント「 ZOZOTOWNとWEARを支える技術と働き方をのぞいてみよう! 」を開催しました。 これは 公益財団法人山田進太郎D&I財団 が実施する「 Girls Meet STEM 」プログラムの一環です。中高生女子がSTEM(科学・技術・工学・数学)分野で働く人やSTEM分野で学ぶ学生、実際の現場に触れることで、将来の可能性を広げる機会を提供することを目的としています。ZOZOではこの活動の意義に共感し昨年より参画しており、今回は2度目の開催です。前回の様子は次のレポート記事をご覧ください。 techblog.zozo.com 今回は約20名の参加者が集まり、オフィスツアー、サービス体験&技術紹介、女性エンジニアとの交流を通じて、ファッションと技術の面白さを体感しました。本記事では、当日の様子をご紹介します。 イベント概要 日時:2025年8月18日(月)13:00~15:30 会場:ZOZO西千葉本社 対象:中学1年生~高校3年生までの戸籍上または性自認が女性の方 定員:20名 www.shinfdn.org オープニング まずは会社紹介や事業紹介により、ZOZOのことを知ってもらう時間を設けました。ZOZOTOWNやWEAR by ZOZO(以下、WEAR)のサービス、計測事業などについて解説することで、この後のサービス体験&技術紹介の内容をより深く理解してもらうことを目指しました。 サービス体験&技術紹介 2つのグループにわかれ、「サービス体験&技術紹介」と「オフィスツアー」を交代で実施しました。「サービス体験&技術紹介」では、ZOZOTOWNのARメイク、ZOZOGLASS、WEARのファッションジャンル診断を体験してもらいました。 AR技術でメイクが施された画面上の自分の顔に驚き、カラフルで見慣れないZOZOGLASSを手に取り笑顔が出るなど、ZOZOの技術を楽しんでいる様子でした。体験した後は各サービスで使用されている技術を紹介し、技術によってファッションが楽しくなることを感じてもらいました。 実際にZOZOGLASSを担当している女性エンジニアからやりがいについて語ってもらったところ、海外チームと一緒に働くことや英語学習の重要性に関心が集まっていました。 オフィスツアー こだわりの社屋である、西千葉本社のオフィスツアーを実施しました。メッセージが込められたアートや遊び心のある会議室、絨毯の模様や色使いの工夫など、ZOZOらしいデザインが施されたオフィス内を案内しました。クイズを交えながらの紹介で、参加者の皆さんも考えながら楽しんでいました。最初は緊張していた参加者も、オフィス内を歩くうちにリラックスできた様子でした。 パネルトーク 次にパネルトークを開催し、新卒1〜2年目の若手エンジニアから話を聞きました。学生時代の経験やエンジニアになろうと思ったきっかけ、中学・高校時代の進路選択などについて語ってもらいました。 年齢の近いエンジニアからの話は身近に感じられたようで、熱心に聞き入っていました。文系からエンジニアになった話や転学科した話もあり、タイミングに合わせて進路やキャリアを考えながら、自らアクションすることの大切さを感じてもらえたのではないでしょうか。 質問会 その後は少人数のグループに分かれて参加者からの質問に答える時間を設け、ZOZOの女性エンジニア6名が一緒にお話ししました。 slido を活用したところ、非常にたくさんの質問が寄せられました。「いつ進路を決めましたか?」「文系や未経験でもエンジニアになれますか?」「取っておいた方がいい資格はありますか?」など、進路や学習に関する質問に対してエンジニアたちが自身の経験を交えながら丁寧に答えました。 お土産 参加者の皆さんに、ZOZOオリジナルグッズなどをお土産としてお渡ししました。イベントの思い出として楽しんでもらえたら嬉しいです。今回の体験時間に入りきらなかったZOZOMATもお渡ししており、自宅で足の3Dサイズ計測を体験してもらえればと思います。 メディア掲載情報 本イベントはメディアからの注目も集め、以下のとおり掲載されました。今後も公開され次第、順次追記していきます。 www.nikkei.com www.sankei.com 最後に 参加者の皆さんからは、次のような感想をいただきました。 このオフィスで働きたいと思えるような素敵な環境が整ったオフィスだった 今日体験した自分に似合うものを探したりするのが楽しかった 文系・理系関係なく挑戦すればできるのかもしれないと思えた 好きなことを仕事にすることは自分のためになると知ることができた 苦手なことや、やらなければならないことに不安を抱く方が多かった中で、交流を通じて自分の興味や得意なことに目を向けるようになっている様子が伺えました。 ZOZOはこれまでもさまざまな女性活躍推進のための活動に取り組んできており、今後もこうした機会を提供していきたいと考えています。本イベントにより中高生女子の皆さんがファッションと技術の面白さを感じ、将来の可能性を広げるきっかけになれば幸いです。
2025/10/29 モジュラモノリスの採用に関する記述を一部修正いたしました。 こんにちは、カート決済部カート決済基盤ブロックの多田と三浦です。 普段はZOZOTOWN内のカート機能や決済機能の開発、保守運用、リプレイスを担当しています。 これまでにカート決済サービスのリプレイスでは在庫データのクラウドリフトやクレジットカード決済の非同期化を実現しています。 techblog.zozo.com techblog.zozo.com 本記事では、ZOZOTOWNにおける「カート投入から注文作成まで」のシステムを、Classic ASPからJavaへ移行した取り組みについてご紹介します。一部機能は既にリリース済みで、現在も段階的な移行を継続中です。 このプロジェクトは、モノリシックなアプリケーションからマイクロサービスアーキテクチャへと段階的に移行する取り組みの一環として進めてきました。その過程で、どこでサービスを分けるべきかという課題に直面しました。安易な分割は機能間の依存を複雑化させる一方で、分割を避けすぎるとモノリスのままとなり、保守性は向上しません。 こうした難しさに向き合う中で、私たちはシステムの責務やドメイン構造を明確にする手段として、イベントストーミングを導入することにしました。 きっかけは、社内で実施された「イベントストーミング会」でした。興味を持ったメンバーが何度か参加するうちに、「自分たちの担当領域のカート投入から注文作成でも試してみよう」という声が自然と上がるようになりました。ちょうど新たなメンバーがチームに加わったタイミングでもあり、ドメイン全体を俯瞰する手段としても有効だと考えました。また、新たな手法に挑戦すること自体がエンジニアとしてのスキル向上につながり、チーム全体で取り組むことはチームビルディングの面でもプラスになると判断しました。 アーキテクチャの選定にあたり、当初はマイクロサービスアーキテクチャの採用を検討していました。しかし、巨大なカート決済システムの複雑性や実装・運用の難易度、開発リソースの制約を踏まえ、拡張性と保守性を両立できる現実的な選択としてモジュラモノリスアーキテクチャを採用しました。 以下では、その判断に至った背景や、実際の取り組み内容、そして得られた気づきについて詳しくご紹介します。 モジュラモノリスを採用した理由 メリット・デメリット比較 イベントストーミング イベントストーミング概要と目的 コンテキスト境界とは イベントストーミングの進め方 1.ブレインストーミングする 2.イベントを時系列に並べる 3.カラーパズルをする 4.コンテキスト境界を定める イベントストーミングをやってみて モジュラモノリスの実装 ZOZOのカート決済基盤のプロジェクト構成 orchestrator モジュールの役割 build.gradleによる依存関係の制御 モジュラモノリスやってみたメリット/デメリット メリット デメリット 今後の展望 まとめ モジュラモノリスを採用した理由 マイクロサービスとの比較検討の結果、私たちがモジュラモノリスを採用した理由をご説明します。 メリット・デメリット比較 マイクロサービス モジュラモノリス メリット スケーラビリティ・弾力性が高い ・ 高負荷なサービスのみスケール可能 テスタビリティが高い ・ 共通ライブラリのアップデート時のテスト範囲が狭い サービス間の処理の引越しがしやすい ・ コードの移動のみで対応可能 ・ インタフェースの変更が不要 デメリット 開発中に変更があった際にサービス間の処理の引越しがしにくい ・ API設計のし直し ・ オーケストレータからのリクエスト修正 ・テスト用モック修正 スケーラビリティ・弾力性が低い ・ 一部モジュールのみの迅速な更新・スケーリングが難しい マイクロサービスは運用面での恩恵が大きい一方で、開発初期の柔軟性や変更対応ではモジュラモノリスが優れていることが分かります。 当初はマイクロサービスへの細分化を進める予定でしたが、検討を進める中で注文コンテキストが想定以上に大きくなりました。特に注文テーブルの責務をどのサービスが担当すべきかという課題に直面しました。 また、データの独立性やトランザクション境界を考慮したマイクロサービスの境界を定めることは困難でした。 そこで、以下の理由からモジュラモノリスを採用する方針に転換しました。 開発スピードと工数の観点 :マイクロサービス化には相応の開発工数が必要だが、案件開発が並行して進行しているという背景を踏まえ、モジュラモノリスなら段階的な移行が可能で、リプレイスのスピードを優先可能。 組織体制との整合性 :マイクロサービスではサービスごとに専任チームが望ましいが、現在のチーム体制では各サービスとチームを1対1で対応させることが難しい状況。 サービス分割の投資対効果 :決済処理など一部機能をマイクロサービス化することも検討した。しかし、利用者がZOZOTOWN内部に限定されることや、専用データベースへの移行が困難なことから、現時点での分割メリットは限定的と判断。 まずはモジュラモノリスとしてコンテキスト境界に基づいたモジュール分割を実施しつつ、今後の組織変更や事業の成長に応じて、段階的なマイクロサービス化も視野に入れた拡張性のある設計方針としました。 イベントストーミング イベントストーミング概要と目的 イベントストーミング(Event Storming)とは、主にソフトウェア開発や業務プロセスの設計で使われるワークショップ手法です。関係者全員が集まり、システムや業務の流れを「イベント(出来事)」を中心に可視化・整理します。 私たちは以下の目的でこの手法を導入しました。 コンテキスト境界を明確にする。 カート/注文フローの全体像を把握し、チーム間で認識を統一する。 ドメイン知識を持つメンバーと新規参入メンバーとの間で知識を共有し、リプレイスを円滑に進める。 コンテキスト境界とは bounded context A description of a boundary (typically a subsystem, or the work of a particular team) within which a particular model is defined and applicable. 境界づけられたコンテキスト(Bounded Context)とは、特定のモデルを定義・適用する範囲を明示的に示したものです。 代表的な境界の例は、サブシステムやチームなどです。 引用: 公式DDD Reference 一方で「コンテキスト境界」は、この境界づけられたコンテキスト同士の境界線や接触部分を指します。それぞれのコンテキストがどこまでの責務を持ち、他のコンテキストとどのように連携するかを定める境界のことです。 例えば、モジュラモノリスでは「モジュール」単位を基本として、マイクロサービスでは「サービス」単位を基本としてコンテキスト境界を設定することが一般的です。ただし、必ずしも1:1対応するわけではなく、ドメインの特性や組織の状況に応じて柔軟に設定されます。 イベントストーミングの進め方 1.ブレインストーミングする 各自、思いつく限りのドメインイベントを付箋にそれぞれ記載する。 重複しても問題なく、まずは記載する。 この段階でイベントに抜けや漏れがあっても気にする必要はありません。後のステップで整理・補完していくため、まずはシステム全体の流れや構造をざっくりと把握することを目的としています。 2.イベントを時系列に並べる 時系列に並べる。 同じイベントを重ねる(可能であれば、重複削除する)。 不足しているイベントがあれば付箋を追加する。 このステップの目的は、システムや業務プロセスの全体的な流れや構造を明確にすることです。 イベントを時系列で整理することで、プロセスの前後関係や依存関係が可視化されます。これにより、関係者全員が同じ視点で全体像を把握できるようになり、抜けや重複、認識のズレなども発見しやすくなります。 3.カラーパズルをする 時系列に並べたイベントの付箋に対して、アクターやコマンド、エンティティなどの情報を追加する。 「アクター」「どのような操作や指示(コマンド)」をきっかけにイベントが発生したのかを色分けした付箋やラベルで整理する。 その時に関わるエンティティやシステムの状態なども併せて記載する。 アクター(Actor) :イベントを引き起こす主体。システムのユーザーや外部サービス、管理者などが該当する。 コマンド(Command) :アクターがシステムに対して行う操作や指示。例として「商品をカートに追加する」「注文を確定する」などの具体的なアクションが含まれる。 エンティティ(Entity) :システム内で管理される情報やオブジェクト。例えば「カート」「注文」「商品」などが該当する。 このステップの目的は、イベント同士の関係性や、業務・システム内での役割分担、データの流れをより明確にすることです。色分けによって視覚的にも分かりやすくなり、複雑なビジネスルールを直感的に理解できるようになります。 4.コンテキスト境界を定める 業務イベントやユースケースの流れをもとに、責任や関心ごとが明確に分かれるポイントで境界を設定する。 既存システムの強い依存(ストアドプロシージャーによるトランザクション管理)がある領域は、現段階では無理に分割せず、将来的な分離を見据えて大きめにまとめる。 頻繁に一緒に変更される機能や連携の強い領域は同じコンテキスト内に収めることで、保守性や開発効率を高める。 最終的に以下のようにコンテキスト境界を定めました。 イベントストーミングをやってみて ワークショップ形式で実施したことで、ドメイン知識を吸収しやすいと感じました。長年カート決済システムに携わってきたメンバーが持つ暗黙知や個人の頭の中にあったビジネスルールを新規参入メンバーを含むチーム全体で共有・明文化できました。また、各メンバーがそれぞれ異なる視点で捉えていたコンテキスト境界を図解することで、具体的な合意形成ができました。抽象的だった「責務の分担」が視覚的に整理され、モジュール設計の方向性について納得感のある議論ができたのは大きな収穫でした。 一方で、オンラインでの開催はどうしても発言者が限られがちで、対面に比べて議論が活発になりにくい印象を受けました。特に複雑なテーマでは、オフラインで1日かけてじっくり議論したほうが、多くの意見を引き出しやすく、全体の理解も進みやすいと感じました。 また、既存システムを題材にした場合、全体像を把握するのに想定以上の時間がかかりました。実際、週1回1時間のペースで進めて約2か月かかりました。なお、この期間はイベントストーミングに専念していたわけではなく、メンバーはそれぞれ他の業務と並行して取り組んでいたため、じっくり時間をかけて進めた形になります。 モジュラモノリスの実装 ZOZOのカート決済基盤のプロジェクト構成 使用している技術スタックは以下の通りです。 言語:Java フレームワーク:Spring Boot ビルドツール:Gradle カート決済基盤で採用しているモジュラモノリスの構成を簡略化すると以下の通りです。 . ┣ module ┃ ┣ orchestrator ┃ ┣ cart ┃ ┣ order ┃ ┣ payment ┃ ┗ {module-name} ┗ core --- 各モジュールで共通して利用するクラスの実装。 各業務機能(注文、カート、決済など)ごとにモジュールを分けており、各モジュールは基本的に単一責務を持つように設計しています。また、coreモジュールには複数のモジュールで共通して使用する要素を集約しています。具体的には、日時や文字列操作などのユーティリティクラスや、各モジュールで共通して利用する処理などです。これにより、コードの重複を避けつつ、再利用性を高めています。 orchestrator モジュールの役割 全体の構成の中でもorchestratorモジュールは、ユースケースの流れを制御する中核的な役割を担っています。複数モジュールにまたがる業務フローを統括する責任を持っているのがorchestratorです。具体的には、cartやorder、paymentといった各モジュールのアプリケーション層に依存し、それらを組み合わせて「1つの業務シナリオ」としてまとめる役割を果たします。orchestratorには以下の利点があります。 各モジュールはあくまで自律的な責務を持つ。 orchestratorが連携のハブとなることでモジュール間の依存が複雑にならない。 最終的にマイクロサービスに分離する際にも、orchestratorの統合・調整機能はそのまま活用でき、BFF(Backend for Frontendアーキテクチャ)と連携しやすい設計になっている。 build.gradleによる依存関係の制御 重要なポイントとして、モノリスに逆戻りしないための依存関係の制御があります。各モジュールには個別のbuild.gradleを配置し、依存対象を明示的に制限しています。以下はorderモジュールのapplicationserviceにおける一例です。 project(':modules:order') { project('applicationservice') { dependencies { implementation project(':core') implementation project(':modules:order:domain') implementation project(':modules:payment:domain') } } } このように記述することで依存関係を制限し、下記のような設計の意図に反する依存を防いでいます。 orderのアプリケーション層はcoreや自身のドメイン層、必要最低限の他モジュール(この場合はpaymentのドメイン)にのみ依存する。 他のcartやorchestratorのようなモジュールへの不要な依存は不可。 モジュラモノリスやってみたメリット/デメリット メリット 開発やテストがしやすい プロセスが1つなので、環境構築やローカル開発がマイクロサービスに比べて非常に簡単。 統合テストも容易で、テストコードのカバレッジを上げやすい。 モジュラモノリスにより柔軟で早い開発サイクルが実現できている。 ストラングラーフィグパターン*でリプレイスを進めているため、新旧システムで二重開発が発生しがちになる。しかし、モジュラモノリスの構造により早いサイクルでリリースができており、二重開発を可能な限り避けながら段階的に移行できている。 *ストラングラーフィグパターンとは、リプレイス対象のシステムの機能を段階的に新しいシステムに置き換えていき、すべての機能を置き換えた後、最終的に移行元のシステムを停止する戦略である。 パフォーマンスやトレーシングが楽 ログやトレースの収集も1つのAPIで完結し一括管理しやすい。 ネットワーク通信が不要なため、レイテンシが最小化される。 命名や実装の差異を早期に発見・統一できる すべてのコードが1つのプロジェクト内にまとまっているため、命名の不一致や実装の重複に気づきやすい。 まとめてリファクタリングできる。 デメリット デプロイ単位が分割できない 全体で1つのアプリケーションとして動作するため、小さな変更でも全体のビルド・テスト・デプロイが必要。 特定モジュールだけを素早く更新する柔軟性には欠ける。 同じValue Object(以下VO)*が複数モジュールに現れる cartモジュールとorderモジュールの両方で商品金額を扱う場合など、同じ構造のVOが各モジュール内で独立して定義される。 モジュール間の直接依存を避ける設計方針で、将来的にマイクロサービスへ切り出す際の独立性を保つための意図的な選択。 *Value Objectとは、値そのものを表現するオブジェクトで、同じ値であれば同一とみなす不変オブジェクトです。例えば、商品金額や日付などがValue Objectにあたります。 今後の展望 モジュラモノリスは1つのアプリケーションとして構築されているため、マイクロサービスと比べてCI実行時のテスト時間が長くなりがちです。 並列にテストを実行することで時間短縮を図っていますが、さらなる短縮と開発体験の向上に向けた取り組みを継続していきます。 また、現在は各モジュールで同じ意味を持つVOであっても、モジュールごとに命名の異なるケースが一部存在しています。 設計上の意図や責務の違いによる分離は尊重しつつも、ドメインモデル間の一貫性を高めるために、こうしたVOの見直しやリファクタリングも進めていく予定です。 今後も、段階的な改善を重ねながら、将来的なマイクロサービス化も視野に入れた柔軟なアーキテクチャを目指していきます。 まとめ 本記事では、カート決済基盤をモジュラモノリスで構築するまでの過程をご紹介しました。複雑でモノリシックなアプリケーションの分割を検討している方がいれば、参考になれば幸いです。今後リプレイスを推進していき注文フローのリプレイス完遂をしていきたいと考えています。 ZOZOでは、一緒にサービスを作り上げてくれる方を募集中です。ご興味のある方は、以下のリンクからぜひご応募ください。 corp.zozo.com
はじめに こんにちは。Developer Engagementブロックの @wiroha です。2025年8月5日、6日に東京ビッグサイトにて Google Cloud Next Tokyo 25 が開催され、ZOZOから4名のエンジニアが登壇しました。 Google Cloud Next Tokyoは、Google Cloudの最新情報や技術を学ぶことができるイベントです。生成AI、クラウド技術、ビジネスと技術の融合など、幅広いトピックが扱われました。セッションの他にハンズオンや展示もあり、参加者は最新の技術に触れることができます。本記事では登壇レポートを中心に、現地の様子も含めて紹介します。 基調講演の会場 登壇レポート ZOZOTOWN の大規模マーケティング メール配信を支えるアーキテクチャ speakerdeck.com MA部の田島 / 富永 からは、メール配信基盤システムのリアーキテクチャの設計と技術選定について説明しました。ワークフローエンジンを用いたバッチ処理をベースとした旧システムから、Cloud Runとジョブキューを用いた設計へと変更したことで、メール配信基盤は配信の優先順位を柔軟に決定しつつ効率的に処理を行えるようになりました。 このセッションは基調講演と同じ会場に設けられたステージにて行われ、これまでに経験がない広い会場での登壇に緊張もありました。しかし、多くの方にご来場いただき、真剣に耳を傾けてくださる姿に大きな励ましをいただきました。会場の熱気と皆さまの関心の高さを肌で感じる、貴重な経験となりました。 特に後半パートでは、Google CloudのサービスであるCloud Run、Pub/Sub、Cloud Tasksをどのような理由で、どのように利用しているかについて具体的に解説し、この部分に興味を持ってくださった方が多いように感じました。MA部での取り組みや設計方針、実装の中で得た経験から、情報や気づきを提供できていたら幸いです。 Ask The Speakerにも多くの方々にご参加いただき、リトライ上限を超えて処理が失敗した場合の対応や、外部メール配信サービス自体で処理が失敗した場合の対応方法など、エンジニアならではの鋭いご質問もお寄せいただきました。Google Cloudサービスやシステム設計、メール配信システムに関心を持つ方々と意見交換ができ、私たちとしても非常に勉強になる時間でした。 ファッション コーディネート アプリ「WEAR」における、Vertex AI Vector Search を利用したレコメンド機能の開発・運用で得られたノウハウの紹介 speakerdeck.com データシステム部MLOpsブロックの 岡本 による発表についてご報告します。 発表では、WEAR by ZOZOの関連コーデレコメンドプロジェクトのベクトル検索の開発にVertex AI Vector Searchを導入し、実装・本番運用で得られた知見をご紹介しました。またレコメンドシステムの全体構成や技術選定の理由もご紹介しました。 当日は多くの聴講者の方にお越しいただきありがとうございました。また発表後の、Ask The Speakerにおいても多くの方からご質問いただきました。これからVertex AI Vector Searchの導入を検討されている方が多い印象で、費用やベクトル検索パラメータのチューニングに関する質問を多くいただきました。時間の都合により発表内で説明できなかった費用やパラメータチューニングの深い話については、発表終了後に公開した当社のテックブログ( WEAR関連コーデレコメンドプロジェクトへのVertex AI Vector Search導入と実践 )で説明しています。発表内容と合わせてご参照ください。 自分がGoogle Cloud Next Tokyoに参加したのは23から数えて3回目であり、Speakerとしての参加は今回が初めてでした。発表を聴くだけでなく、Google Cloudの製品やシステム開発に関する話を参加者の方々とさせていただき、非常に有意義な時間となりました。 予測不能な時代を生き抜くエンジニアのキャリアについて考える wirohaです。多様なバックグラウンドを持つエンジニア3名が集まった、キャリアに関するパネルトークにパネリストとして登壇しました。席は立ち見が出るほどの満員で、関心の多さを感じました。キャリア形成の軸は何か、新しい技術や知識を習得するための工夫はあるか、これまでに予測不能な事態をどう乗り越えてきたかといったテーマについてお話ししました。 パネルトークの登壇ははじめてでとても緊張しましたが、Ask The Speakerの際に「柔軟なキャリアチェンジをする姿に励まされた」といった感想をもらい安心しました。他にも初学者のキャリアの積み方について他のパネリストとともにディスカッションをするなど、さまざまな視点も得られて良い経験になりました。 会場レポート 引き続きwirohaから、Expoエリアの様子を紹介します。次のマップを見るとわかるとおり、ExpoにはGoogle Cloudの技術を紹介するブースや、Expertに相談できるブース、コミュニティ・スポンサーによるブースなど多様なコンテンツが揃っていました。 組み立てたブロック作品をGeminiが評価しスコアを競うゲームや、Google I/O 2025で発表されていたバーチャル試着サービスなど、Googleの技術を直接体験し解説を聞けるのは楽しくて豪華でした。中でも存在感があったのは、AIバスケットボールコーチです。ここでは本物のゴールが設置されており、シュートを打つと自分のフォームが分析・スコア化されて改善のアドバイスを受けることができます。 特別な機器を身につけることなくカメラの映像分析でアドバイスを受けられるのは手軽で、AIがより生活に浸透していく可能性を感じました。 ExpoエリアはブースだけではなくオープンステージやDeveloper Stageがあり、そちらでも発表が行われていました。事前にチェックして計画を立てておいた方が、見逃しがなくまわれて良さそうでした。 おわりに 今回ZOZOからは登壇者以外にも多数のエンジニアが参加し、セッションを聴講していました。各セッションのアーカイブ動画は8月後半に公開予定とのことです。自分の登壇に意識が向いていて見逃してしまったセッションもあるので、公開を楽しみにしたいと思います。 ZOZOでは、カンファレンスから情報をキャッチアップしつつ、一緒にサービスを作り上げてくれる方を募集中です。ご興味のある方は、以下のリンクからぜひご応募ください。 corp.zozo.com
.table-of-contents ul ul { display: none; } はじめに こんにちは。データサイエンス部検索グロースブロックの伊澤です。私は、2025年7月13日から17日までイタリア・パドヴァで開催されたSIGIR 2025(Special Interest Group on Information Retrieval)に現地参加してきました。本記事では、基調講演やワークショップ、各セッションにおいて特に興味深かったトピックをいくつか取り上げてご紹介します。 SIGIR 2025 セッション会場の様子 はじめに SIGIR 2025とは 主な研究動向 開催地と会場 パドヴァについて 会場施設 基調講演 初日: BM25 and All That - A Look Back 2日目: Digital Health 3日目: Please meet AI, our dear new colleague セッションレポート Progressive Refinement of E-commerce Search Ranking Based on Short-Term Activities of the Buyer 感想 Towards Improving Image Quality in Second-Hand Marketplaces with LLMs 感想 From Keywords to Concepts: A Late Interaction Approach to Semantic Product Search on IKEA.com 感想 Optimizing Compound Retrieval Systems 感想・考察 Practical Secondary Stack Optimization on Search Pages: A Lightweight Contextual Bandit Approach 感想 まとめ SIGIR 2025とは SIGIR(Special Interest Group on Information Retrieval) はACM(米国計算機学会)の情報検索特別研究グループが主催する、情報検索分野において最も権威ある国際会議です。1963年の開始以来、検索およびその他の情報アクセス技術の分野における研究、開発、教育の発展を牽引してきました。 第48回となる今回は2025年7月13日〜17日の5日間、イタリアのパドヴァで開催されました。パドヴァはヴェネチア・マルコポーロ国際空港からバスで約1時間の距離にあり、会議の前後や合間でヴェネチアまで足を運んだ参加者もいたそうです。 本会議は、論文発表、ポスターセッション、チュートリアル、ワークショップなど多様なプログラムで構成され、世界中から1000人を超える研究者や開発者が参加しました。 sigir2025.dei.unipd.it 主な研究動向 今回は239件のFull Papers、107件のShort Papersをはじめ、Industrial PapersやDemo Papersなど多数の研究成果が発表されました。 特に注目されたのは、生成AIと情報検索技術の融合領域です。RAG(Retrieval-Augmented Generation)、Generative Retrieval、Conversational Search、LLMを用いた評価といったトピックに関心が集中しており、関連するチュートリアルやワークショップが多数開催されました。これは、情報検索分野における生成技術の本格的な活用が進んでいることを示す重要な動向といえます。 論文発表セッションの構成としては、Search & Reranking、LLM Evaluation、Conversational Searchから企業での応用事例まで、理論研究から実用化まで幅広いテーマが扱われました。参加者は各時間帯で並行して行われるセッションから関心のある内容を自由に選んで聴講できる形式でした。 sigir2025.dei.unipd.it 開催地と会場 開催地のパドヴァは中世・ルネサンス美術が豊富に残る歴史ある街 パドヴァについて 開催地のパドヴァは、中世・ルネサンス美術が豊富に残る歴史ある街です。古い建物が多く立ち並ぶ街並みの中で、随所に壁画アートを見ることができました。また、ガリレオ・ガリレイが教鞭を執ったことでも知られるパドバ大学の所在地でもあります。市街地には、世界遺産に登録されているスクロヴェーニ礼拝堂があり、その壁画で特に有名です。 本会議のウェルカム・レセプションは中心街のPiazza della Fruttaで開催され、それに先立って隣接するラジョーネ宮殿でのガイドツアーも実施されました。 Piazza della Fruttaて開催されたウェルカムレセプションの様子 会場施設 会場は2022年4月に開館したPadova Congress Centerで、中心地から徒歩で20分ほどの距離にあります。 参加者は各時間帯で関心のあるセッションを選択し、会場内の各ホールや会議室で聴講する形式となっていました。チュートリアル、ポスターセッション、ワークショップも併行して開催され、ランチタイムを含めて活発な議論と知識交換が行われていました。 また、ウェルカム・レセプション、学生向けイベント、ソーシャル・ディナーなど多彩なネットワーキングイベントが開催され、参加者間の積極的な交流が促進されていました。 SIGIR2025の会場のPadova Congress Center ランチタイムの会場の様子 基調講演 基調講演は、メインカンファレンス期間中の7月14日から16日まで各日の冒頭で実施されました。 初日: BM25 and All That - A Look Back BM25の開発者であるStephen Robertson氏が、55年にわたる情報検索分野の発展を自身の経験とともに振り返りました。1960年代後半の手計算や電卓を用いた研究スタイル、手紙でのやりとりといった黎明期のエピソードからは、当時の研究環境の厳しさと研究者の情熱が伝わってきました。BM25誕生に至る道のりや、現在でも機械学習において強力な特徴量として活用されている事実など、AI時代の現在にも通じる普遍的価値を再認識させる貴重な講演でした。 2日目: Digital Health Georgetown大学のOphir Frieder氏による講演が行われました。世界的に深刻化する医療人材不足に対して、AIを活用することで医療従事者を補完し、より効率的かつ精度の高い医療判断が可能になるという展望が語られました。EHR(電子健康記録)を活用した癌スクリーニングや、メンタルヘルスの早期検知など、実用的なAI医療応用の例が数多く紹介されました。同時に、AIの限界や倫理的な課題にも言及があり、「AIは医療従事者の代替ではなく、あくまで補完的存在である」というメッセージが印象に残りました。 3日目: Please meet AI, our dear new colleague 3日目は、Darmstadt工科大学のIryna Gurevych教授が、科学研究とAIの協働可能性をテーマに講演しました。AIによる論文執筆や実験自動化といった事例が紹介される一方で、実装上の課題や倫理的懸念も強調され、人間とAIが補完し合う協働の重要性が語られました。特に、AIを単なるツールとしてではなく、「協働者」として捉える視点で、今後の科学研究のあり方に深い示唆を与える内容でした。 セッションレポート 論文発表セッションやワークショップで聴講したトピックをいくつかピックアップします。 Progressive Refinement of E-commerce Search Ranking Based on Short-Term Activities of the Buyer sigir2025.dei.unipd.it eBayによる発表で、Eコマースの検索結果をユーザーの直近行動に合わせて段階的に最適化する手法を提案しています。従来のパーソナライズ手法は、長期的なユーザープロファイルに依存する傾向があり、大量の履歴データを必要とする上に、セッション内で購買意図が変化する場合には対応が困難でした。本研究では、最近の1〜5件のクリックといった短期的なユーザー行動に着目し、それを特徴量として取り入れることで、軽量かつ柔軟なランキング改善を実現しています。 提案手法では、3段階のコンテキスト化アプローチにより構成されています。1段階目のHeuristic Autoregressive Contextualizationでは、検索結果の商品とユーザーが過去にクリックした商品の類似度を、テキストベースまたはeBertモデルによる埋め込みベースの指標として算出します。 以下の表に各指標の概要をまとめています。 手法 概要 Last Click(テキスト) 最後のクリック商品タイトルと現在の検索結果の商品タイトル間のNormalized Compression Distance (NCD)を計算 Last Click(埋め込み) eBay独自開発のeBertモデルによる埋め込みを利用し、最後のクリック商品と現在の検索結果の埋め込みベクトル間のコサイン類似度を計算 Last 5 Clicks(テキスト) 過去5回のクリック商品タイトルを連結したものと現在の検索結果の商品タイトル間のNCDを計算 Last 5 Clicks(埋め込み) 過去5回のクリック商品タイトルと現在の検索結果の商品タイトルの埋め込み類似度の平均を計算 2段階目のIntent-Aware Contextualizationでは、検索クエリと過去のクリック履歴の関連性を評価し、最も検索意図に近いクリック商品を選定した上で、その商品と検索結果の商品との類似度を特徴量として追加します。これにより、検索意図と無関係な過去の行動がノイズになる問題を緩和します。 3段階目のSequential Attention Contextualizationでは、クリック履歴を時系列的に捉え、TransformerやPerceiverを用いたシーケンスモデルから得られた埋め込み表現と検索結果とのコサイン類似度を特徴量とします。これにより、ユーザー行動の変化や文脈をより精緻に捉えることが可能になります。 実験では、各手法を段階的に追加した際のMean Reciprocal Rank(MRR)を確認しています。オフライン評価において、Heuristic Autoregressive Contextualizationのうち「Last Click(埋め込み)」特徴量により1.84%の改善、Intent-Aware Contextualizationの特徴量の追加でさらに1.08%。Sequential Attention Contextualizationの特徴量の追加でさらに1.01%の改善が見られました。eBayにおけるA/Bテストでは「Last Click(テキスト)」の特徴量によって1.30%改善、テキストベースのIntent-Aware Contextualizationの特徴量の追加でさらに0.96%の改善を示しました。 感想 本研究で特に印象的だったのは、長期履歴に依存せず短期的コンテキストのみで高い検索精度向上を実現している点です。さらに、テキストよりも埋め込みベースの特徴量が一貫して高い性能を示しており、意味的類似性の捉え方の重要性が再認識されました。 シンプルなヒューリスティック手法から始めて段階的に高度な手法へ拡張するアプローチは、実運用を見据えた実用的な設計であると感じました。A/Bテストの結果ではテキストベースの手法でも一定の性能向上が確認されていることから、埋め込みを扱っていないEコマースシステムも導入しやすいものであると思いました。 Towards Improving Image Quality in Second-Hand Marketplaces with LLMs sigir2025.dei.unipd.it 本研究では、二次流通マーケットプレイスにおける商品広告画像の品質を自動で評価する手法として、Multimodal Large Language Models(MLLMs)の活用が提案されました。 高品質な商品画像は、ユーザーの信頼形成や購買意欲に大きな影響を与えることが知られています。特にZ世代では画像品質の低さが離脱要因になり得ることが、18名の社内ユーザーを対象とした調査から明らかになっています。従来の画像評価手法、たとえばCNNベースのアプローチは、解釈性に乏しく、教師データの収集にも多大なコストがかかるという課題がありました。 本研究では、MLLMsに対してZero-shotプロンプトを用い、商品画像の品質を1〜5のスケールでスコアリングさせるというシンプルかつ効果的な方法を検証しています。評価には、オンラインユーザー調査により929名からスコアが付与された581枚の画像データが使用されました。 モデルの評価指標としては、ユーザー評価との整合性を測るために、Percent Agreement(PA)、Weighted Kappa(WK)、およびピアソンの相関係数が用いられました。プロンプトの影響を評価した結果、スコア基準を明示的に指示するGuided Promptの方が、汎用的な指示のみを与えるGeneric Promptよりも、ユーザー評価との一致度が高いことが示されました。 さらに注目すべきは、ファインチューニングを施した軽量モデル「Nova Lite」が、大規模なモデル(Claude 3.5 SonnetやNova Pro)を上回る性能を発揮した点です。これは、モデルのサイズよりも適切なタスク適応が性能向上に寄与することを示唆しており、コスト効率の高いアプローチとして実用性の高さがうかがえます。 感想 弊社でも、ZOZOTOWNの検索結果画面においてサムネイル画像の違いがユーザーエンゲージメントに与える影響について研究を進めています。本研究で提案されたMLLMによる画像クオリティ評価やヒーロー画像の自動選定といったユースケースには強い関心を抱きました。 www.jstage.jst.go.jp 特に、ファインチューニングされたNova Liteが大規模なモデルの性能を上回った結果は印象的であり、小規模なモデルであっても適切なタスク設計と調整により、大規模モデルに匹敵する性能が実現可能であることを示しています。推論コストを抑えながら実用性を確保できる点も、プロダクション導入を見据えた際に大きな利点だと感じました。 From Keywords to Concepts: A Late Interaction Approach to Semantic Product Search on IKEA.com sigir2025.dei.unipd.it この発表は、IKEA Retailによるセマンティック検索システム導入の事例紹介です。従来のキーワードベースの検索では、「modern desk with cable management」や「sofa with storage for small apartments」といった複雑な自然言語クエリに対して十分に対応ができないという課題があります。この課題に対し、IKEAはLate Interactionベースの検索アーキテクチャを導入し、検索精度の改善を実現しました。 本研究ではColBERTに見られるようなLate Interactionモデルを採用し、RetrievalとRerankingをEnd-to-Endで統合してリアルタイムでのトークンレベルのスコアリングを実現しています。 検索エンジンにはPLAID(Performance-optimized Late Interaction Driver)を活用しており、IKEAの3万点以上ある商品に対して30ms以下のレイテンシでの検索を可能にしています。 学習データには、約3万点のIKEA商品に対し、LLMを用いて多様な視点から自動生成した約100万件の検索クエリが使用されています。ネガティブサンプルの生成の際にはBGEモデルを活用し、意味的には類似しているが異なるカテゴリの商品を抽出します。具体的には、コサイン類似度に基づいてランキングを行い、k位以降でカテゴリが異なる商品を選択することで、意味的に近いが誤解を招くようなペア(p−)を設定します。そして、コントラスト学習によって、p+よりp−の関連性スコアが低くなるようにモデルを学習させています。 また、セマンティック検索における課題として「関連性スコアの境界が曖昧で、クエリごとに最適な閾値が異なる」点が挙げられます。検索クエリによっても関連性スコアの分布は異なり、従来の固定的な閾値では検索クエリごとに結果数がバラバラになってしまいます。この課題に対し、本研究では確率的かつ適応的に閾値を設定する手法を導入しています。具体的には、商品ランキングの前後の商品間のスコアの差分の平均と分散からZスコアを計算し、急激なスコア変化点(Zスコアが閾値を下回る地点)をカットオフとみなすアプローチです。候補が複数ある場合には、相対的なスコア変化率が一定以上となる位置をカットオフとします。 本システムの評価については、アメリカのIKEA.comにてlong tailクエリを対象にオンラインA/Bテストを行いました。従来のテキストベースの検索(Boolean検索)と比較して商品クリック率が3.1%増加、コンバージョン率が1.96%増加、カート追加数が2.18%増加する結果となりました。 感想 本研究は、複雑な自然言語クエリへの対応やLLMを活用したクエリ生成、さらにはクエリごとに動的に最適な閾値を設定する仕組みなど、実用的なセマンティック検索システムの好例として非常に参考になります。弊社でもベクトル検索の導入を検討しており、特に「固定閾値に依存しない動的カットオフ」の考え方は非常に有用だと感じました。 techblog.zozo.com 一方でZOZOTOWNのように商品点数が桁違いに多い場合は、計算コストやインデックスサイズ、カテゴリごとの閾値調整といったスケーラビリティ上の課題が想定されます。今後さらなるスケーラビリティ対応に関する技術的な知見が共有されることにも期待しています。 Optimizing Compound Retrieval Systems sigir2025.dei.unipd.it Google DeepMindとRadboud大学による研究で、従来の検索システム設計の主流であったカスケード型検索システムに代わる新しいフレームワーク「Compound Retrieval System」を提案しています。 従来のカスケード型検索では、まずBM25のような軽量なモデルで初期ランキングを生成し、上位K件に対して高性能だが計算コストの高いモデル(例:LLM)を段階的に適用することで、コストと性能のバランスを図る設計が一般的です。一方、この構造では、予測対象と予測利用の制約が以下のように固定的であり、予測モデルのコスト効率性や有用性を柔軟に活用する機会を制限しているという課題があります。 予測対象の制約: モデルの予測は「前段階モデルの上位K件の文書に対してのみ」行う 予測利用の制約: 予測されたスコアは「同じ上位K件の再ランキングにのみ」使用する 本研究では、こうした制約を取り払い、モデルの精度やコスト特性に応じて「どの文書(または文書ペア)にどのモデルを適用し、どのようにスコアを統合するか」を最適に設計できるフレームワーク「Compound Retrieval System」を提案しています。このフレームワークにより、軽量なモデルによる最初のランキングに対して、LLMなどのポイントワイズモデルやペアワイズモデル(PRP)をどのドキュメントに適用し、それらの予測をどのように統合するかを最適化します。 具体的には以下のような仕組みです。 軽量モデル$M_0$(e.g. BM25)での初期ランキング$R_0$を作成 $R_0$に対し、どのドキュメントまたはドキュメントのペアに何の予測モデルを使うかを決める選択ポリシー$π$を学習 選択ポリシー$π$により選ばれた予測対象とするかどうかのフラグ$s1$、$s2$に対して、それぞれポイントワイズモデル$M_1$、ペアワイズモデル$M_2$を実行 スコア統合関数$f$により、$M_1$、$M_2$の予測結果を統合して最終的なランキングスコアを算出 $f$で算出されたスコアに基づきドキュメントをソートして最終的なランキング$R*$を作成 出典: Oosterhuis et al., Optimizing Compound Retrieval Systems, SIGIR 2025 Figure 1 選択ポリシー$π$とスコア統合関数$f$は、モデルのランキング性能とコスト(e.g. LLMの呼び出し回数)の線形結合の損失関数の最適化によって獲得します。 $$ \mathcal{L}{\mathrm{comp}}(f, \pi) = \alpha \mathcal{L}_{\mathrm{ranking}}(\pi, f) + (1 - \alpha) \mathcal{L}{\mathrm{cost}}(\pi). $$ $L_{\text{ranking}}$:ランキング精度(例:nDCG)に関する損失 $L_{\text{cost}}$:LLM予測の取得コスト(予測回数)に関する損失 $\alpha$:モデルのランキング性能とコストの重み(トレードオフ) 本研究内では、選択ポリシー$π$とスコア統合関数$f$は、上記の損失関数を最適化するポイントワイズ用とPRP用の2つのニューラルネットワークの学習を通じて獲得しています。勾配を選択ポリシー$π$やスコア統合関数$f$に伝搬させることで最適化しています。最適化手法にはAdamaxを採用しています。 推論時は、得られたπを使ったベルヌーイサンプリングでsのパターンを複数生成し、検証データに対して最小のロスを実現する確定的なポリシーを用います。 TREC-DLデータセットを使用した実験では、BM25で取得した上位1000件の文書を再ランキングするタスクでnDCG@Kを評価しています。 実験の結果、従来のカスケード型検索でのLLMを用いたPRPのモデルと比べて、提案手法が同等あるいはそれ以上のランキング精度を、10分の1のLLM呼び出し回数に抑えた上で達成しました。 感想・考察 スタンダードとされてきたカスケード型検索に代わり、柔軟な検索システム構築の可能性を提示した非常に興味深い研究です。特に印象的だったのは、効率性を重視した設計でありながら、最大性能においても従来手法を上回る精度を実現している点です。 Rerankingにおけるモデルの組み合わせや、どの予測を取得するかといった選択を動的に最適化することで、単一モデルの限界を超える性能を引き出せることが示されており、非常に示唆に富んでいます。 LLMの検索応用において注目される「効率と効果のトレードオフ」という課題に対して、本研究はそのバランスをより良く実現する手法として、大きなインパクトを与える可能性があると感じました。 Practical Secondary Stack Optimization on Search Pages: A Lightweight Contextual Bandit Approach 本研究は、SIGIR2025のワークショップのセッションであるWorkshop on eCommerce (ECOM25)において、Walmart Global Techによって発表されたものです。Eコマースの検索ページにおいて検索結果と併せて表示されるレコメンドモジュール(Secondary Stack)の選択をContextual Multi-Armed Banditにより最適化する手法を提案しています。 Secondary Stackとは、検索結果の下部などに表示される、ユーザーの購買履歴に基づいたパーソナライズされた商品や、カスタマーレビューで高評価を得た商品群などを示すレコメンドモジュールを指します。従来、Walmartではビジネスルールに基づいてスタックの種類を決定しており、検索クエリやユーザー属性などのコンテキストは考慮されていないことや、ユーザーのエンゲージメントパターンも時間とともに変化する可能性のあることが課題とされていました。 本研究では、この問題をContextual Multi-Armed Bandit(文脈付き多腕バンディット)として定式化しています。コンテキストとしては、検索クエリや利用プラットフォーム、絞り込み条件、会員ステータスなど複数の要素を階層的に管理する「Context Tree」を構築します。 図のようにContext Treeの各ノードには、スタックごとのクリック数や非クリック数といったエンゲージメント統計情報が記録され、上位ノードは下位ノードの情報を包含します。このContext Treeは、葉ノードから親ノードへと再帰的に情報を集約するボトムアップ手法で構築されます。 出典: Song et al,. Practical Secondary Stack Optimization on Search Pages: A Lightweight Contextual Bandit Approach Figure 2 実運用を踏まえ、Context Treeは日次バッチ処理により更新されます。前日までの統計情報と当日のユーザー行動を、それぞれ割引係数λを用いて重み付けし、統合することで新たなContext Treeを生成します。 コンテキストが増えるとコンテキストごとのデータ数が少なくなり過学習のリスクが高まります。この課題に対しては、初期段階で全スタックをランダムに表示してユーザーエンゲージメント情報を収集し、どのコンテキストが予測精度を高めるかを評価することで、Secondary Stackの効果に影響する重要なコンテキストのみを事前に選択する方法を提案しています。 本手法のアーキテクチャは次の図のようになっています。 出典: Song et al,. Practical Secondary Stack Optimization on Search Pages: A Lightweight Contextual Bandit Approach Figure 3 オフラインで構築されたContext Treeを基に、オンライン環境ではThompson Samplingを用いて「探索」と「活用」のバランスをとりながらスタックを選択します。各コンテキストに十分なデータが蓄積されるまでは、上位のコンテキストノードに基づいてスタックを選択する設計となっています。また、セッション内での一貫性を保つために、ハッシュベースのシードによるスタック固定も導入されています。 Walmart本番環境でのA/Bテストでは、検索経由での商品カート追加率が0.3%、Secondary Stack経由では11.1%の向上が確認されており、実運用における高い効果が示されました。 感想 本研究は、複雑な機械学習モデルに頼らず、Multi-Armed Banditを活用することで、低コストかつ低遅延な本番運用を実現している点が実践的で印象的でした。特に、導入初期のデータ収集フェーズと本格運用フェーズを分け、リスクを抑えながら効果を検証している設計は、実務での導入において非常に参考になります。 まとめ 今回のSIGIR 2025では、生成AIと情報検索の融合がいよいよ本格化し、検索技術の未来に向けた大きな転換点を感じることができました。理論から実用まで幅広いトピックが扱われ、日々の業務に直結する学びも多く得られました。今後も最新技術の動向を注視しながら、プロダクトへの応用に繋げていきたいと思います。 SIGIR2026の開催地はオーストラリアのメルボルン ZOZOでは、一緒にサービスを作り上げてくれる仲間を募集中です。ご興味のある方は、以下のリンクからぜひご応募ください! corp.zozo.com
ZOZOTOWN開発本部でZOZOTOWN iOSの開発を担当している らぷらぷ です。例年プライベートのメイン機であるiPhoneをベータアップデートしてますが、いつまで正常に動作しつづけるのかヒヤヒヤしています。 今年のWWDC25も開催期間中には追いきれないほど数多くのアップデートがありました。みなさんはどのセッションが気になりましたか。 本記事では、ZOZOのiOSエンジニアが気になったセッションをご紹介します。この記事を読み終えたらぜひあなたの気になるセッションとともに感想をシェアして頂けると嬉しいです。 また、今回試したAIを活用したセッションのキャッチアップ効率化についてもご紹介します。 気になったセッション WebKit for SwiftUI こんにちは。WEAR by ZOZOのiOSアプリ開発を担当しているセータです。 今回の発表では、WebKitがSwiftUI向けにアップデートされ、iOS26から標準でWebViewを使用できるようになりました。詳細は「 Meet WebKit for SwiftUI 」のセッションをご覧ください。 セッションではWebViewとWebPageクラスが登場します。WebView(url:)と記述するだけで簡単にWebサイトを表示でき、WebPageクラスを合わせて使うことで、URLや読み込み状況、進捗などをプロパティとしてリアルタイムで監視できます。これにより、これまでUIViewRepresentableを使って行っていた複雑な実装が不要になります。状態を管理するために必須だったKVO(Key-Value Observing)やDelegateがなくなることで、より直感的なカスタマイズが可能です。 WebPageクラスでは、状態管理だけでなく、WKWebViewが提供しているほとんどの機能が使用できます。これにより、既存の実装からスムーズに移行できそうです。 現在WEARでも一部画面でSwiftUI化を進めているので、今回のアップデートによって将来的なリプレイスの負担が軽減されることを期待しています。 Record, replay, and review: UI automation with Xcode ZOZOTOWN iOSの開発を担当しているらぷらぷです。 UIAutomationが提供されてからこの技術をベースとした様々なUIテストコード生成ツールが長年出てきましたが、ついにXcodeと連携するテスト録画機能が提供されました。「 Record, replay, and review: UI automation with Xcode 」および 公式ドキュメント で詳しく紹介されています。 実際に触ってみたところ、タップ・ダブルタップ・スワイプなどの基本的な操作の記録はしっかりカバーしていることはもちろんのこと、記録終了後に任意の要素に複数の要素クエリが存在する場合はXcode上で選択できる点が使いやすかったです。 将来 GPT Driver のようなAI連携が進み、記録したテストの自動修正、必要なテストシナリオの提示や自動記録のようなことが実現すると嬉しいですね。 Writing Tools ショップスタッフ向けの販売サポートツールであるFAANSのiOSアプリを開発しているイッセーです。 今回のWWDCでは、Apple Intelligenceを活用した文章の校正・添削機能「Writing Tools」のアップデートが発表されました。詳細は「 Dive deeper into Writing Tools 」のセッションをご覧ください。 私が注目したのは、UIBarButtonItemにWriting Toolsが追加され、キーボードのツールバー上に起動ボタンを表示できるようになった点です。セッションでは純正のメールアプリやメモアプリを例に、テキストが多いアプリにはツールバーにボタンを追加するよう推奨されていました。iOS、iPadOS、macOSでは18.2以上で使用できるため、すぐに導入できます。 また、Writing Toolsは選択したテキストに表示されるボタンを押すことで起動する必要があり、便利でありながらも使用までのハードルが高いという課題がありました。 しかし今回のアップデートにより、Writing Toolsを起動するためのプログラムは別途必要であるものの、ツールバーから直感的に起動できるようになりました。 私たちが開発しているFAANSには、コーディネート写真・動画にタイトルや説明文を入力する機能があります。この入力時にWriting Toolsを起動するボタンをツールバーに追加することで、ショップスタッフの方々の投稿作成の負担を軽減し、より質の高い文章作りをサポートできると考えています。そのため、導入を検討したいと思います。 Wi-fi Aware 対応 こんにちは、ZOZOTOWNのiOSアプリ開発を担当しているぎゅです。 WWDC25では、Appleデバイス間の近距離通信を可能にする「Wi-Fi Aware」のサポートが発表されました。 Wi-Fi Awareとは、Wi-Fi Allianceが標準化した近接通信技術で、対応するスマートフォンやIoT端末などがインターネットやアクセスポイントを介さずに近くのデバイスを発見・直接通信(P2P)できる技術です。 iOS 26・iPadOS 26からは、Apple製品同士の接続はもちろん、iOS ↔ AndroidやiOS ↔ Windowsといった異なるプラットフォーム間での通信も可能になりました。これにより、これまでApple製品内に限定されていた体験が、より多くのデバイス環境で活用できるようになります。詳細は「 Supercharge device connectivity with Wi-Fi Aware 」のセッションをご覧ください。 Wi-FiやBluetoothに依存せず、インターネット接続なしでも異なるプラットフォームのデバイスを自動的に発見・通信できる点が特に興味深いポイントです。接続時には確認コードで認証されるため、安全性も担保されています。WifiAwareおよびNetworkフレームワークを用いて実装可能です。 今回のアップデートにより、周辺機器との自動ペアリングや低遅延通信がよりシンプルに実現される見込みです。期待されるユースケースとしては、ファイル送受信の高速化、画面共有、オフラインでのコンテンツ同期などが想定されます。 これまでAppleはAWDLという独自のP2P通信技術を使用していましたが、EUの規制により、標準プロトコル(例:Wi-Fi Aware)への準拠が求められるようになったことが背景にあるようです。 今回のWi-Fi Aware対応を活かして、ZOZOTOWNで見つけた商品を近くのデバイスと画面・動画で共有しながら、ファッション体験を楽しめるようなシーンに応用できるのではと期待しています。 キャッチアップについて 去年はセッション動画の字幕をAIチャットボットに要約させてセッションを深ぼるべきか短時間で見極めていました。今年は去年以上のAIツールの進化を利用すべく、こうしたキャッチアップの効率化をさらに加速できないか試行錯誤しました。 今回試した手法の中でおすすめしたいのがNotebookLMにセッションのYouTube動画を追加して要約させる方法です。テキストベースのレポートに加えて、マインドマップ出力を用いて視覚的な理解を補助してくれます。また、日本語の音声要約を活かしてポッドキャストを聞くかのような体験でキャッチアップを手助けしてくれます。 WWDC初日からAppleがYouTubeの公式アカウントでセッション動画を全て公開してくれたからこそ思いついた手法でした。字幕の自動翻訳対応の恩恵を考えると、来年以降もYouTubeでセッション動画がすぐ見られるとありがたいです。 おわりに 今年のWWDCは公式サイトおよび AppleのYouTubeチャンネル でセッション動画が初日から全て公開されたり、Group labsのようなパネルディスカッションが用意されたりと、リモート参加者に対する創意工夫が感じられるイベントでした。来年のWWDCも楽しみです。 また、現地に参加された @ikkou のレポートと、 @wiroha によるLINEヤフーとの合同報告会の記事もあわせてぜひご覧ください。 techblog.zozo.com techblog.zozo.com ZOZOでは、一緒にサービスを作り上げてくれる仲間を募集中です。ご興味のある方は、以下のリンクからぜひご応募ください。 hrmos.co
.table-of-contents ul ul { display: none; } はじめに こんにちは、データシステム部MLOpsブロックの 岡本 です。 MLOpsブロックではWEAR by ZOZO(以下WEAR)やZOZOTOWNのレコメンドシステムを開発・運用しています。 WEARのコーディネート詳細画面には、表示しているコーディネートに関連性が高いコーディネートを表示する関連枠があります。今回、WEARのコーディネート詳細画面の関連枠におけるコーディネートの表示ロジックを、ルールベースからMLを使ったロジックに置き換えました。新たに開発したMLを使ったロジックを、以下では関連コーデレコメンド機能と呼んでいます。説明のため、以下では関連コーデレコメンド機能を本機能と記載します。 本機能の開発ではベクトル検索技術を利用しています。ベクトル検索の実装には、Google Cloudが提供するマネージドなベクトル検索サービスである Vertex AI Vector Search を利用しました。 Vertex AI Vector Searchでベクトル検索機能を実装する際に、Google Cloudの公式ドキュメントの説明だけでは理解しにくかった点などいくつか苦労がありました。また本番環境のシステムの一部として運用し、遭遇した課題やその解決策についても学びがありました。 本記事では、WEARの関連コーデレコメンドプロジェクトのベクトル検索の開発にVertex AI Vector Searchを導入し、実装・本番運用で得られた知見を説明します。Vertex AI Vector Searchを使ってベクトル検索機能を実装する際の参考になれば幸いです。 記事の内容は2025年7月時点での情報であることにご留意ください。 目次 はじめに 目次 プロジェクト説明とVertex AI Vector Searchの導入背景 関連コーデレコメンドプロジェクトの概要 レコメンドロジックの概要 グラフニューラルネットワークモデルによるEmbeddingの抽出 2段階のベクトル検索 Vertex AI Vector Searchの導入背景 過去プロジェクトにおけるベクトル検索機能の実装 Vertex AI Vector Searchの導入モチベーション ベクトル検索機能を持つマネージドサービスの比較 Vertex AI Vector SearchとScaNNアルゴリズムの概要 Vertex AI Vector Searchの概要 ScaNNアルゴリズムの概要 Index構築の実装とパラメータ値の決定 Indexの作成・更新フロー Index構築の実装 Index作成の実装 Index Endpointの作成とIndexのデプロイ Index構成パラメータの決定 クエリ実行時に上書きしているパラメータ Index構成時に指定しているパラメータ Indexサイズの見積もりとシャードサイズの決定 Indexのデプロイ戦略とEmbeddingの更新・削除方法 Indexのデプロイ戦略 Indexの更新・削除 Indexの更新方法 Indexの削除方法 ベクトル検索クエリ実行とフィルタリングの実装 クエリ実行の実装 フィルタリングの実装 Vertex AI Vector Searchの本番運用と課題の改善 モニタリング運用 運用して感じたメリット 運用・保守の容易さ 安定したパフォーマンス 運用して見つかった課題と改善 Indexの更新時間が長い Indexのデータ更新費用の増加 Embedding更新対象のデータ数を削減 Indexのデータ更新費用の見積もり まとめ プロジェクト説明とVertex AI Vector Searchの導入背景 関連コーデレコメンドプロジェクトの概要 WEARの関連コーデレコメンドプロジェクトでは、コーディネート詳細画面の関連枠に表示するコーディネートの選出ロジックをルールベースからMLに置き換えることを目的としました。 下図の左側の画像は、WEARのコーディネート詳細画面の関連枠のUIで、右側の画像がコーディネート詳細のトップです。関連枠はコーディネート詳細画面の下部に表示され、ユーザーが閲覧しているコーディネートに関連する他のコーディネートをコンテンツとして一覧表示します。 ルールベースのロジックでは、コーディネートに紐づくメタデータを使って関連枠に表示するコーディネートを選出していました。ルールベースによる関連枠の表示には次の課題がありました。 視覚的な類似性を考慮できていない ログインユーザーの嗜好に基づいた関連性を考慮できていない 本プロジェクトでは既存のルールベースによるコーディネート選出での上記2つの課題を解決するため、MLを使った手法でコーディネートを選出しました。よりユーザーが興味を持つコーディネートを提案することを目指し、関連枠でのインプレッション数、クリック数といったKPIの改善を図りました。 レコメンドロジックの概要 グラフニューラルネットワークモデルによるEmbeddingの抽出 本機能ではユーザー・コーディネートのベクトル表現であるEmbeddingを抽出し、ベクトル検索に利用することでユーザーごとにパーソナライズされた類似コーディネートを選出しました。 Embeddingの抽出にはグラフニューラルネットワーク(以下GNN)を用いています。GNNは深層学習の手法であり、ネットワーク構造を持つデータに対して効率的に特徴を学習・表現します。ネットワークは各要素を表すNodeとNode間を結ぶEdgeから構成されます。本機能ではWEARにおけるユーザーとコーディネートの関係をネットワークとして表現し、GNNモデルでコーディネートとユーザーの関係性を学習しました。WEARにおけるユーザーとコーディネートの関係は次のネットワーク構造で表現しました。 Node ユーザー コーディネート Edge ユーザー行動 クリック いいね etc... WEARのデータを用いて学習したGNNモデルを使うことで、ネットワークの持つ構造的な特徴を反映したEmbeddingを抽出できます。またGNNモデルとは別のモデルでユーザー・コーディネートの内部特性を表す特徴量を抽出しており、GNNモデルで抽出したEmbeddingと集約することで最終的なEmbeddingを作成しています。こうしてユーザー・コーディネートについて構造的かつ属性を反映したEmbeddingを得ています。 このように得られたコーディネートのEmbeddingを用いて、ベクトル検索のIndexを構築しています。構築したIndexを対象にベクトル検索クエリを実行することでコーディネート群を取得できます。ユーザーのEmbeddingはリランキングに利用しており、リランキングについては後節( 2段階のベクトル検索 )で説明します。 2段階のベクトル検索 本機能ではユーザーごとにパーソナライズされた類似コーディネート群を取得するため、2段階でベクトル検索しています。 類似コーディネート群の取得 ユーザー嗜好に基づくパーソナライズ(リランキング) 1段階目のベクトル検索クエリ実行では、コーディネートEmbeddingを入力として視覚的に類似したコーディネート群を取得します。 続いて2段階目のベクトル検索クエリ実行では、ユーザーEmbeddingを入力として1段階目で取得した類似コーディネート群をリランキングします。 リランキングにより類似コーディネート群はユーザーの嗜好に基づいて並び替えられます。これにより関連枠に表示する最終的なコーディネートを決定します。 Vertex AI Vector Searchの導入背景 過去プロジェクトにおけるベクトル検索機能の実装 MLOpsブロックでは関連コーデレコメンドプロジェクト以前にも、ベクトル検索を利用した他のレコメンドシステムを構築・運用していました。一方で過去のシステム実装時にはベクトル検索のマネージドサービスが充実しておらず、自前でベクトル検索機能を実装・運用していました。 過去に自前でベクトル検索機能を実装し、運用を続けているシステムの1つとして、 ZOZOTOWNの類似アイテム検索機能 があります。 類似アイテム検索機能はZOZOTOWNの商品詳細画面から利用できる機能で、ユーザーが閲覧している商品に類似した商品を検索します。類似アイテム検索では、商品画像から抽出した特徴量によりベクトル検索Indexを構築しています。構築したIndexに対してベクトル検索クエリを実行し、類似商品を取得しています。 類似アイテム検索のベクトル検索システムは主に次の機能を含んでおり、これらの実装・運用にかかる工数面での課題がありました。 バッチ処理 Indexの構築 Indexの更新(新規商品の追加・削除) ベクトル検索API Indexを用いてベクトル検索クエリを実行 Indexのリリース管理 バッチで作成したベクトル検索Indexの更新をベクトル検索APIに反映 特にIndexのリリース管理はシステム的にバッチ処理とベクトル検索APIに跨る部分であり、実装だけでなく運用面の複雑さを増す要因となり課題感がありました。バッチとベクトル検索API間の連携について以下で説明します。 前提としてMLOpsブロックではAPIの動作インフラとしてGoogle Kubernetes Engine(以下GKE)を利用しています。類似アイテム検索のベクトル検索APIもGKE上にPodとしてデプロイされています。 ベクトル検索APIのコンテナはベクトル検索Indexをメモリに持ち、クエリ実行時はIndexを参照してベクトル検索します。API起動時にIndexをメモリへ読み込み、保持しています。そのためIndexの更新をベクトル検索APIへ反映するにはPodの再起動が必要です。 Index更新時は同期的にベクトル検索APIへIndex更新を反映するため、Index更新とベクトル検索APIのPodの再起動を両方バッチ処理で実行していました。 上記の構成では運用面で具体的に次の課題がありました。 ベクトル検索APIの回復性が悪い Indexのデータ量が大きく、ベクトル検索APIのPod起動に時間がかかる Podの入れ替わり頻度が高いことによる障害リスクの増加 入れ替わり時にはエラー発生のリスクが高い 入れ替わり時の障害リスクを防ぐためには、リクエストのドレインやProbeなど特に慎重に考慮する必要があり、実装難易度が高い バッチとAPI間の依存によるシステムの複雑性の高さ ベクトル検索APIへのIndex更新の反映タイミングを開発者側で制御できない バッチ処理を実装する上で、ベクトル検索APIの実装や構成を考慮する必要がある このように自前でベクトル検索機能を実装・運用する場合は工数・システムの複雑性の面でいくつかの課題がありました。 Vertex AI Vector Searchの導入モチベーション 本システムの開発でVertex AI Vector Searchの導入に至ったモチベーションは次になります。 マネージドサービスである ベクトル検索機能の実装・運用・保守の工数を抑えられる 一度IndexをデプロイすればIndexのEmbedding更新はVertex AI Vector Search側で自動反映する 高速なクエリ実行が可能 ScaNN アルゴリズムを利用して高速な近似最近傍探索が可能 将来需要に備えた知見獲得 今後社内でベクトル検索を利用したレコメンドシステムの開発が増えると予想されるため、マネージドサービスでのベクトル検索機能の開発・運用事例を獲得する マネージドサービスであるVertex AI Vector Searchを利用することで、ベクトル検索機能を自前で実装・運用する場合の工数やシステムの複雑性の課題を解決できると考えました。また今後社内でベクトル検索を利用したレコメンドシステムの開発が増えることも予想されており、Vertex AI Vector Searchを利用した開発・本番運用の知見を獲得したい狙いもありました。WEARはZOZOTOWNと比較するとトラフィック負荷は小さいため、Vertex AI Vector Searchを本番環境で利用し、知見を得るには適したプロジェクトであると判断しました。 Vertex AI Vector Searchでは、ベクトル検索のアルゴリズムにScaNNアルゴリズムを利用しており近似最近傍探索を高速に実行できます。前述した類似アイテム検索のベクトル検索機能では Annoy アルゴリズムを利用していました。後発の手法であるScaNNアルゴリズムの性能を試す良い機会であると考えました。 ベクトル検索機能を持つマネージドサービスの比較 Vertex AI Vector Searchを導入する前に、Google Cloudのその他のベクトル検索サービスと比較しました。 Google Cloudでは複数のマネージドデータベースサービスでベクトル検索機能も提供しています。このうち AlloyDB for PostgreSQL (以下AlloyDB)でもScaNNアルゴリズムを利用しています。マネージドサービスである点やScaNNアルゴリズムを利用している点で、AlloyDBのベクトル検索機能はVertex AI Vector Searchと類似しています。一方で本番システム以外のユースケースでは、サービス構築や他サービスとの連携の容易性もサービス選定の上で重要な要素と考えました。 MLOpsブロックが関わるプロジェクトの機能開発では、本番システム開発初期の段階で実験・PoCを行います。この段階では主にMLエンジニアやデータサイエンティストがMLモデルの精度や出力の評価・改善をします。本システムの最終的な出力は、GNNモデルで抽出したEmbeddingではなくベクトル検索クエリ実行の結果です。そのため実験・PoCの段階でもGNNモデルで抽出したユーザー・コーディネートのEmbeddingを元にベクトル検索Indexを構築し、クエリを実行して結果を比較・確認可能にします。 本番システムの開発ではサービス選定時にシステムの堅牢性や安定性を重視します。一方で開発初期の実験・PoC段階での開発では構築容易性と柔軟性を重視しています。実験・PoC段階での利用も考慮に入れると、Vertex AI Vector SearchにはAlloyDBと比較して次の優位性を感じました。 環境構築が容易 データベースの構築が不要 Google Cloud Storage (以下GCS)のデータを元にIndexを作成可能 Indexの切り替えが容易 Vertex AI Pipelines と合わせて利用しやすい AlloyDBでベクトル検索機能を利用するには、 PostgreSQL のデータベースの構築が必要です。これに対してVertex AI Vector SearchではGCSのデータを元にIndexを作成できるため、データベースの構築が不要でソースデータも用意しやすく環境構築が容易です。またVertex AI Vector Searchではアクセス先となるIndex EndpointとIndexが分離されており、Indexを切り替えてベクトル検索結果を比較可能です。 さらにVertex AI Vector Searchは社内のML系のサービスのパイプライン開発で多く利用しているVertex AI Pipelinesとも合わせて利用しやすいです。Vertex AI Pipelinesは Kubeflow Pipelines のフレームワークを使用してサーバレスでMLワークフローをオーケストレーションできるサービスです。Kubeflow PipelinesはKubernetes上で機械学習ワークフローを管理するためのオープンソースツールです。 Vertex AI Pipelinesではパイプラインの成果物であるArtifactをGCSに保存します。Vertex AI Vector SearchではGCSのオブジェクトを元にIndexを作成します。そのためVertex AI Pipelinesでパイプラインの成果物として保存したGCSのデータを直接参照してIndexを作成・更新できます。パイプラインでのIndexの作成・更新については後節( Indexの作成・更新フロー )で説明します。 これらの観点からベクトル検索機能のマネージドサービスとしてVertex AI Vector Searchを選定しました。 Vertex AI Vector SearchとScaNNアルゴリズムの概要 Vertex AI Vector Searchの概要 Vertex AI Vector Searchは、Google Cloudが提供するマネージドなベクトル検索サービスです。以前はVertex AI Matching Engineという名称で提供されていました。 Vertex AI Vector Searchは主に次のコンポーネントで構成されています。 Vector Search Index Vector Search Index Endpoint(以下Index Endpoint) Vector Search Indexは、ベクトル検索のIndexを表現するコンポーネントで、GCSに保存されたデータを元に構築されます。Index Endpointは、構築したIndexのデプロイ先であり、クエリを受け付けるエンドポイントです。 各コンポーネントの関係性は次の図で表せます。 開発者は事前にIndex EndpointとIndexを作成します。Indexを指定したIndex Endpointにデプロイすることでベクトル検索クエリを実行できます。Vertex AI Vector Searchの各コンポーネントをこのように構成することでベクトル検索機能を実装できます。 ScaNNアルゴリズムの概要 Vertex AI Vector Searchを利用する上で、ScaNNアルゴリズムの特徴の理解は有用です。 ScaNNアルゴリズムは次の特徴を持つ近似最近傍探索の手法です。 データを事前にパーティショニングし、検索時には全データを対象とせずに近いパーティションのみを検索することで計算コストを削減する ベクトル量子化手法の一種であるProduct Quantization(PQ)により高次元ベクトルを圧縮するためメモリ効率が良い ScaNNアルゴリズムでは次の3段階の処理でベクトル検索をします。 パーティショニング:データを事前にパーティショニングし、クエリ実行時に上位のパーティションを選択して、2段階目のスコアリングに進む スコアリング:検索対象のパーティション内の全データポイントまでの距離を近似計算し、スコアリングする 再スコアリング:2段階目のスコアリングの結果から上位k'個のデータポイントを選択する。正確な距離を再計算した上で上位k個のデータポイントを選択することで再スコアリングする(k'はkより大きな値を取る) 1・2段階目の処理では計算コストを削減し、3段階目の再スコアリングで精度を向上させます。これにより速度と精度のトレードオフを両立しており、大規模なデータセットに対しても高速な近似最近傍探索を実現しています。 Vertex AI Vector Searchで提供されているTreeAH IndexはScaNNアルゴリズムを使用するベクトルIndexの1つです。 TreeAHでは1段階目の処理でデータをツリー構造にパーティショニングします。パーティショニングを行わない場合は全データを対象に近似計算するブルートフォース検索となります。 TreeAHの2段階目の処理では、PQの中でも特に4-bit PQを利用して高次元ベクトルを圧縮(量子化)します。4-bit PQを利用することでSIMDレジスタに収まるサイズのベクトルを扱うことができます。 SIMDとはSingle Instruction, Multiple Dataの略で1つの命令で複数のデータを並列化し、同時に処理する形態を指します。4-bit PQではCPUのSIMD命令を利用することで高速な近似最近傍探索が可能になっています。TreeAHの AH はAsymmetric Hashingの略です。クエリベクトルは量子化されない生ベクトルである一方、候補データのベクトルは事前に量子化されていることがAsymmetric Hashingの所以です。 ScaNNアルゴリズムのドキュメントでは経験則としてデータ数に応じて次の構成が推奨されています。 データ規模 推奨手法 20,000 件未満 ブルートフォースを使う 100,000 件未満 Asymmetric Hashing(AH)でスコアリングし、その後再スコアリングする 100,000 件以上 パーティショニングを行い、AH でスコアリングし、その後再スコアリングする ScaNNアルゴリズムやTreeAHの理解にあたっては次の資料を参考にさせていただきました。 Accelerating Large-Scale Inference with Anisotropic Vector Quantization ScaNN Algorithms and Configuration また近似最近傍探索のアルゴリズムや4-bit PQについては次の資料を参考にさせていただきました。 近似最近傍探索の最前線 4-bit PQの解説 アルゴリズムの詳細については上記の資料をご参照ください。 Index構築の実装とパラメータ値の決定 Indexの作成・更新フロー 関連コーデレコメンドのシステムでは、Embeddingの抽出からIndexの作成・更新・デプロイまでの一連の処理をパイプラインで実行しています。パイプラインのインフラにはVertex AI Pipelinesを利用しています。 本システムのパイプラインは日次実行しており、デプロイ済みのIndexを更新しています。Index更新時は新規コーディネートのEmbeddingの追加や、既存のコーディネートのEmbeddingを最新のユーザーの行動を反映したEmbeddingへ更新します。さらに削除済みのコーディネートのEmbeddingを削除することでIndexを最新化します。 下図は本システムでVector Search Indexを作成・更新・デプロイするパイプラインの処理のフローを示しています。説明の関係でVertex AI Vector Searchに直接関係しない処理は省略しています。 Vertex AI Pipelinesで実行される各タスク間のデータの受け渡しにはArtifactを利用しています。ArtifactはKubeflowでデータを保存するための仕組みです。Vertex AI PipelinesにおいてArtifactはGCSのオブジェクトとして保存されます。 パイプラインのタスクで抽出したコーディネートのEmbeddingはIndexのソースデータ形式に合わせて成形し、ArtifactとしてGCSに保存します。Vertex AI Vector SearchではGCSのデータを元にIndexを作成・更新します。パイプラインのタスクで保存したArtifactをそのままIndexのデータソースとして参照し、Vertex AI Vector SearchのIndexを作成・更新しています。 システムの構成にあたってはGKEクラスタとVertex AI Vector Search、Vertex AI Pipelinesで利用するリージョンを揃えることに注意しました。 ZOZOではDWHとしてBigQueryを利用しており、パイプラインで扱う多くのデータはUSマルチリージョンに保存されています。そのため通常は、Vertex AI Pipelinesの実行リージョンはBigQueryのクエリ費用を抑えるためにUS系のリージョンを利用することが多いです。 一方で本システムではVertex AI Vector Searchの呼び出し元となるAPIは asia-northeast1 リージョンのGKEクラスタで動作しています。以下では呼び出し元となるAPIをアプリケーションAPIと記載します。ベクトル検索クエリ実行時のレイテンシを抑えるためIndex EndpointはアプリケーションAPIと同じ asia-northeast1 リージョンに作成しています。またVertex AI Vector SearchではIndexデプロイ時の制約として、デプロイ先のIndex EndpointとIndexのリージョンを一致させる必要があります。この制約によりIndexのリージョンはIndex Endpointに合わせて asia-northeast1 リージョンに作成しました。 Indexのリージョン制約としては、ソースデータに指定するGCSのバケットとIndexのリージョンを一致させる必要もあります。本システムではVertex AI PipelinesのArtifactをIndexのソースデータとして直接参照しています。そのためArtifactを保存するGCSのバケットも asia-northeast1 リージョンに作成しました。 またVertex AI Pipelinesでは、Artifactの保存先のGCSバケットのリージョンとパイプラインを実行するリージョンを一致させる必要があります。そのためパイプラインの実行も asia-northeast1 リージョンで行うようにしました。 リージョン制約は見落としがちであるため、システム設計時に確認しておくことをおすすめします。 Index構築の実装 Index作成の実装 パイプラインでのVertex AI Vector Search Index、Index Endpointに関わるタスク実装にはVertex AI SDK for Pythonを利用しました。 Index作成の実装は次の通りです。 MatchingEngineIndex クラスの create_tree_ah_index メソッドを呼ぶことでIndexを作成できます。 create_tree_ah_index メソッドの引数のうち dimensions 以下の引数はIndex構成パラメータです。Index構成パラメータについては後節( Index構成パラメータの決定 )で別途説明します。 from google.cloud.aiplatform.matching_engine import MatchingEngineIndex created_index = MatchingEngineIndex.create_tree_ah_index( project=project_id, location=location, display_name=index_display_name, index_update_method= "BATCH_UPDATE" , contents_delta_uri=gcs_uri, ####### 以下はIndex構成パラメータ ######## dimensions=dimensions, approximate_neighbors_count=approximate_neighbors_count, shard_size=shard_size, leaf_node_embedding_count=leaf_node_embedding_count, distance_measure_type=distance_measure_type, feature_norm_type=feature_norm_type, ) with open (output_index_name, "w" ) as f: f.write(created_index.name) 引数の contents_delta_uri にはIndex作成のソースデータとして参照するGCSのURI( gs:// で始まるもの)を指定します。ソースデータとして参照するフォルダは次の構成に従う必要があります。フォルダ名やファイル名は任意ですがファイルの拡張子は .csv 、 .json 、 .avro のいずれかである必要があります。 batch_root/ feature_file_1.json feature_file_2.json 各ファイルはEmbeddingデータを含み、データの形式は決まっています。密Embedding、スパースEmbedding、ハイブリッドEmbeddingのどれを使用するかによって、ファイル内のデータ形式が決まっているため注意が必要です。詳細は公式ドキュメントの 入力データ処理 を参照してください。本システムでは密Embeddingを使用しており、各ファイルは次の例の形式で保存しています。例に記載のid、embeddingの値はご自身の環境に合わせて置き換えてください。 { " id ": " 1 ", " embedding ": [ 0.1 , 0.05 , 0.3 ] } { " id ": " 2 ", " embedding ": [ 0.2 , 0.01 , 0.02 ]} Index内の各Embeddingごとのレコードを以下ではデータポイントと呼びます。データポイントのidはIndex内で一意になるため重複しないように注意してください。本システムではコーディネートが一意のidを持っているためコーディネートのidをそのままデータポイントのidとして利用しました。 create_tree_ah_index メソッドの戻り値は MatchingEngineIndex クラスのインスタンスでありIndexのメタデータを含みます。インスタンスの name プロパティを参照することで完全修飾されたIndexのidを取得できます。Indexのidはデプロイ時に必要であるため、 created_index.name の値を最後にタスクの出力パラメータとして書き込んでいます。 Index Endpointの作成とIndexのデプロイ 作成したIndexをデプロイする前にデプロイ先となるIndex Endpointの作成が必要です。 Index Endpointはパイプラインとは別で Terraform により作成しました。TerraformはIaCツールの1つでインフラの構成を宣言的に記述でき、ソースコードとして管理できます。MLOpsブロックでは原則としてGoogle Cloudのインフラ構成をTerraformで定義し、管理しています。 次に示すのはIndex Endpointを作成するTerraform実装です。Terraform Providerの設定は省略していますが、 google Provider を利用して作成可能です。 resource "google_vertex_ai_index_endpoint" "user_to_snap_index_endpoint" { display_name = "user_to_snap_index_endpoint" region = "asia-northeast1" network = "projects/1234/global/networks/dummy-vpc-network" public_endpoint_enabled = false } Vertex AI Vector Searchへのリクエストはセキュリティ、レイテンシの観点から内部通信のみに制限しています。Index Endpointの作成時にVPCネットワークを指定することで、サービスプロデューサー側のネットワークとユーザーが作成するVPCネットワーク間でVPC Peeringを構成できます。VPC Peeringを構成することで2つのVPCネットワークを接続でき、各ネットワーク内のリソースが相互に内部通信できます。Vertex AI Vector SearchのVPC Peering構成の詳細については公式ドキュメントの VPC ネットワーク ピアリング接続を設定する を合わせてご参照ください。 またVertex AI Vector SearchではGoogle Cloudのネットワーキング機能の1つである Private Service Connect もサポートしています。Private Service Connectを利用する場合は公式ドキュメントの Private Service Connect でベクトル検索を設定する をご参照ください。 次に示すのはパイプラインでIndexをデプロイする実装例です。Terraformで事前作成したIndex Endpointのidを指定して MatchingEngineIndexEndpoint クラスのインスタンスを作成します。作成したインスタンスの deploy_index メソッドを呼ぶことでIndexをデプロイできます。 import time from google.cloud.aiplatform.matching_engine import MatchingEngineIndex, MatchingEngineIndexEndpoint index_endpoint_name = ( "projects/<YOUR_PROJECT_NAME>/locations/asia-northeast1/indexEndpoints/<YOUR_INDEX_ENDPOINT_ID>" ) index_name = "<YOUR_INDEX_ID>" machine_type = "e2-standard-16" min_replica_count = 2 max_replica_count = 5 index_endpoint = MatchingEngineIndexEndpoint( index_endpoint_name= str (index_endpoint_name), ) index = MatchingEngineIndex( index_name= str (index_name), ) current_timestamp_sec = int (time.time()) deployed_index_id = f "{index.display_name}_{index.name}_{current_timestamp_sec}" deployed_index_endpoint = index_endpoint.deploy_index( index=index, deployed_index_id=deployed_index_id, display_name=index_endpoint_display_name, deploy_request_timeout=timeout, ####以下ではマシンタイプやレプリカ数を指定##### machine_type=machine_type, min_replica_count=min_replica_count, max_replica_count=max_replica_count, ) with open (output_index_endpoint_name, "w" ) as f: f.write( str (deployed_index_endpoint.name)) Indexのデプロイ後はIndexのidとは別にデプロイ済みIndexのidが付与されます。デプロイ済みIndexはGoogle Cloudのコンソール上で確認できます。次の画像に含まれる ID の値がデプロイ済みIndexのidです。 本システムでは、デプロイ対象のIndexのidと作成時のタイムスタンプを組み合わせてデプロイ済みIndexのidを生成しています。タイムスタンプを含めるのは、同じIndexを再度デプロイした場合にデプロイ済みIndexのidが重複しないようにする意図です。 Indexのデプロイ時にはマシンタイプやノードの最小・最大レプリカ数を指定できます。利用可能なマシンタイプは後述するIndex構成パラメータの1つであるシャードサイズごとに限定されます。マシンタイプはIndexのデプロイ後に変更できないため、シャードサイズを見積もった上でマシンタイプの選定が必要です。Indexサイズの見積もりとシャードサイズの決定については後節( Indexサイズの見積もりとシャードサイズの決定 )で説明します。 またマシンタイプには、それぞれパフォーマンスと費用のトレードオフがあります。これらを考慮した上で、システムの要件に合わせてマシンタイプを選定することをおすすめします。マシンタイプごとのパフォーマンスについては公式ドキュメントの パフォーマンスに影響するデプロイ設定 をご参照ください。 レプリカ数はIndexのシャードごとのノード台数を指定するパラメータです。つまり シャード数xレプリカ数 がノード台数の合計になります。レプリカ数は最小・最大レプリカ数の範囲でオートスケーリングします。また最小レプリカ数を2未満に設定する場合はVertex AIサービスレベル契約の対象外となるため注意してください。 Indexをデプロイするとアクセス先となるgRPCアドレスが割り当てられます。ベクトル検索クエリ実行時はこのgRPCアドレスを指定してリクエストを送信します。リクエスト先となるアドレスの範囲は deploy_index メソッドの reserved_ip_ranges 引数で指定可能です。指定がない場合はVPC内でVPC Peering用に割り当てているアドレス範囲から割り当てられます。ノードのレプリカ数を変更した場合もリクエスト先のgRPCアドレスは不変です。 Indexのデプロイに関する詳細は公式ドキュメントの VPC ネットワークにインデックス エンドポイントをデプロイして管理する を参照してください。また deploy_index メソッドの詳細については Python SDKのドキュメント をご参照ください。 Index構成パラメータの決定 Indexの作成時にはIndex構成パラメータを指定します。パラメータの多くはIndex作成時に確定しますが、クエリ実行時に設定値を上書きすることで動的に調整できるものもあります。ここでは、Index作成時に指定するパラメータとクエリ実行時に動的に調整しているパラメータについて、本システムを構成した際の値の決め方を説明します。 ベクトル検索で利用するアルゴリズムはTreeAHとBruteForceの2種類から選択できます。前節( ScaNNアルゴリズムの概要 )で述べたScaNNアルゴリズムのドキュメントの経験則では100,000件以上のデータ規模ではTreeAHの利用が推奨されていました。本システムのIndexに含まれるEmbedding総数は約1,400万件であるため、TreeAHを利用することにしました。本記事での内容は特に断りがない限りはTreeAHアルゴリズムの利用を前提としていることをご留意ください。 Index構成パラメータについては公式ドキュメントの インデックス構成パラメータ も本節の内容と合わせてご参照ください。 クエリ実行時に上書きしているパラメータ 本システムではクエリ実行時、次のIndex構成パラメータを上書きすることで動的に調整しています。 フィールド 説明 approximateNeighborsCount 再スコアリング実行前の近似探索によってデフォルトで探索される近傍数 fractionLeafNodesToSearch クエリが検索されるリーフノードのデフォルトの割合 これらの値の大小は再現率とレイテンシ間のトレードオフになります。値を大きくするほど検索範囲が広がるため再現率は向上する一方でレイテンシは増加します。 またIndexの構成パラメータではありませんが、ベクトル検索クエリ実行時にはクエリで返す結果の数である setNeighborCount も指定できます。この値が大きくなるほどレイテンシは悪化します。 前節( 2段階のベクトル検索 )の説明の通り、本システムは1段階目のベクトル検索で取得した類似コーディネート群を2段階目のベクトル検索でリランキングし最終的な結果を返します。ここで最終的に返すべき件数の上限を60件とする要件は決まっていたため、この値を元にその他のパラメータ値を決定しました。 まず1段階目のベクトル検索におけるパラメータ値の決定について説明します。1段階目は「粗く速く、多めに拾う」を意識して決定しました。 2段階目に1段階目で取得した結果をリランキングすることを鑑みると1段階目ではなるべく多くの結果を返したいと考えました。そのため2段階目で返す60件よりも十分大きい値を1段階目で返す結果数の上限とし、 setNeighborCount の値を決定しました。 公式ドキュメント( パフォーマンスに影響するクエリ時間の設定 )では setNeighborCount の値が小さい場合、 approximateNeighborsCount の値を10倍にすることが推奨されています。 approximateNeighborsCount の値はこの推奨に従って決定しました。 本システムのビジネス要件ではそれほど高い再現率は要求されていませんでした。そのため類似コーディネート群の取得においては、再現率よりもレイテンシを優先して fractionLeafNodesToSearch は比較的小さい値であるデフォルト値をそのまま採用しました。 上記を踏まえて1段階目のクエリ実行時に上書きしたパラメータと値は次の通りです。参考までに本システムのベクトル検索IndexのEmbedding総数は約1,400万件です。 フィールド 値 approximateNeighborsCount 10,000 fractionLeafNodesToSearch 0.05 setNeighborCount 1,000 続いて2段階目のベクトル検索におけるパラメータ値の決定について説明します。2段階目は「精度の重視」を意識して決定しました。 2段階目のベクトル検索では1段階目のベクトル検索結果に絞り込んでベクトル検索するため検索対象は1,000件に絞られています。 approximateNeighborsCount や fractionLeafNodesToSearch の値を大きくするとレイテンシの増加が懸念されます。一方でここでは検索対象数が絞られているためここでのレイテンシ悪化の懸念は少ないと考えました。そのため2段階目では再現率を重視して approximateNeighborsCount 、 fractionLeafNodesToSearch ともに十分大きな値を指定しました。具体的に指定した値は次の通りです。 フィールド 値 approximateNeighborsCount 1,000 fractionLeafNodesToSearch 0.99 setNeighborCount 60 このように決めた値でベクトル検索クエリを実行し、レイテンシの観点で目標を満たせることを確認しました。またベクトル検索結果について定性的に満足できる結果が得られることも確認しました。開発スケジュールが厳しかったこともあり、厳密な比較調整などのチューニングは行わず上記の値で運用を開始しました。 クエリ実行時に指定可能なパラメータとパフォーマンス影響については、公式ドキュメントの パフォーマンスに影響するクエリ時間の設定 で説明されているため合わせてご参照ください。 Index構成時に指定しているパラメータ Indexの構成パラメータのうち、前節( クエリ実行時に上書きしているパラメータ )で説明したパラメータ以外はIndex作成後の変更はできません。これらの値を変更する場合はIndexの再作成が必要です。 次のパラメータはIndex作成時に確定するパラメータです。これらのパラメータについて本システムでの値の決め方を説明します。 フィールド 説明 dimensions 入力ベクトルの次元数 ShardSize 各シャードのサイズ leafNodeEmbeddingCount 各リーフノードに対するEmbeddingの数 distanceMeasureType 最近傍探索で使用される距離尺度 featureNormType 各ベクトルに対して実行される正規化のタイプ dimensions は入力ベクトルの次元数を指定するパラメータです。Embeddingの次元数を元に値を決定します。本システムではGNNモデルで抽出したEmbeddingの次元数は256次元であるため256を指定しました。 ShardSize は次の3種類から選択できます。 種類 説明 SHARD_SIZE_SMALL シャードあたり 2 GiB SHARD_SIZE_MEDIUM シャードあたり 20 GiB SHARD_SIZE_LARGE シャードあたり 50 GiB ShardSize は各ノード上のデータ量を制御するパラメータです。本システムでは SHARD_SIZE_MEDIUM を選択しました。本システムでのシャードサイズの決定方法については後節( Indexサイズの見積もりとシャードサイズの決定 )で別途詳細に説明します。 leafNodeEmbeddingCount は各リーフノードのEmbeddingの数を指定するパラメータです。前節( ScaNNアルゴリズムの概要 )で説明したパーティショニング数に関わります。値の大小は再現率とレイテンシ間のトレードオフになります。値を大きくするほど検索対象が減りレイテンシは短くなる一方で再現率は低下します。公式ドキュメント( パフォーマンスに影響する構成パラメータ )では、ほとんどのユースケースで値が15,000を超えない限りレイテンシは短くなると説明されています。本システムではレイテンシを優先して15,000を指定しました。 leafNodeEmbeddingCount については、パラメータ値を決定する前にダミーで100としていたところクエリ実行に数秒かかる問題がありました。15,000に変更したところクエリ実行の時間は数10ミリ秒に改善しました。Index内のEmbedding数が多い場合は注意して leafNodeEmbeddingCount の値を決定することをおすすめします。 distanceMeasureType と featureNormType は公式ドキュメント( インデックス構成パラメータ )での推奨値に従い DOT_PRODUCT_DISTANCE + UNIT_L2_NORM を指定しました。以上をまとめると本システムでのIndex構成時に指定しているパラメータ値は次の通りです。 フィールド 値 dimensions 256 ShardSize SHARD_SIZE_MEDIUM leafNodeEmbeddingCount 15,000 distanceMeasureType DOT_PRODUCT_DISTANCE featureNormType UNIT_L2_NORM Indexサイズの見積もりとシャードサイズの決定 Index構成パラメータのうち、 ShardSize は各ノード上のデータ量を制御するパラメータであり、指定した ShardSize ごとにサポートされるデータサイズが決まっています。シャード数は指定した ShardSize とIndexのサイズに応じて自動で決定されます。 ShardSize はIndex作成後に変更できないため、事前に値の見積もりが必要です。またVertex AI Vector Searchの合計ノード台数は シャード数xレプリカ数 で決まるため、 ShardSize の見積もりは費用にも大きく影響します。 最適な ShardSize を選択するために、作成するIndexサイズの確認が必要です。一方で作成したIndexのサイズを直接的に確認する方法はないため概算します。 Indexのサイズは次式で概算しました。ここで式に含まれるRestrictsはEmbeddingデータに属性情報を付与するためのフィールドであり、ベクトル検索時のフィルタリングに利用できます。本システムでは2段階目のベクトル検索クエリ実行時、検索対象を1段階目のベクトル検索結果へ絞り込むためにフィルタリングを利用しています。Restrictsについては後節( フィルタリングの実装 )で詳しく説明します。 Indexサイズ(Bytes) = Embedding数 × [(次元数 × 1次元あたりのサイズ) + Restrictsのサイズ] ScaNNアルゴリズムではEmbeddingを圧縮しますが、 ShardSize の見積もりにあたっては圧縮後のサイズではなく、圧縮前のサイズを元に計算する必要があることに注意してください。 本システムではEmbedding数は約1,400万件、次元数は256次元、1次元あたりのサイズは4 Bytes(float32)です。Embeddingデータのサイズは 14,000,000 × (256 × 4) で計算でき、約13.35 GiBとなります。RestrictsのサイズをIndexのサイズに対して約15%と見積もるとIndexの全体サイズは約15.35 GiBと概算できました。概算のためRestrictsのサイズは大きめに見積もりました。 Indexの全体サイズが15.35 GiBである場合、 SHARD_SIZE_SMALL と SHARD_SIZE_MEDIUM の2種類のシャードサイズでは必要なシャード数は次のように見積もりできます。 種類 サポートされるサイズ シャード数の見積もり SHARD_SIZE_SMALL シャードあたり 2 GiB 8~9 SHARD_SIZE_MEDIUM シャードあたり 20 GiB 1 上記のEmbedding数でシャードサイズに SHARD_SIZE_SMALL を選択すると実際のシャード数は8となりました。前述の通りIndexのサイズを直接確認する方法はないため、実際に構成するまではシャード数の見積もりの妥当性を厳密に確認できません。一方で見積もりと実際の値の誤差が2 GiB程度で一致したことから、概算値の妥当性はある程度担保されていると判断できます。そのため実際にIndexを作成し、シャードサイズを変更して確認せずともシャードサイズを決定できます。 シャードサイズとシャード数の大小は再現率とレイテンシ間のトレードオフになります。シャードサイズが小さいほどシャード数は増え再現率を向上しますがレイテンシを悪化させます。シャードサイズが大きいほどシャード数は減りレイテンシを改善しますが再現率を低下させます。本システムではレイテンシを優先して SHARD_SIZE_MEDIUM を選択しました。 Indexのデプロイに使用できるマシンタイプは ShardSize によって異なります。例えば e2-standard-2 マシンタイプは SHARD_SIZE_SMALL のシャードサイズでのみ利用可能です。 SHARD_SIZE_MEDIUM を選択した場合に利用できる最も安価なマシンタイプは e2-standard-16 になります。 マシンタイプ SHARD_SIZE_SMALL SHARD_SIZE_MEDIUM SHARD_SIZE_LARGE n1-standard-16 ◯ ◯ × n1-standard-32 ◯ ◯ ◯ e2-standard-2 ◯ × × e2-standard-16 ◯ ◯ × e2-highmem-16 ◯ ◯ ◯ n2d-standard-32 ◯ ◯ ◯ 本システムのIndexサイズを元に、 SHARD_SIZE_SMALL を選択した場合と SHARD_SIZE_MEDIUM を選択した場合の費用を比較すると次の通りです。計算に当たってはそれぞれの ShardSize ごとに使用できる最も安価なマシンタイプで比較しています。リージョンは asia-northeast1 を想定しており、マシンタイプの費用は 公式ドキュメント の2025年7月時点の価格を元に計算しています。レプリカ数は本システムでの最小レプリカ数である2を想定しています。 種類 シャード数 マシンタイプ 1ノード時間あたりの費用(USD) ノード台数(シャード数 × レプリカ数) 月額費用(USD) SHARD_SIZE_SMALL 8 e2-standard-2 0.12 16 1382.4 SHARD_SIZE_MEDIUM 1 e2-standard-16 0.963 2 1386.72 計算例では、 SHARD_SIZE_SMALL を選択して小さなマシンを利用するのと SHARD_SIZE_MEDIUM を選択し、より大きなマシンを利用するのでは費用に大きな差はないことがわかります。 SHARD_SIZE_SMALL の場合、リリース後の早い段階でEmbedding数が増えてシャード数が9になる可能性もあります。シャード数9だと SHARD_SIZE_SMALL の場合は SHARD_SIZE_MEDIUM と比較して若干費用が高くなります。このように費用観点でも SHARD_SIZE_MEDIUM を選択することが妥当であると判断しました。 ShardSize の選択時は今後のEmbedding数の増加も考慮に入れるなど、システム要件に応じて値を選定することをおすすめします。 シャードサイズについては公式ドキュメントの インデックスの管理 も合わせてご参照ください。 Indexのデプロイ戦略とEmbeddingの更新・削除方法 本番システムの運用観点においてIndexのデプロイ・リリース管理をどのように行うか、Indexの更新・削除時はどのようなフローで行うのか、ダウンタイムはあるのかは重要なポイントとして考慮しています。関連コーデレコメンドでもVertex AI Vector Searchを利用してシステムを構成する際にこれらのポイントには注意しました。 本節では関連コーデレコメンドのシステムにおけるIndexのデプロイ戦略の紹介と、Indexの更新・削除の実装時の注意点について説明します。 Indexのデプロイ戦略 本システムにおけるIndexのリリースフローをご説明します。 前節( Index Endpointの作成とIndexのデプロイ )での説明の通り本システムでは、Indexのデプロイ先となるIndex EndpointをTerraformで作成しています。Index Endpointの作成後は、Vertex AI Pipelinesを利用してIndexをデプロイします。 IndexのデプロイはTerraformの google_vertex_ai_index_endpoint_deployed_index リソースでも可能です。一方で本システムでは新規にIndexを作成する場合、Indexの作成とデプロイの作業を分けない方が開発者の手間が少ないと考えました。そのためIndexの作成とデプロイはどちらもVertex AI Pipelinesで行う構成にしました。 ただ実際運用してみると、Indexのデプロイに関してはVertex AI Pipelinesで行ってもTerraformで行っても運用上大きな違いはないと感じています。大切なのはIndexのデプロイ時には先のシャードサイズとマシンタイプ、シャード数とレプリカ数など、Indexの構成パラメータとインフラの設定が密接に関わるものがある点について理解することだと思います。例えばIndexを作成するチームとデプロイを担当するインフラチームが分かれている場合は、Index作成とデプロイについてお互いの棲み分けや連携についての認識合わせが重要と感じました。 本システムにおけるIndexのリリースフローは次図で表せます。 Vertex AI Vector Searchでのベクトル検索クエリはMLOpsブロックで開発・運用するアプリケーションAPIから実行しています。アプリケーションAPIはGKE上で動作しており、コンテナの環境変数でクエリ実行先のIndex Endpoint、Indexを指定しています。 MLOpsブロックでは、GKE上で動作するAPIのデプロイをKubernetes向けのGitOpsデリバリーツールである Argo CD で行っています。また高度なデプロイ戦略の実現のため、Kubernetesのカナリアリリースやブルーグリーンデプロイメントをサポートするツールである Argo Rollouts を利用しています。 Argo Rolloutsではこれらのデプロイ戦略に加えてAPIのSLO分析を組み合わせた段階的なリリース・自動ロールバックの仕組みを提供しています。このようなデプロイ手法をプログレッシブデリバリーと呼びます。アプリケーションAPIのデプロイはArgo CDで管理されており、Argo Rolloutsを利用してプログレッシブデリバリーを実現しています。 アプリケーションAPIのメトリクスは Datadog で収集しています。Argo RolloutsのSLO分析にはDatadogのメトリクスを利用しています。エラーレートやレイテンシのSLOを設定し、これらのSLOを満たさない場合は自動でロールバックするよう設定しています。 MLOpsブロックで利用するArgo CDの詳細は、TECH BLOGの「MLOpsマルチテナントクラスタへのArgo CDの導入と運用」をご参照ください。 techblog.zozo.com 本システムの構成では新規にIndexをデプロイした場合、アプリケーションAPIの環境変数でクエリ実行先のIndexを変更します。この作業を挟むことで、Index新規デプロイ時の安全性はアプリケーションAPIのプログレッシブデリバリーにより担保しています。 また新規にIndexをデプロイした後で参照されなくなったデプロイ済みIndexは不要な費用を防ぐため、デプロイを解除します。図では省略していますがこの作業は手動で行っています。 Indexの更新・削除 Indexの更新方法 本システムではVertex AI PipelinesのタスクでIndexを更新します。本番環境では最新のIndexではなく過去に作成したIndexを更新したいケースはないと考え、更新対象は作成日が最も新しいIndexとしました。 from google.api_core.client_options import ClientOptions from google.cloud.aiplatform_v1 import IndexServiceClient, ListIndexesRequest from google.cloud.aiplatform_v1.services.index_service import pagers from google.cloud.aiplatform_v1.types import Index from google.cloud.aiplatform.matching_engine import MatchingEngineIndex location = "asia-northeast1" project_id = "<YOUR_PROJECT_ID>" target_index_display_name = "<YOUR_TARGET_INDEX_DISPLAY_NAME>" option = ClientOptions(api_endpoint=f "{location}-aiplatform.googleapis.com" ) client = IndexServiceClient(client_options=option) parent = f "projects/{project_id}/locations/{location}" filter = f 'display_name="{target_index_display_name}"' request = ListIndexesRequest(parent=parent, filter = filter ) page_result: pagers.ListIndexesPager = client.list_indexes(request=request) latest_index: Index = sorted (page_result, key= lambda i: i.create_time, reverse= True )[ 0 ] index_name = latest_index.name index = MatchingEngineIndex(index_name=index_name) gcs_uri = str (contents_delta_jsonl_dir).replace( "/gcs/" , "gs://" ) index.update_embeddings( contents_delta_uri=gcs_uri, is_complete_overwrite=is_complete_overwrite, ) 本システムではIndex更新方法としてバッチ更新を利用しています。バッチ更新の場合は MatchingEngineIndex.update_embeddings メソッドを利用してIndexを更新します。更新時に指定するソースデータはIndex作成時のソースデータと同じ形式で用意し、 contents_delta_uri 引数で指定します。 is_complete_overwrite 引数は更新時にIndex全体を上書きするかどうかを指定するものです。本システムではIndex全体を更新分で置き換えたい訳ではなく、部分的にIndexを更新するため常に False を指定しています。 ソースデータに含まれるデータポイントのidが既にIndexに存在する場合は新しいEmbeddingデータで上書きされます。ソースデータに含まれるデータポイントのidがIndexに存在しない場合は新規に追加されます。 Indexの更新後はIndexが自動で再構築(圧縮)され、再構築中は増分Indexが作成されます。増分Indexが存在する間は、更新後にコンソールから確認できるIndexの密ベクトル数が実際にIndexに含まれるid数より多くなることがあります。また増分Indexが存在する間はベクトル検索クエリ実行時に増分Indexが優先的に参照されるため、この間も新規更新したEmbeddingを使ってベクトル検索します。 デプロイ済みのIndexを更新する場合はIndexの更新後に同期が必要です。基本的にバックグラウンドで自動同期されますが、更新から同期の完了までは若干のラグがあることに注意が必要です。コンソールから確認できるデプロイ済みIndexの 前回の同期 の値はEmbeddingの更新に関わらず定期的に更新されます。ドキュメント等に明記はなかったため手元で確認した値にはなりますが、この値は5分間隔で更新されていました。そのため経験的にはIndex更新の完了後5分以内に同期が完了します。 デプロイ済みIndexを更新する場合、更新や再構築、同期の間にダウンタイムはありません。 Indexの更新に関する詳細は公式ドキュメントの アクティブ インデックスの更新と再構築 をご参照ください。 Indexの削除方法 Index内のEmbeddingデータを削除する場合は、Indexのバッチ更新と同じく MatchingEngineIndex.update_embeddings メソッドを呼び出します。データ更新と異なる点は contents_delta_uri 引数でソースデータに指定するフォルダの構成です。指定先のフォルダ内に delete という名前でサブディレクトリを作成し、削除対象のデータポイントのidを指定したテキストファイルを配置します。 batch_root/ delete/ delete_file.txt テキストファイルには次の例のように各行に1つのidを指定します。 1 2 Indexの更新と削除は一度の MatchingEngineIndex.update_embeddings メソッドの呼び出しで同時に行えないことに注意してください。指定したフォルダ内にEmbedding更新用のファイルと delete サブディレクトリ内に削除用のファイルの両方が存在する場合、Indexデータの削除が行われないという事態がありました。Indexの更新と削除を別々の処理として実装することで解消できたため、本システムでは処理を分けています。 ベクトル検索クエリ実行とフィルタリングの実装 クエリ実行の実装 Python Vertex AI SDKとcurlコマンドでのベクトル検索クエリ実行の方法は公式ドキュメント( パブリック インデックスをクエリして最近傍を取得する )に記載されています。公式ドキュメントだけでなくGoogle CloudのVertex AI Vector Searchのコンソールでも grpc_cli とPythonでの実装例が用意されています。コンソールのPython実装例はVertex AI Pythonクライアントライブラリを利用した実装になっています。 Vertex AI SDKはクライアントライブラリよりも高い抽象化レベルで動作します。より高い柔軟性や制御等のチューニングが必要な場合はVertex AI Pythonクライアントライブラリの利用も検討できます。 本システムのアプリケーションAPIはWEARのバックエンドAPIからのリクエストを受けて、Vertex AI Vector SearchやDBへアクセスする役割を担います。これらのVertex AI Vector SearchやDBへのリクエストはI/Oバウンドな処理であり、I/O待ちの間に他の処理を非同期に実行することでAPIのパフォーマンスを向上できます。 アプリケーションAPIの実装にはPythonのWebフレームワークである Fast API を利用しており、エンドポイントの定義であるPath Operationに渡す関数は async def として定義しています。Fast APIではこの関数を async def で定義することで イベントループ を利用した非同期処理が可能になります。一方で関数を def で定義するとスレッドプールを利用した並列処理を行います。イベントループを使った方法はスレッドプールを使った方法よりも高い並行性を持ちます。 Path Operationに渡す関数を async def で定義する際の注意点として、関数内に同期処理があるとイベントループがブロックされてしまいパフォーマンスの低下につながります。そのため async def で関数を定義し効率的に並行処理するには、関数内の重たい同期処理やI/O待ちのある処理を全て非同期処理にします。 Vertex AI Vector Searchでのベクトル検索クエリ実行について、Python Vertex AI SDKで用意されているクライアントは非同期処理に対応していません。ベクトル検索クエリを非同期に実行するため、本システムではVertex AI Pythonクライアントライブラリで非同期処理に対応したクライアントを指定して実装しました。 上述したコンソールのPython実装例を非同期処理に対応させると次のようになります。注意点として、 grpc.insecure_channel や grpc.aio.insecure_channel は通信を暗号化しません。そのため実際の実装では grpc.aio.secure_channel を利用して通信を暗号化することを推奨します。 import grpc from google.cloud.aiplatform_v1beta1 import MatchServiceAsyncClient from google.cloud.aiplatform_v1beta1.services.match_service.transports.grpc_asyncio import ( MatchServiceGrpcAsyncIOTransport, ) index_endpoint_ip_port = "<YOUR_gRPC_ADDRESS>:10000" channel = grpc.aio.insecure_channel(target=index_endpoint_ip_port) transport = MatchServiceGrpcAsyncIOTransport(channel=channel) client = MatchServiceAsyncClient(transport=transport) ベクトル検索クエリ実行の実装例は次です。 from collections.abc import MutableSequence from google.cloud.aiplatform.matching_engine import MatchingEngineIndexEndpoint from google.cloud.aiplatform_v1.types import ( FindNeighborsRequest, FindNeighborsResponse, IndexDatapoint, ) feature_vector: list [ float ] = [ 0.1 , 0.2 , 0.3 , ...] # クエリに使用するベクトル(※ 実際の値に置き換えてください) neighbor_count: int = 1000 # 取得する近傍の数 approximate_neighbor_count: int = 10000 # 近似探索で取得する近傍の数 fraction_leaf_nodes_to_search: float = 0.05 # 検索するリーフノードの割合 index_endpoint_name = ( "projects/<YOUR_PROJECT_NAME>/locations/asia-northeast1/indexEndpoints/<YOUR_INDEX_ENDPOINT_ID>" ) deployed_index_id = "<YOUR_DEPLOYED_INDEX_ID>" # デプロイ済みIndexのid datapoint = IndexDatapoint( feature_vector=feature_vector, ) vector_search_endpoint = MatchingEngineIndexEndpoint( index_endpoint_name=index_endpoint_name, ) query = FindNeighborsRequest.Query( datapoint=datapoint, neighbor_count=neighbor_count, approximate_neighbor_count=approximate_neighbor_count, fraction_leaf_nodes_to_search_override=fraction_leaf_nodes_to_search, ) find_neighbors_req = FindNeighborsRequest( index_endpoint=index_endpoint_name, deployed_index_id=deployed_index_id, queries=[query], return_full_datapoint= False , ) res: FindNeighborsResponse = await client.find_neighbors( request=find_neighbors_req, ) neighbors: MutableSequence[FindNeighborsResponse.NearestNeighbors] = ( res.nearest_neighbors ) 先の方法で初期化したクライアントの find_neighbors メソッドを呼び出すことでベクトル検索リクエストを実行できます。ここで find_neighbors メソッドは非同期メソッドであり、 await を付けて呼び出すことでベクトル検索リクエストを非同期に実行できます。 find_neighbors メソッドの引数の request 引数に FindNeighborsRequest クラス のオブジェクトを渡すことで、ベクトル検索先やクエリ実行のパラメータを指定できます。また記載は省いていますが、 timeout 引数や retry 引数を指定することでタイムアウトやリトライの設定も可能です。 クエリ実行対象のIndex Endpointとデプロイ済みIndexは FindNeighborsRequest クラスの初期化時に指定します。 index_endpoint 引数でIndex Endpointのリソース名を、 deployed_index_id 引数でデプロイ済みIndexのidを指定します。 queries 引数に FindNeighborsRequest.Query クラスのオブジェクトを要素として持つ配列を渡してベクトル検索クエリの内容を指定します。 queries 引数の値は配列であり、要素が複数ある場合はクエリを同時に指定できます。本システムでは特に ハイブリッド検索 は利用していないためクエリは1つ指定しています。また return_full_datapoint 引数でベクトル検索結果のデータポイントが持つ全ての情報を返すかどうかを指定できます。 return_full_datapoint 引数の値を True にした場合、データポイントのidだけでなく、Embeddingや restricts フィールドの値も返します。本システムではデータポイントのidのみがあれば十分であり、レスポンスサイズを小さくするために False を指定しています。 FindNeighborsRequest.Query クラスの初期化時、 datapoint 引数に IndexDatapoint クラス のオブジェクトを渡すことでベクトル検索の対象を指定します。クエリ実行時の入力にはEmbeddingだけでなく、Indexに含まれるデータポイントのidも指定できます。本システムではデータポイントのidとしてコーディネートのidを利用しています。アプリケーションAPIはWEARのバックエンドAPIからコーディネートのidを受け取り、そのまま IndexDatapoint の datapoint_id フィールドに指定してクエリ実行しています。また IndexDatapoint クラスには restricts フィールドも指定可能です。こちらは後節( フィルタリングの実装 )で詳しく説明します。 上記の例ではクエリ実行時の入力にEmbeddingを使用する実装例ですが、データポイントのidを指定する場合は次のように IndexDatapoint オブジェクトを作成できます。 datapoint_id= "1234" datapoint = IndexDatapoint( datapoint_id=datapoint_id ) 前節( クエリ実行時に上書きしているパラメータ )での説明の通り、 approximateNeighborsCount ・ fractionLeafNodesToSearch ・ setNeighborCount の値はクエリ実行時に上書きし、Index作成時の指定値を変更しています。これらの値は FindNeighborsRequest.Query クラスの初期化時に指定します。 フィルタリングの実装 Vertex AI Vector SearchではIndexのデータポイントへ属性情報を付与する restricts フィールドを利用して、ベクトル検索クエリの対象をIndexのサブセットに制限できます。 前節( 2段階のベクトル検索 )で説明した通り、本システムでは2段階にベクトル検索をします。 restricts フィールドを利用することで、2段階目のベクトル検索クエリ実行時に、検索対象を1段階目のベクトル検索で取得したサブセットに制限しています。 restricts フィールドを指定する場合、名前空間( namespace フィールド)の指定が必要です。またオプションとしてトークン( allow ・ deny フィールドの値)を指定できます。トークンの値は文字列の配列になります。クエリ実行時に allow_list や deny_list を指定することで、トークンの値に応じて検索対象を制限できます。 前節( Index作成の実装 )で紹介したIndexソースデータのファイルの値に restricts フィールドを指定すると、次の例のデータ形式になります。 { " id ": " 1 ", " embedding ": [ 0.1 , 0.05 , 0.3 ] , " restricts ": [{ " namespace ": " snap_id ", " allow ": [ " 1 " ]}] } { " id ": " 2 ", " embedding ": [ 0.2 , 0.01 , 0.02 ] , " restricts ": [{ " namespace ": " snap_id ", " allow ": [ " 2 " ]}]} 前節( クエリ実行の実装 )に記載の通り、本システムではIndexのデータポイントのidとしてコーディネートのidを利用しています。フィルタリングには取得したデータポイントのidを指定するため、上記のように restricts フィールドのトークンの値にもコーディネートのidを利用しています。また allow ・ deny フィールドはオプションであるため、指定しない場合は空の配列になります。本システムでは allow フィールドのみを指定しています。 次に示すのは restricts フィールドを指定したベクトル検索クエリ実行における IndexDatapoint クラスのオブジェクトの初期化の例です。本システムの2段階目のベクトル検索クエリ実行では IndexDatapoint.Restriction クラスの引数に allow_list を指定し、クエリ実行の対象をサブセットに制限しています。つまり find_neighbors メソッド呼び出しの戻り値は allow_list に指定した値を持つデータポイントのみになります。 from google.cloud.aiplatform_v1.types import IndexDatapoint namespace = "snap_id" # 名前空間の指定 allow_list = [ "1" ] # 許可対象とする値の配列 datapoint = IndexDatapoint( feature_vector=feature_vector, restricts=[ IndexDatapoint.Restriction( namespace=namespace, allow_list=allow_list, ) ], ) また本システムでは1段階目のベクトル検索クエリ実行時にも restricts フィールドを活用しています。Vertex AI Vector Searchではデータポイントのidを指定してベクトル検索クエリを実行した場合、ベクトル検索結果には自身のデータポイントも含まれます。本システムでは1段階目のベクトル検索クエリ実行時にデータポイントのidを指定して近傍を取得しています。そのためデフォルトでは指定したデータポイントのidも find_neighbors メソッド呼び出しの戻り値に含まれます。本システムでは入力となるコーディネートの類似コーディネートを取得したいため、 find_neighbors メソッド呼び出しの戻り値に入力となるコーディネートのidを含めたくありません。入力したデータポイントのidを検索結果から除外するため、 IndexDatapoint.Restriction クラスの引数へ deny_list を指定しています。 from google.cloud.aiplatform_v1beta1.types import IndexDatapoint namespace = "snap_id" # 名前空間の指定 deny_list = [ "1" ] # 除外対象とする値の配列 datapoint = IndexDatapoint( datapoint_id=datapoint_id, restricts=[ IndexDatapoint.Restriction( namespace=namespace, deny_list=deny_list ) ], ) Restrictsの利用時に注意が必要なのは、Index作成時に指定する allow ・ deny フィールドとクエリ実行時に指定する allow_list ・ deny_list はそれぞれの組み合わせでフィルタリングされる点です。フィルタ条件と一致について次の例で説明します。この例は公式ドキュメント( ベクトル一致をフィルタする )での説明を元にしています。 例えば color 名前空間について、次の allow ・ deny フィールドを持つデータポイントがIndexに存在するとします。 A : { " id ": " A ", " embedding ": [ ... ]} B : { " id ": " B ", " embedding ": [ ... ] , " restricts ": [{ " namespace ": " color ", " allow ": [ " red " ] , " deny ": []}]} C : { " id ": " C ", " embedding ": [ ... ] , " restricts ": [{ " namespace ": " color ", " allow ": [ " blue " ] , " deny ": []}]} D : { " id ": " D ", " embedding ": [ ... ] , " restricts ": [{ " namespace ": " color ", " allow ": [ " orange " ] , " deny ": []}]} E : { " id ": " E ", " embedding ": [ ... ] , " restricts ": [{ " namespace ": " color ", " allow ": [ " red ", " blue " ] , " deny ": []}]} F : { " id ": " F ", " embedding ": [ ... ] , " restricts ": [{ " namespace ": " color ", " allow ": [ " red " ] , " deny ": [ " blue " ]}]} G : { " id ": " G ", " embedding ": [ ... ] , " restricts ": [{ " namespace ": " color ", " allow ": [ " red ", " blue " ] , " deny ": [ " blue " ]}]} # 実務上必要性が薄いケース H : { " id ": " H ", " embedding ": [ ... ] , " restricts ": [{ " namespace ": " color ", " allow ": [] , " deny ": [ " blue " ]}]} 上記をソースデータに持つIndexに対してクエリ実行時に指定する allow_list ・ deny_list のパターンとして次の例を考えます。 (1) {} # restricts の指定なし (2) { " namespace ": " color ", " allow_list ": [ " red " ] , " deny_list ": []} (3) { " namespace ": " color ", " allow_list ": [ " blue " ] , " deny_list ": []} (4) { " namespace ": " color ", " allow_list ": [ " orange " ] , " deny_list ": []} (5) { " namespace ": " color ", " allow_list ": [ " red ", " blue " ] , " deny_list ": []} (6) { " namespace ": " color ", " allow_list ": [ " red " ] , " deny_list ": [ " blue " ]} (7) { " namespace ": " color ", " allow_list ": [ " red ", " blue " ] , " deny_list ": [ " blue " ]} # 実務上必要性が薄いケース (8) { " namespace ": " color ", " allow_list ": [] , " deny_list ": [ " blue " ]} この時、データポイントの allow ・ deny フィールドとクエリ実行時に指定する allow_list ・ deny_list の組み合わせによるフィルタリング結果は次になります。◯は条件が一致しデータポイントを取得できる組み合わせです。空欄は条件が一致せずデータポイントを取得できない組み合わせを表しています。 A B C D E F G H (1) ◯ ◯ ◯ ◯ ◯ ◯ ◯ ◯ (2) ◯ ◯ ◯ ◯ (3) ◯ ◯ (4) ◯ (5) ◯ ◯ ◯ (6) ◯ ◯ (7) ◯ (8) ◯ ◯ ◯ ◯ ◯ 本システムではデータポイントの作成時、 allow フィールドに1つのトークンの値を持たせているため、上記の例ではデータポイント B~D のパターンに該当するデータポイントがIndexに存在します。 1段階目のクエリ実行では入力となるコーディネートのidを除外するように deny_list を指定しており、これは上記の例ではクエリの (8) に該当します。 (8)とB~D で一致を見ると (8)とC 以外の組み合わせで一致することがわかります。また2段階目のクエリ実行では1段階目のベクトル検索で取得した複数のデータポイントのidを allow_list に指定しており、上記の例ではクエリの (5) に該当します。 (5)とB~D で一致を見ると (5)とB 、 (5)とC の組み合わせで一致することがわかります。 このようにデータポイントの restricts フィールドの allow ・ deny フィールドとクエリ実行時に指定する allow_list ・ deny_list の組み合わせで複雑な条件でのフィルタリングが可能です。一方で本システムのような簡単なクエリであればデータポイントに持たせるのは allow フィールドのみで十分です。ユースケースによって指定するフィールドを使い分けつつ、上記のような表でフィルタリング対象が意図したものになるか確認することをおすすめします。 Vertex AI Vector Searchの本番運用と課題の改善 モニタリング運用 Vertex AI Vector Searchではメトリクスダッシュボードがデフォルトで提供されており、ダッシュボードでは次のメトリクスを確認できます。 ノード数 シャード数 秒間クエリ数 レイテンシ(50・95・99%tile) CPU使用率 メモリ使用率 次に示すのは実際のダッシュボードの画面です。 本システムでは現状、Vertex AI Vector Searchのメトリクスを対象としたアラートの設定は行なっていません。アプリケーションAPIやLoad Balancer、Datadogのメトリクスはモニタリング・アラートを設定しています。Vertex AI Vector Searchのメトリクスダッシュボードはこれらのモニタリングで異常があった場合の調査手段として参照しています。 現状上記のモニタリング運用で特に困った点はありません。今後の運用でVertex AI Vector Search単体でのメトリクス悪化を検知したいケースなど出た場合は、Vertex AI Vector Searchのみの監視やアラートの設定を検討します。 運用して感じたメリット 関連コーデレコメンドでVertex AI Vector Searchを約4か月間、本番運用して感じた利用メリットを紹介します。 運用・保守の容易さ 前節( Vertex AI Vector Searchの導入モチベーション )でVertex AI Vector Searchの採用理由としてマネージドサービスであることを挙げていました。マネージドサービスであるためリリース後に必要な運用・保守作業は特になく、ユーザー側ではベクトル検索Indexの作成や更新、クエリ実行の実装に集中できています。 また 過去プロジェクトにおけるベクトル検索機能の実装 で述べたようなバッチとAPI間の依存もありません。前節( Indexのデプロイ戦略 )で述べたようにIndexのデプロイ戦略もシンプルな構成に実装できています。過去プロジェクトにおけるベクトル検索機能と比較するとシステム自体をシンプルにできた点も運用負荷の軽減につながりました。 安定したパフォーマンス 本システムをリリース後、Vertex AI Vector Search起因での問題はほとんど発生しておらず、安定したパフォーマンスを発揮しています。 本システムの平均リクエスト数は約15req/secでピーク時は約30req/secです。Vertex AI Vector Searchのベクトル検索リクエストのレイテンシは99%tileで約60〜120msであり、特にピーク時の大きなレイテンシ悪化も見られません。 Vertex AI Vector Searchはマネージドサービスであるため、ベクトル検索APIと同じGKEクラスタ内に自前でAPIを構築する場合と比較するとネットワーク的な距離は離れています。クエリ実行のレイテンシへネットワーク起因でのレイテンシ等が上乗せされることで、ベクトル検索リクエスト時のレイテンシを増加する可能性を懸念していましたが、結果として本プロジェクトの要件に対しては十分なパフォーマンスでした。 またマネージドサービスへのリクエスト時、timeoutエラーの発生が度々他システムで見られており、Vertex AI Vector Searchについても懸念していました。しかし本システムでのVertex AI Vector Searchへのリクエストではtimeoutエラーは1日1件発生するかどうかの頻度となっており安定しています。 関連コーデレコメンドプロジェクトの出面での負荷は比較的に規模が小さく、より高負荷な本番環境でのVertex AI Vector Searchの利用実績はまだMLOpsブロックでは作れていません。しかし負荷試験時には新規導入したVertex AI Vector Searchの負荷限界を把握するため、本番の想定トラフィックを大きく超える~200req/secまで検証しました。検証した範囲ではVertex AI Vector Searchのレイテンシに大きな変化は見られませんでした。こういった実績からも、今後より大規模なシステムでベクトル検索機能を構築する際にも十分選択肢になり得ると考えています。 運用して見つかった課題と改善 Vertex AI Vector Searchを利用した本システムを本番運用する中で次の課題が見つかりました。 Index更新にかかる時間が長い Index更新数が多いとデータ更新にかかる費用が増加する それぞれの課題と本システムで実施した改善内容を紹介します。 Indexの更新時間が長い 本システムでは日次でIndexの更新を行なっています。また前節( Indexの削除方法 )で述べた通り追加・更新と削除はタスクを分けて直列に実行しています。Indexの更新にかかる時間は追加・更新、削除を合わせると約2〜3時間となっており、パイプラインの全体の実行時間に対して約半分の割合を占めていました。 それぞれのタスクにかかる時間と更新数は次の通りです。参考までにIndex全体のデータ数は約1,400万件です。 追加・更新:1〜2時間 更新数:約3,500,000件 削除:約30〜40分 更新数:約30〜60件 本システムではインフラ構築にかかる費用やシステムの複雑性を抑えるため、APIでのリアルタイムなEmbedding抽出は行なっていません。そのためバッチ処理で事前にEmbedding抽出されたユーザー・コーディネートのみを関連コーデレコメンドプロジェクトでのMLを使ったレコメンドの対象としています。この構成では新規ユーザー・コーディネートのEmbeddingをより早く抽出し、レコメンド対象とするにはバッチの実行頻度を上げる必要があります。またバッチの実行頻度を上げると、より直近の行動を反映したEmbeddingを使ってベクトル検索をできるためレコメンドのリアルタイム性も向上します。 本システムで高いリアルタイム性は要求されていませんが、今後バッチの実行頻度を増やしてリアルタイム性を向上させる場合、Indexの更新にかかる時間がボトルネックになることを懸念しました。 Indexのデータ更新費用の増加 Vertex AI Vector Searchの費用は主に次の2つの要素で構成されています。 インスタンスの費用 Index構築の費用 データ更新によるIndex構築の費用はIndexの更新時に処理されたデータの量に応じて課金されます。Vertex AI Vector Searchのバッチ更新では2025年7月現在、すべてのリージョンに一律で処理されたデータ量に対して$3.00/GiBが課金されます。費用については 公式ドキュメント で最新の情報を参照してください。 本システムでのIndex更新数は1日あたり3,500,000件であり、Vertex AI Vector SearchのIndex更新に伴うIndex構築の費用は1日あたり約$46となっていました。 asia-northeast1 リージョンで e2-standard-16 インスタンスをノード数2で利用した場合の1日あたりの費用は約$46となります。そのためIndex更新の費用はインスタンスの費用と同程度となっており、データ更新に伴う費用がベクトル検索機能の費用の半分近くを占めています。これは当初想定していたよりも大きな費用であり、問題になりました。 Indexのデータ更新費用の算出については混乱する部分があったため後節( Indexのデータ更新費用の見積もり )で別途説明します。 Embedding更新対象のデータ数を削減 本システムでは前節の運用課題に対してIndexの更新対象となるデータ数を減らすことで対応しました。更新対象となるデータ数を減らすことで次の改善が得られました。 Indexのデータ更新費用の大幅な削減 Index更新時間の短縮 前節( グラフニューラルネットワークモデルによるEmbeddingの抽出 )で述べた通り、本システムではGNNモデルを利用してEmbeddingを抽出しています。次に該当するユーザー・コーディネートをEmbedding抽出対象とし、Indexへ追加・更新していました。このうちデータ更新数の増加に大きく関係していたのは3のデータでした。 新規追加されたNode 自身に紐づくユーザー行動の変化があったNode 上記の更新対象に隣接するNode 2に該当するユーザー・コーディネートをアクティブなユーザー・コーディネートと表現します。3を更新対象とすることでアクティブなユーザー・コーディネートに紐づく非アクティブなユーザー・コーディネートも更新対象となります。特にアクティブなユーザー・コーディネートは隣接するNodeも多いため、結果として更新数の爆発的な増加へ繋がっていました。 3に該当するユーザー・コーディネートのEmbedding更新についてはレコメンドの精度にはそれほど大きく影響しないと考えました。更新対象のデータ数を減らすため3に該当するユーザー・コーディネートはEmbeddingの更新対象へ含めないよう変更しました。補足として非アクティブなユーザー・コーディネートについても、新規にユーザー行動があった場合には上記の2に該当するため、隣接Nodeとの関係性を考慮してEmbeddingを更新しています。変更の適用後もビジネスKPIに悪化は見られず、レコメンドの精度に大きく影響することなく更新数を低減できました。 削減前後のEmbedding更新数は次の通りです。 コーディネート 削減前:約3,500,000件 削減後:約150,000件 ユーザー 削減前:約2,000,000件 削減後:約10,000件 日によって更新数は変動しますが、更新対象のデータ数を大きく減らすことができました。コーディネートについては削減前に比べて約23分の1、ユーザーについては約200分の1のデータ更新数となりました。 抽出したユーザーのEmbeddingはGoogle CloudのサーバレスNoSQLドキュメントデータベースである Cloud Firestore に保存していました。更新対象のユーザーEmbeddingの件数も想定より多かったためCloud Firestoreの書き込み費用も課題となっていました。更新対象のデータ数を削減したことにより、Vertex AI Vector Search、Cloud Firestoreのデータ更新費用は対応以前と比較して8割以上削減できています。 またIndex更新対象のデータ数が大きく減ったことで、Indexの更新にかかる時間も大きく短縮されました。データ更新時に約1〜2時間かかっていたIndexの更新時間は約40分に短縮できました。データ処理対象の件数が減ったことでパイプライン内のIndexの更新以外のタスクの実行時間も短縮され、パイプライン全体の実行時間は約半分に短縮されました。 一方でIndexへのEmbeddingの追加・更新時の更新時間は更新データ削減対応後、Embeddingの削除時の更新時間と同程度まで短縮できました。約30〜60件しか更新対象のデータ数がない削除時と同程度まで短縮できたことを鑑みて、さらに更新対象のデータ数を減らすことによる更新時間の短縮は効果が薄いと考えています。 バッチ更新時間の更なる短縮のためにはIndexの ストリーミング更新 の利用可能性があります。公式ドキュメントにはストリーミング更新を利用することで数秒以内にIndexを更新できると説明があります。 一方で既存のIndexではバッチ更新を利用しているため、ストリーミング更新を利用するにはIndexの再作成が必要となります。またストリーミング更新では更新リクエストの制限や割り当ての上限があるため、大規模なデータ更新には向かないという懸念があります。このような理由からストリーミング更新の利用は現時点では慎重に検討しています。 Indexのデータ更新費用の見積もり Vertex AI Vector Searchを本番運用する中で、自分が見積もりしていたIndexのデータ更新時の費用と Cloud Billing のコンソールで確認できる費用に乖離がありました。 前述の通りIndex構築の費用は2025年7月現在、 公式ドキュメント で次のように説明されています。 ベクトル検索では、すべてのリージョンにおいて、処理されたデータ 1 GiB あたり $3.00 が課金されます。 当初自分は 処理されたデータ を更新対象のデータと解釈していました。つまりIndex更新のデータソースとして指定したファイルに含まれるEmbeddingデータを課金対象と勘違いしていました。 Embedding更新対象のデータ数を削減する前のIndexの更新数は1日あたり約3,500,000件です。前節( Indexサイズの見積もりとシャードサイズの決定 )の式で更新分のデータ量を計算すると1日あたり約3.8GiBです。更新分のデータ量に対して課金された場合、1日あたり$11.4が費用となるはずです。しかし前節( Indexのデータ更新費用の増加 )で述べた通り、Cloud Billingで確認した費用は1日あたり約$46であり、更新分のデータ量での見積もり額よりも明らかに大きな金額です。 処理されたデータ を更新対象のデータだけでなく、既存のIndexに含まれるデータも含めたデータ全体を指すと考える場合、実際の費用と近い金額を算出できることに気がつきました。削減対応前では、データ更新数とIndexのデータ総数を合わせて約1,400万件でした。データ量は約15.35GiBであり、費用を算出すると約$46となるためCloud Billingで確認した費用に一致します。 しかしIndexデータ全体を課金対象と考えると、更新対象のデータ数を減らすことでIndexの更新に伴うIndex構築の費用を大きく削減できたことの説明がつきません。そこでIndexの圧縮による再構築で処理されたデータ量が費用に関係していると推測しました。バッチアップデートでのIndexの圧縮については 公式ドキュメント で次の説明があります。 増分データセット サイズが基本データセット サイズの 20% を超えるときに行われます。 削減前のIndexのデータ総数は約1,380万件であり、更新対象のデータ数は約350万件でした。350万件は1,380万件の約25%に相当します。更新対象のデータ数が20%を超えたことで、更新の度にIndexは圧縮により再構築され、データ全体を処理することで課金対象となったと考えました。削減後の更新対象のデータ数は約150,000件であり、1,380万件の約1%に相当します。更新対象のデータ数が20%を下回ったためIndexの圧縮による再構築はされず、処理されるデータ量が大きく減ったことで費用が減少したと推測しました。 次図は更新分のデータ量がIndexのデータ量の20%以上の場合に課金対象となるデータのイメージです。 次図は更新分のデータ量がIndexのデータ量の20%以下の場合に課金対象となるデータのイメージです。こちらは内部挙動を推測して作成したイメージであるため実際の挙動とは異なる可能性があります。 Cloud Billingで確認できた削減対応の前後でのIndex構築の費用の変化は次の通りです。 更新対象データを削減した7月7日以降に費用が大きく減っており、更新対象データ削減の効果が出ていることがわかります。しかし費用が大きく減った7月8日以降は費用が線形に増加しています。更新対象のデータ量はほぼ一定の値であるため、線形に増加するのは不自然だと感じました。また公式ドキュメントに記載の内容からこのような費用増加の説明は読み取れませんでした。そこでVertex AI Vector Searchの内部挙動を推測して、更新対象のデータ数が20%を下回る場合の費用見積もりの方法を考えました。 本節の以下の内容は、公式ドキュメントに記載のない内容を推測で補い、仮説立てした説明です。公式ドキュメントに記載の内容・実際の費用・データ量以外は推測であり、確実でないためご注意ください。 データ更新にかかるIndex構築費用の算出は本システムの運用の中で苦労した点であり、同様の課題を抱える方の参考になればと思い、記載しています。 更新対象データを削減した後で費用が大きく減ったこと、その後で線形増加したことを踏まえて、Indexは内部でパーティショニングされており更新時にパーティションデータを処理している可能性を推測しました。一般的に大量のデータを扱うシステムでは、一部のデータ更新でデータ全体を再構築せず、パーティションデータのみを更新することでパフォーマンスを向上させます。公式ドキュメント内での記載はないため、あくまでも推測ですが、Vertex AI Vector SearchでもIndexをパーティショニングしている可能性はあります。パーティションがIndex全体の20%を超えるまではパーティションデータを更新し、パーティションがIndex全体の20%を超える場合はIndex全体が圧縮されると推測しました。またパーティションデータの更新時は累積更新分とパーティション分のデータ量に対して課金されると推測する場合、削減後の費用の線形増加も説明できます。 次図は更新分のデータ量がIndexのデータ量の20%以下かつパーティションデータを更新する場合に課金対象となるデータのイメージです。こちらも内部挙動を推測して作成したイメージであるため実際の挙動とは異なる可能性があります。 以上の推測に基づいて、更新対象のデータ数がIndex全体の20%以下である場合のIndexのデータ更新費用は次の式で計算できると考えました。本システムのIndex構築費用の算出に次式を利用しています。 データサイズ(Bytes) = (パーティションの累積更新Embedding数(重複あり) + 更新前のパーティションのEmbedding数(重複なし)) × [(次元数 × 1次元あたりのサイズ) + Restrictsのサイズ] 公式ドキュメントに記載の費用とCloud Billingで確認できる費用以外の要素は推測であるため、上式での正確な費用の算出はできていません。実際のところ、過去のデータを用いて上式で計算した費用とCloud Billingで確認できる費用には10%前後のズレが出ています。しかし全体としての傾向は捉えられており、単に更新分のデータ量やIndex全体のデータ量を 処理されたデータ として見積もるよりも、実際の費用と近い値を計算できています。 費用の形態や課金の仕組みはサービス内部の仕様に依存するため、費用の傾向が変わる可能性はあります。そのため今後もVertex AI Vector SearchのIndex構築の費用は継続的に確認し、見積もりから大きくずれることがあれば見積もり方法の見直しを考えています。 まとめ 本記事ではWEAR関連コーデレコメンドプロジェクトへのVertex AI Vector Search導入と実践について紹介しました。実プロジェクトでの実装・運用経験を通じて得られた知見が、これからVertex AI Vector Searchの導入を検討している方の参考になれば幸いです。 今後はVertex AI Vector Searchの利用実績を増やし、より大規模なシステムでの利用経験を積んでいきたいと考えています。また、Vertex AI Vector Searchの新機能や改善点についても引き続き注目していきます。 ZOZOでは、一緒にサービスを作り上げてくれる方を募集中です。MLOpsブロックでも絶賛採用を行っているため、ご興味ある方は以下のリンクからぜひご応募ください。 corp.zozo.com
ZOZO開発組織の2025年7月分の活動を振り返り、ZOZO TECH BLOGで公開した記事や登壇・掲載情報などをまとめたMonthly Tech Reportをお届けします。 ZOZO TECH BLOG 2025年7月は、前月のMonthly Tech Reportを含む計5本の記事を公開しました。特に注目を集めていた「開発生産性Conference 2025」の参加レポート記事は多くの方に読まれています。 techblog.zozo.com 登壇 WWDC25 Recap - Japan-(region).swift 7月6日に開催された「 WWDC25 Recap - Japan-region.swift 」に、FAANS部の加藤が「 動画エフェクトに関する新技術の紹介 」というタイトルで登壇しました。 SRE NEXT 2025 7月11日、12日に開催された「 SRE NEXT 2025 」のLTに計測システム部の土田が「 セキュアな社内Dify運用と外部連携の両立 ~AIによるAPIリスク評価~ 」というタイトルで登壇しました。 speakerdeck.com Data Engineering Study #30 7月18日に開催された「 Data Engineering Study #30 」にデータシステム部の塩崎が「 データ基盤の管理者からGoogle Cloud全体の管理者になっていた話 」というタイトルで登壇しました。 speakerdeck.com 掲載 開発AIエージェントを全エンジニアに導入 全エンジニアを対象に1人あたり月額200米ドルの基準のもと、開発AIエージェントの導入決定とあわせて、導入前の調査・検証と利用ガイドラインの作成をおこなうことで、社員がスムーズかつ安全に活用できるような体制を構築したことを発表しました。 corp.zozo.com この内容に関する記事が以下のメディアをはじめとして複数のメディアに掲載されました。 www.nikkei.com www.itmedia.co.jp codezine.jp 高精度身体計測サービスのZOZOMETRY、オーダーウエットスーツ製作に対応し、メーカー計4社へ導入が決定! 事業者向け計測業務効率化サービス「 ZOZOMETRY 」は、オーダーウエットスーツ製作に対応し、オーダーウエットスーツメーカー計4社での導入が決定したことを発表しました。 corp.zozo.com この内容に関する記事が「 日本ネット経済新聞 」に掲載されました。 netkeizai.com その他 2026年3月期 第1四半期 決算発表 7月31日に2026年3月期第1四半期決算を開示しました。詳細は以下のリンクにある開示資料をご確認ください。 corp.zozo.com 以上、2025年7月のZOZOの活動報告でした! ZOZOでは、一緒にサービスを作り上げてくれる方を募集中です。ご興味のある方は、以下のリンクからぜひご応募ください。 corp.zozo.com
こんにちは。一番好きなマジックナンバーは 0x5F3759DF 1 な、技術戦略部CTOブロックの塩崎です。 先日、当社から以下のプレスリリースを発表いたしました。その中でも書かれているように、1人あたり月額200ドルの基準のもと、Claude CodeやGemini CLIをはじめとした各種AI開発ツールを利用可能になりました。 corp.zozo.com この記事ではAI開発ツールの1つであるGemini CLIを全社で使えるようにするため、Google Cloud管理者として実施したことを紹介します。Gemini CLIやClaude Codeなどに関しては以下のような記事がよく目立ちますが、この記事にはそのような内容が書かれておりません。 俺が考えたベストのGemini CLI設定 Gemini CLIを使って効率を上げる10の方法 Gemini CLIで開発効率が〇〇%アップ むしろ、Gemini CLIを利用するプログラマではなく、Gemini CLIなどのツールを導入したいと相談を受けているシステム管理者向けの記事です。 Gemini CLIの認証方法について Gemini CLIを利用するためのGoogle Cloudプロジェクト 利用開始するための社内申請 利用費の集計 使いすぎ防止 GitHub ActionsでGemini CLIを実行する 全社統一プロジェクト以外でGemini CLIを利用していることの検知 Gemini CLIに脆弱性が報告されたときの影響範囲の調査 今後の展望 まとめ Gemini CLIの認証方法について Gemini CLIには複数の認証方法があり、どれを利用するかによって利用規約やプライバシーポリシーが変化します。そのため、全社導入にあたってどの認証方法を使うべきかを決める必要があります。 以下の表は認証方法毎の違いをまとめたものです。 No 認証方法 アカウント 入力が学習に使われるか 利用規約 プライバシーポリシー (1) Gemini Code Assist via Google 個人 使われる Google Terms of Service Gemini Code Assist Privacy Notice for Individuals (2) Gemini Code Assist via Google Google Workspaceまたは有料版Gemini Code Assist 使われない Google Cloud Platform Terms of Service Gemini Code Assist Privacy Notice for Standard and Enterprise (3) Gemini Developer API 無料 使われる Gemini API Terms of Service - Unpaid Services Google Privacy Policy (4) Gemini Developer API 有料 使われない Gemini API Terms of Service - Paid Services Google Privacy Policy (5) Vertex AI Gen API 使われない Google Cloud Platform Service Terms Google Cloud Privacy Notice 参考: GitHub - google-gemini/gemini-cli/docs/tos-privacy.md (1)と(3)はどちらも無料で利用できますが、入力が学習に利用されます。これらの認証方法はAIモデルを通した情報漏洩などの懸念があるため利用を禁止しています。また、(4)はこれ以降で説明するような費用管理や権限管理の仕組みを構築する上でやや難があったため、こちらも利用を禁止しています。 残りの認証方法は(2)と(5)ですが、今回は(5)を採用することにしました。(2)と(5)の主な違いは定額課金か従量課金という点です。定額課金にすると費用管理がしやすくなる一方で、サブスクリプションの購入などの契約面で時間を取られることも見込まれたため、運用初期は(5)の従量課金のみを採用しています。ゆくゆくは(2)の定額課金プランも対象とし、利用量に応じてどちらを使うべきかを見極めていく予定です。 これ以降では(5)のVertex AI Gen APIを認証方法として利用してGemini CLIを使うための方法を紹介していきます。 Gemini CLIを利用するためのGoogle Cloudプロジェクト Gemini CLIを利用するためにGoogle Cloudプロジェクトが必要なため、これをどうするかを考えます。部署ごとにプロジェクトを作成してもらうのか、全社統一で1つのプロジェクトを利用するのかという2つの方針が考えられます。今回は後者の全社統一で1つのプロジェクトを利用する方法を採りました。 以下の理由から全社統一プロジェクトにメリットがあると考えたためです。 各部署にプロジェクト作成をしてもらうよりも、統一プロジェクトにしたほうがGemini CLIの利用申請が簡素化される 各自の権限や費用などを中央集権的に管理できる 利用開始するための社内申請 Gemini CLIを利用するための社内申請にはGitHubを使うことにしました。まず、先ほど紹介したGoogle CloudプロジェクトにterraformでIaC(Infrastructure as Code)を導入しました。そして、マージをトリガーにしてterraform applyをGitHub Actionsから実行するようにしました。 まず、権限管理用のGitHubリポジトリには以下のようなGemini CLI利用者が列挙されているYAMLファイルを用意します。 - sato@example.com - suzuki@example.com - takahashi@example.com そして、このYAMLファイルを読み取ってリソースを作成するためのtfファイルも用意します。 resource "google_project_iam_member" "vertex-ai-user" { for_each = toset ( yamldecode ( file ( "$ { path.module } /users.yaml" ))) project = <プロジェクトID> member = format ( "user:%s" , each.value) role = "roles/aiplatform.user" } その後は、前述のYAMLファイルにGemini CLIを利用したいユーザーを追加してPRを作成すれば申請作業が完了します。 管理者側の権限を反映する作業も簡素化されており、GitHubでMergeボタンを押すのみで完了します。 利用費の集計 当社では開発AIエージェントを自由に使える制度がスタートしましたが、1人あたり月額200ドルという費用の目安があります。この金額を超過していないか確認するために、以下のような仕組みを使ってGemini CLIでどの程度の費用が発生したのかを集計しています。 課金情報と監査ログをBigQueryにexportし、それらを集計することで各個人の費用を集計しています。また、個人毎の費用情報と組織マスタを突き合わせて、部署毎の費用も確認できるようにしています。 課金情報をBigQueryにエクスポートするためには、以下のドキュメントに従って設定しています。 cloud.google.com 監査ログをBigQueryにエクスポートするための設定は以下のようにterraformで管理しています。Gemini CLI用のプロジェクトだけではなく、Organization内の全部のプロジェクトに対して監査ログをBigQueryにエクスポートする設定を入れています。 data "google_organization" "zozo-com" { domain = "zozo.com" } resource "google_organization_iam_audit_config" "zozo-com" { org_id = data.google_organization.zozo-com.org_id service = "allServices" audit_log_config { log_type = "ADMIN_READ" } audit_log_config { log_type = "DATA_READ" } audit_log_config { log_type = "DATA_WRITE" } } resource "google_logging_organization_sink" "audit_log_sink" { name = "audit_log_sink" org_id = data.google_organization.zozo-com.org_id destination = "bigquery.googleapis.com/$ { google_bigquery_dataset.audit_log.id } " include_children = true filter = "protoPayload.@type=\"type.googleapis.com/google.cloud.audit.AuditLog\"" } 参考: Terraform provider for Google Cloud - google_organization_iam_audit_config Terraform provider for Google Cloud - google_logging_organization_sink これらのデータをどのように集計しているのかも紹介します。 まずは以下のように課金情報から1時間毎の費用を集計します。この時にGeminiモデルもGROUP BY条件に入れています。 -- NOTE : 将来モデルが増えた場合に修正する create temporary function ski_id_to_model_name(sku_id string) as ( case sku_id when ' A121-E2B5-1418 ' then ' gemini-2.5-pro ' -- Gemini 2.5 Pro Text Input - Predictions when ' 5DA2-3F77-1CA5 ' then ' gemini-2.5-pro ' -- Gemini 2.5 Pro Text Output - Predictions when ' E367-697F-F274 ' then ' gemini-2.5-pro ' -- Gemini 2.5 Pro Thinking Text Output - Predictions when ' E941-1B12-88B9 ' then ' gemini-2.5-pro ' -- Gemini 2.5 Pro Input Text Caching when ' FDAB-647C-5A22 ' then ' gemini-2.5-flash ' -- Gemini 2.5 Flash GA Text Input - Predictions when ' AF56-1BF9-492A ' then ' gemini-2.5-flash ' -- Gemini 2.5 Flash GA Text Output - Predictions when ' A253-E8A3-DE5C ' then ' gemini-2.5-flash ' -- Gemini 2.5 Flash GA Thinking Text Output - Predictions when ' CD33-11F4-1220 ' then ' gemini-2.5-flash ' -- Gemini 2.5 Flash Ga Thinking Text Output - Predictions when ' A1C1-77CC-6FAE ' then ' gemini-2.5-flash ' -- Gemini 2.5 Flash GA Input Text Caching else " others " end ); with hourly_gemini_cost as ( select timestamp_trunc(usage_start_time, HOUR) as datetime_hour, sum (cost) as cost, ski_id_to_model_name(sku.id) as model_name, from <課金情報> where project.id = <Gemini CLI用プロジェクト> and service.description = ' Vertex AI ' group by all ) さらに、監査ログから各個人の1時間毎のAPIコール数を取得します。こちらも同様にGeminiモデル毎のコール数になるようにGROUP BY条件を設定しています。 with api_call_count as ( select timestamp_trunc( timestamp , HOUR) as datetime_hour, protopayload_auditlog.authenticationInfo.principalEmail as email, array_last(split(protopayload_auditlog.resourceName, ' / ' )) as model_name, count (*) as count , from 監査ログ where resource .labels.project_id = <Gemini CLI用プロジェクト> and resource .labels.service = ' aiplatform.googleapis.com ' and protopayload_auditlog.methodName in ( ' google.cloud.aiplatform.v1beta1.PredictionService.GenerateContent ' , ' google.cloud.aiplatform.v1beta1.PredictionService.StreamGenerateContent ' ) group by all ) そして上記の2つの情報を結合して各個人のコストを集計しています。各時間帯・Geminiモデル毎の費用を各個人のAPIコール数で按分して各個人の費用としています。厳密にはAPIコール数ではなくInput・Outputしたトークン数で按分しないと正しい値にはなりませんが、監査ログにトークン数が含まれていないため、APIコール数で近似しています。 with api_call_count_and_ratio as ( select datetime_hour, email, model_name, count , count / sum ( count ) over(partition by datetime_hour, model_name) as ratio, from api_call_count ), hourly_personal_cost as ( select datetime_hour, email, cost * ratio as personal_cost, from hourly_gemini_cost left join api_call_count_and_ratio using (datetime_hour, model_name) where email is not null ), daily_personal_cost as ( select date (datetime_hour, " Asia/Tokyo " ) as date_jst, email, sum (personal_cost) as personal_cost, from hourly_personal_cost group by all order by date_jst, email ) select * from daily_personal_cost さらに、この情報に組織図マスタを結合させて、組織毎の費用を集計しています。組織マスタはkintoneに格納されており、以下の記事で紹介している方法でBigQueryから読み出しできるようにしています。 techblog.zozo.com これらの集計値はGoogle SpreadsheetとBigQueryの連携機能を使い、結果を毎日Spreadsheetに出力しています。 support.google.com 使いすぎ防止 定期的な集計をしているとはいえ、利用者全員が毎日の集計結果を見るわけではありません。そのため、過度な利用があった場合にSlackなどに通知をしたり、権限を一時的に削除してこれ以上の使いすぎを防止する仕組みも必要です。そのような仕組みもGemini CLIの全社展開のために作成したので紹介します。 この仕組みを構築するうえで大事なことは情報の鮮度です。大量の費用が短時間で発生した場合にも迅速に対応するためには鮮度が大事です。先ほど紹介した費用集計の方法ですと、監査ログは十分な鮮度を持っていますが、課金情報の鮮度が低いため、そのまま使うことはできません。 そのために、代わりにCloud Monitoringから取得できる以下のメトリクスを利用します。このメトリクスでLLMモデルにInput・Outputされたトークンの数を取得できます。 aiplatform.googleapis.com/publisher/online_serving/token_count cloud.google.com また、以下のフィールドを group_by_fields に指定します。 フィールド名 格納されている情報 metric.label.type InputかOutputか resource.label.model_user_id モデル名 そして、ここで取得した情報とモデル毎の単価情報を合わせて、1時間毎の費用を取得しています。 def get_hourly_token_usage (project_id: str ): client = MetricServiceClient() project_name = f "projects/{project_id}" now = datetime.now(timezone.utc).replace(minute= 0 , second= 0 , microsecond= 0 ) start_time = now - timedelta(days= 3 ) interval = TimeInterval(start_time=start_time, end_time=now) filter_str = 'metric.type = "aiplatform.googleapis.com/publisher/online_serving/token_count"' aggregation = Aggregation( alignment_period={ "seconds" : 3600 }, # 1 hour per_series_aligner=Aggregation.Aligner.ALIGN_SUM, cross_series_reducer=Aggregation.Reducer.REDUCE_SUM, group_by_fields=[ "metric.label.type" , "resource.label.model_user_id" ], ) request = ListTimeSeriesRequest( name=project_name, filter =filter_str, interval=interval, view=ListTimeSeriesRequest.TimeSeriesView.FULL, aggregation=aggregation, ) hourly_data = defaultdict( list ) try : results = client.list_time_series(request) for result in results: token_type = result.metric.labels.get( "type" , "unknown" ) model_user_id = result.resource.labels.get( "model_user_id" , "unknown" ) for point in result.points: timestamp = point.interval.end_time.strftime( "%Y-%m-%d %H:%M:%S UTC" ) token_count = point.value.int64_value hourly_data[timestamp].append({ "token_type" : token_type, "model_user_id" : model_user_id, "token_count" : token_count, }) except Exception as e: print (f "An error occurred while processing: {e}" ) return なお、この方法で鮮度良く課金情報が取得できるなら先に紹介したCloud Billingの情報は不要なのではと考える方もいるかもしれません。しかし、実際のGeminiの課金の計算はより複雑なため、正確な費用を求めるためにはCloud Billingの情報が必要です。本章の仕組みは鮮度が良いですが、近似的な値になってしまいます。 費用を使いすぎてしまった場合の処理は、通知と権限削除の2種類を用意しています。通知処理は予算の80%を超過してしまった場合の処理です。Slackで該当のユーザーに予算額の80%に達した旨を通知します。 権限削除は予算金額の100%を超過してしまった場合の処理です。この処理では該当ユーザーのGemini CLIを利用する権限を削除します。通常のIAM権限(Allow policy)を削除してしまうと、最初に紹介したterraformが構成ドリフトを起こしてしまうため、Deny Policyに追加することで権限を削除しています。 cloud.google.com 1日あたりの予算金額はデフォルトでは10ドルにしてあり、月間では200ドルには達しない程度になっています。一時的に金額を引き上げたい場合には、以下のようなYAMLファイルを修正します。これらの設定値の調整をするための申請はGitHubでPRを投げてもらうことで実現しています。 # このファイルを修正すると1日あたりの予算上限を上書きできます。 # 書き換えた場合、月間の予算上限をオーバーしないように自力で管理してください。 # With great power comes great responsibility. - user : suzuki@example.com daily_budget_usd : 200 notify_threshold_in_percent : 80 これらの処理はCloud RunやCloud Schedulerを使い定期的に実行しています。 なお、この仕組みの構築に必要なコードのほとんどはGemini CLIに書いてもらいました。1〜2割くらいは手で書きましたが、残りはGemini CLIに任せることができました。 GitHub ActionsでGemini CLIを実行する GitHub ActionsでGemini CLIを実行するための方法についても紹介します。 この時、認証情報をどのようにGitHub Actionsに渡すべきかが重要になります。Service AccountのJSONキーやGemini APIキーなどのような認証情報をGitHub ActionsのSecretにセットする方法が考えられますが、この方法は非推奨です。 docs.github.com その代わりにWorkload Identity Federationという仕組みを使ってGemini CLIを利用するための認証情報をGitHub Actionsに渡します。Workload Identity Federationを行うためには、Workload Identity PoolとWorkload Identity Providerを予め作成します。以下のドキュメントに従ってそれらを作成しておきます。 github.com そして、以下のようにService Accountを作成して、そのService AccountにGemini CLIの権限を付与します。 data "google_project" "ai-coding" { project_id = local.project_id } locals { github_actions_service_accounts = yamldecode ( file ( "$ { path.module } /github_actions_service_accounts.yaml" )) } resource "google_service_account" "github-actions" { for_each = { for github_actions_service_account in local.github_actions_service_accounts : github_actions_service_account [ "repository" ] => { repository = github_actions_service_account [ "repository" ] } } account_id = format ( "gha-%s" , replace (each.value.repository, "_" , "-" )) display_name = format ( "GitHub Actions(%s)" , each.value.repository) } resource "google_service_account_iam_member" "github-actions" { for_each = { for github_actions_service_account in local.github_actions_service_accounts : github_actions_service_account [ "repository" ] => { repository = github_actions_service_account [ "repository" ] } } service_account_id = google_service_account.github-actions [ each.value.repository ] .name role = "roles/iam.workloadIdentityUser" member = format ( "principalSet://iam.googleapis.com/projects/%d/locations/global/workloadIdentityPools/github-actions/attribute.repository/<組織名>/%s" , data.google_project.ai-coding. number , each.value.repository) } resource "google_project_iam_member" "vertex-ai-service-account" { for_each = { for github_actions_service_account in local.github_actions_service_accounts : github_actions_service_account [ "repository" ] => { repository = github_actions_service_account [ "repository" ] } } project = local.project_id role = "roles/aiplatform.user" member = google_service_account.github-actions [ each.value.repository ] .member } 上記のterraformで参照している、 github_actions_service_accounts.yaml は以下のようなYAMLです。新規にGemini CLIを動かしたいリポジトリが増えた場合には、利用者にはこのYAMLを修正するPRを作成する形で権限付与の申請をしてもらいます。 - repository : <Gemini CLIを動かしたいリポジトリ名> division : 〇〇本部 department : 〇〇部 terraformではYAML内のrepositoryフィールドのみを読みだしていますが、それ以外のフィールドは部署ごとの費用集計に利用しています。 そして、以下のようなYAMLを .github/workflows 配下に配置すれば、GitHub Actions内でgeminiコマンドが利用できます。MacなどでGemini CLIを起動する際には初回起動時にインタラクティブな手順で認証方法を設定しますが、GitHub Actionsではこの方法が使えません。そのため、認証方法をVertex AIにするための設定をJSONファイルに直接書き出しています。 name : Gemini CLI Example # ジョブの起動条件は各自でお好みに on : push : branches : - main env : GOOGLE_CLOUD_PROJECT : <プロジェクトID> GOOGLE_CLOUD_LOCATION : <どのリージョンのGeminiモデルを呼び出すのかを指定> permissions : contents : 'read' id-token : 'write' jobs : run-gemini-cli : runs-on : ubuntu-latest steps : - name : Checkout repository uses : actions/checkout@v3 - name : 'Authenticate to Google Cloud' uses : 'google-github-actions/auth@v2' with : workload_identity_provider : projects/<Project Numberを入れる>/locations/global/workloadIdentityPools/github-actions/providers/github-actions service_account : <サービスアカウント> - name : Setup Node.js uses : actions/setup-node@v3 with : node-version : '22' - name : Install Gemini CLI run : npm install -g @google/gemini-cli # NOTE : 認証方法の設定方法がプリミティブすぎる気がするので、将来的にいい感じのactionがでてきて欲しい - name : Create Gemini settings run : | mkdir /home/runner/.gemini && echo '{"selectedAuthType": "vertex-ai"}' > /home/runner/.gemini/settings.json - name : Run Gemini CLI run : | gemini -p "hello" 全社統一プロジェクト以外でGemini CLIを利用していることの検知 Gemini CLIを利用するプロジェクトを中央集権化するためには、それ以外のプロジェクトでGemini CLIを利用している社員の検知も重要です。Vertex AIの権限を付与すれば、他のプロジェクトでもGemini CLIを使えてしまうため、それらの利用を検知して、中央管理のプロジェクトに移行してもらう必要があります。 監査ログに対して以下のクエリを実行すると、中央管理のプロジェクト以外でGemini CLIを利用しているユーザーを抽出できます。Gemini CLIがGemini APIを呼び出す時のUserAgentは、 GeminiCLI/ から始まっているため、この条件で抽出しています。 select distinct resource .labels.project_id, protopayload_auditlog.authenticationInfo.principalEmail as email, regexp_extract(protopayload_auditlog.requestMetadata.callerSuppliedUserAgent, r ' ^(.+)/.+$ ' ) as ai_coding_tool, from <監査ログ> where resource .labels.project_id <> ' 中央管理するプロジェクトID ' and resource .labels.service = ' aiplatform.googleapis.com ' and starts_with(protopayload_auditlog.requestMetadata.callerSuppliedUserAgent, ' GeminiCLI/ ' ) order by project_id asc , email asc , ai_coding_tool asc Gemini CLIに脆弱性が報告されたときの影響範囲の調査 先日、Gemini CLIに深刻な脆弱性が発見されたという記事が公開されました。最新版ではこの脆弱性は修正済みなので、Gemini CLIの利用者を調査してバージョンを上げるように促す必要があります。本章ではその作業を紹介いたします。 arstechnica.com まず、以下のクエリでGemini CLIを利用しているユーザーを抽出できます。 select distinct resource .labels.project_id, protopayload_auditlog.authenticationInfo.principalEmail as email, from <監査ログ> where resource .labels.service = ' aiplatform.googleapis.com ' and starts_with(protopayload_auditlog.requestMetadata.callerSuppliedUserAgent, ' GeminiCLI/ ' ) order by project_id asc そして、抽出されたユーザーに対してGemini CLIを最新版に上げるようにアナウンスを行っています。 今後の展望 この仕組みの今後の展望についても紹介します。 今回紹介した仕組みはVertex AI Gen APIでGemini CLIを利用するためのものでしたが、定額課金でもGemini CLIを利用できます。Gemini CLIを多く使いたい人はこちらのプランで利用したほうがコストパフォーマンス良く利用できます。そのため、定額課金でGemini CLIを利用するための社内の準備が整い次第、利用費の多い人を定額課金に切り替えるような運用フローも予定しています。その際にはこの記事で紹介した費用集計の仕組みなどにも手をいれる必要がありますが、コスト効率の良い開発AIエージェント活用のためにも定額プランの活用は必要です。 また、Vertex AI Model GardenでAnthropic社のモデルの利用もできます。Claude Codeの使うモデルプロバイダをGoogle Cloudにする場合の費用集計の仕組みなどの構築も予定しています。 まとめ Gemini CLIを全社員が利用できるようにするための様々な仕組みを紹介しました。「Gemini CLIで効率アップ!」という記事は毎日のようにSNSを賑わせていますが、本記事のような管理側に立った記事も増えていくと嬉しいです。 この記事を書くにあたって、以下のエムスリーさんの記事の監査ログを活用するアイデアなどを参考にさせていただきました。AI開発ツールの活用方法だけはなく、管理系のノウハウも公開して頂けていることにお礼申し上げます。 www.m3tech.blog また、本記事で紹介した仕組みはこのタイミングでゼロから作ったわけではなく、監査ログや課金情報をBigQueryに集めている部分は既存の仕組みを流用しました。BigQueryはとてもパワフルな分析DBなので、とりあえず様々な情報を格納しておくと、今回のようなケースで潰しが効くのでオススメです。 ZOZOでは、一緒にサービスを作り上げてくれる方を募集中です。ご興味のある方は、以下のリンクからぜひご応募ください。 corp.zozo.com Wikipedia - Fast inverse square root ↩
.table-of-contents ul ul { display: none; } はじめに こんにちは。計測システム部研究開発ブロックの 皆川 です。普段はWebAssemblyを用いた身体計測Webアプリの開発や、AIを用いた身体計測アルゴリズムの改善に携わっています。 2025年の6月11日から15日にかけて行われたCVPR 2025に参加しました。この記事では、現地の様子と筆者が選んだ面白かったセッションについてご紹介します。例年通りだと、ほとんどの発表がカンファレンス後まもなくして 公式サイト で動画公開されます。 はじめに CVPRとは 日本からナッシュビルまで 会場の様子 セッションレポート Googleのファッション分野での取り組み 技術概要 技術課題 2Dバーチャル試着以外の取り組み 感想 AIpparel 技術概要 応用 技術課題 感想 PromptHMR 技術概要 感想 VGGT: Visual Geometry Grounded Transformer 技術概要 感想 さいごに CVPRとは CVPRは1万人以上が参加する世界最大級の「AIと画像処理のカンファレンス」です。今年はアメリカのナッシュビルで5日間にわたって開催され、約120のワークショップや、約3000の研究発表をはじめとして、さまざまなセッションが行われました。 日本からナッシュビルまで CVPR 2025の開催地であるテネシー州ナッシュビルは、アメリカ中部に位置します。今回、筆者は羽田空港から、シカゴ・オヘア空港で乗り継ぎ、ナッシュビル国際空港へ向かいました(羽田からシカゴまでは12時間、シカゴからナッシュビルまでは2時間)。 空港からホテルまではバスを乗り継けば約1時間ですが、慣れない土地で、時差ぼけもあったのでUberを使いました。ホテルまでの所要時間は15分くらいでした。車内ではドライバーが大音量でアップテンポな音楽を流しながら高速道路を走行しており、そんな様子を見てアメリカに来たという実感が改めて湧いてきました。 会場の様子 会場であるミュージック・シティ・センターは、ナッシュビルの市街地にあります。1万人規模のカンファレンスにも余裕で耐えられるくらい大きい会場でした。 ミュージック・シティ・センターの外観 物理参加者は9,300人ほどだったそうです。初日には参加証をもらうのに長蛇の列ができていました。 撮影:皆川 撮影:皆川 参加者特典としてオリジナルTシャツが配布されました。サイズも選択でき、筆者はLを受け取りました。 オリジナルTシャツの前面と背面 ランチはご覧のとおり大盛況で、世界各国から集まった画像処理の専門家が英語で盛んに意見交換を行なっていました。偶然、同席したフロリダ州で工学を教えているというシニア世代の教授からは「私の年代はオンラインでは服は買わないが、どうすれば購入を促せると思うか」という挑戦的でありながら示唆に富む質問も寄せられました。 撮影:皆川 ランチは、参加登録時に選んだものを当日受け取る形式でした。 ランチで提供されたサンドイッチ ポスター発表会場の様子です。 撮影:皆川 撮影:皆川 オーラル会場の様子。採択された研究の中で3%ほどがオーラル発表に選ばれます。 撮影:皆川 キーノート発表が行われたメイン会場の様子。 撮影:皆川 今年は以下の3つがキーノートでした。 Exploring the Low Altitude Airspace: From Natural Resource to Economic Engine The Llama Herd of Models: System 1, 2, 3 Go! Gemini Robotics, Bringing AI to the Physical World 登壇者は直前まで非公開だったため、筆者は密かにYann Lecun氏やAndrej Karpathy氏の登壇を期待していましたが、残念ながら実現しませんでした。 企業ブースの様子です。出展企業の数は、他のカンファレンスに比べて想定していたより少なめでした。 個人的には、Metaのブースが特に印象的でした。カンファレンス全体を通して、Meta由来のモデルが研究プロジェクトで活用されているのをたくさん目にしました。ブースではそれらに実際に触れるインタラクティブなデモがあり、MetaがAI分野において果たしている貢献の大きさを改めて感じる機会になりました。 DINO v2を使った、地図画像から地形の標高を推定するデモ。AIが地球科学領域で具体的に応用される例で興味深いです。 3Dデータからテキストでオブジェクトの検出ができるLocate 3Dのデモ。 Metaのブースに長蛇の列ができているコーナーがあり、確認するとテキストプロンプトから生成した画像を、その場でステッカーにプリントできる体験ブースでした。 長蛇の列ができていた生成AIデモの様子。 セッションレポート ここからはCVPR 2025で気になった発表を紹介します。 Googleのファッション分野での取り組み Googleの最近のファッション関係の取り組みについて、Ira Kemelmacher-Shlizerman氏が バーチャル試着に関するワークショップ の中で発表していました。 Googleは本稿の執筆時点で、アメリカ地域のみですが、バーチャル試着のデモを展開中です。このデモは、自分の全身写真を用いて、Google Shoppingにある衣服をすべて試着でき、2025年5月のGoogle I/Oで大きな反響を呼びました。 Googleのブログ記事「 Shop with AI Mode, use AI to buy and try clothes on yourself virtually 」より抜粋。 技術概要 Ira氏の発表によると、仕組みとしては昨年のCVPRでIra氏のチームの発表した M&M VTO を使っているそうです。M&M VTOの仕組みとしての特徴は以下です。 UNet Diffusion Transformerというモデルアーキテクチャーを採用することで、テキストプロンプトと入力画像の埋め込みベクトルを条件付き入力(conditioning)として取り込めるようにした。 衣服の外観情報を忠実に保持するため、拡散過程にはSingle-Stage Diffusionを採用した。 同一データセットを、低解像度→高解像度の順に学習する二段階学習を導入した。 アイデンティティ保持機能を高めるため、合成データセットを新たに構築し、モデルに専用学習ブランチを設けた。 M&M VTOの概要図。 プロジェクトページ より抜粋。 バーチャル試着のベンチマーク(DressCodeのFID)では、M&M VTOを上回る手法も複数存在します。しかし、筆者が実際にそれらの手法を触ってみた感覚としては、生成画像の品質や衣服の外観の保持の点で、M&M VTOが際立って優れていると感じました。 なお、バーチャル試着のベンチマークについては、イリノイ大学のDavid Forsyth教授が同ワークショップで指摘していました。「現行の評価手法には大きな課題があり、これを改善すれば研究の進展が加速する」とのことでした。 技術課題 Googleバーチャル試着は他の手法に比べて実際の使用感が優れていると感じましたが、論文でも指摘されている通り、以下のような課題もあります。 体型や顔などが変わってしまう場合がある。 服の細かい特徴が失われてしまう場合がある。 服のサイズ感を考慮していないため、服のサイズが合っているか保証されない。 バーチャル試着の現行手法のボトルネックとしては、先述のForsyth教授が「データの欠如よりはアーキテクチャーに問題があるかもしれない」と述べていたのが印象的でした。 多くの手法で採用されているDiffusionモデルは比較的新しく、その制御方法はホットなトピックです。CVPR 2025でも同トピックに関する発表は依然として多かった印象です(例1: PS-Diffusion 。例2: Paint by Inpaint ) また、Diffusion以外の生成手法を検討するワークショップ(「 Visual Generative Modeling:What's After Diffusion? 」)もありました。コミュニティ全体としてDiffusion技術に関する課題感の高さを感じました。 2Dバーチャル試着以外の取り組み Ira氏の発表ではこれらに加え、 Total Selfie (Chen et al., CVPR 2024)や、Super Zoom(未発表)などの取り組みも紹介されました。総じてGoogleのファッション領域への積極的な技術投資が伺える内容でした。 自撮りからアバターを生成できるTotal Selfie。 論文 より抜粋。 マウスオーバーすると生成AIで超解像度の画像を生成するSuper Zoom。 発表の動画 3:31:09頃 より抜粋。 感想 Googleのバーチャル試着は、衣服と身体のサイズ情報を取り入れていないとのことでした。発表者のIra氏もアパレル分野ではサイズのミスマッチを減らすことに大きな関心があることは認知している上で、現状でサイズの問題に取り組む予定はないとのことでした。計測技術に携わっている筆者としては、今後この2Dのバーチャル試着という分野に取り組む場合は、衣服と身体のサイズ情報を保持したsize-awareなバーチャル試着を目指したいと思います。 AIpparel AIpparel は画像やテキストを入力として衣服の2D型紙を生成するマルチモーダルな基盤モデルです。従来はCAD操作や裁断の専門知識が必要だったアパレルデザインを、自然言語の指示だけで誰でも行えるようにすることを目指しています。 プロジェクトページ より抜粋。 技術概要 手法の概要は以下の通りです。 GarmentCode というドメイン固有言語(DSL)から衣服の型紙(patterns)をルールベースで生成する手法を基盤にしている。 GarmentCodeと互換性のあるGarmentCode DSL(以下、GCDSL)を学習し、出力する。 マルチモーダルなモデルのため、画像・テキスト・GCDSLのいずれも入力可能。 主な機能は、以下です。 画像やテキストからの型紙生成 既存の型紙のテキストによる編集 モデル学習の概要は以下の通りです。 オープンソースVLMであるLLaVa-1.5をファインチューニングし、テキストおよび/または画像入力からGCDSLを出力するモデルを構築。 学習データにはGarmentCodeDataにVLM(BLIP-2)でキャプションを付与したものを使用。 モデルのファインチューニング時には以下の3パターンで教師あり学習を実行(※実際はトークナイザかデトークナイザが介在するため、GCDSLは厳密にはモデルの直接の入出力ではない)。 a)入力:テキスト→出力:GCDSL b)入力:画像→出力:GCDSL c)入力:GCDSL→出力:GCDSL プロジェクトページ より抜粋。 本手法は、以下のタスクで最高性能を達成しています。 テキストからの型紙生成 画像からの型紙復元 型紙の局所編集 テキストや画像による型紙生成の例。 論文 より抜粋。 型紙の局所編集の例。 論文 より抜粋。 応用 本手法の基盤であるGarmentCodeは、既出のバーチャル試着のワークショップで、多数の登壇者が言及しており、注目度の高い手法です。実際、GarmentCodeを利用したバーチャル試着や体型推定向け合成データセットの構築も行われているようでした。 本手法は、現時点ではデモが公開されていないものの、バーチャル試着やマスカスタマイゼーションの分野で応用できる研究です。例えば、以下のようなシナリオが考えられます。 ECサイト上に掲載された膨大な量の衣服を、サイズ情報を維持したまま、自身のアバターで試着する。 試着した衣服をAIと対話しながら「もっと肩幅を広くして」「もっとミニマルに」など自然 言語でデザインやサイズを修正する。 技術課題 一方で、ファッション分野では衣服データ(2D・3D)不足が課題であることも、既出のワークショップでも議論されていました。今後、データ拡充によって基盤モデルがより機能的になることで、ファッション関連のソフトウェア技術はさらに進歩していくことが期待されます。 感想 身体の3D化技術は SMPL (2015)の発明以降、段々と成熟してきている印象がありますが、衣服の3D化技術も、GarmentCode(2023)以降、盛り上がりを感じます。この技術が進んでいけば、size-awareでスケーラブルなバーチャル試着は技術的には実現可能だと言えます。 実際、デモレベルであればsize-awareなバーチャル試着は存在しています。例えば、 GarmentCodeのデモ では、WebのUIからオリジナルの衣服がデザインでき、それを自分の体型データを再現したアバターに着せることができます。 ただしこうしたデモを日常の購買体験に繋げるには、衣服の3D化技術だけでなく、センスの良いビューアや、簡単かつ正確に測れる身体計測機能など複数のコンポーネントが必要になります。筆者は今後も身体計測機能の進化に尽力していきたいと思います。 PromptHMR PromptHMRは画像中の人体推定に、テキストやバウンディングボックスといった付加情報を付与できるようにした手法です。従来では難しかった画像でも正確な体型・姿勢推定を実現しています。 従来手法では難しかった画像と、PromptHMRによる推論結果。 論文 より抜粋。 技術概要 PromptHMR は、手法として以下のような背景や特徴があります。 体型・姿勢推定タスクでは、従来のモデルではクロップした画像を前提としているため場所の情報がうまく使えない。 過去にはVLMを応用した例もあるが、精度の点ではいまいちだった。 トランスフォーマーをベースにした手法では、上記の2つの例にあるような、位置的な情報と意味的な情報を付与できるようなモデル設計が可能。 プロンプトとして、テキストやバウンディングボックス、セグメンテーションマスクなどが入力可能。 EMBDや3DPWなどの、実環境(in-the-wild)画像における姿勢推定のベンチマークで最高値を更新。 手法の概要。 論文 より抜粋。 感想 著者の一人であるMichael Black氏はデジタルヒューマン分野における世界的な第一人者です。今後も本研究のようにAI技術の最先端を取り入れ、技術的限界を押し広げる先進的な研究が期待されます。 過去には同じ著者達による研究で、自然言語による体型推定にフォーカスした手法である SHAPY があり、本研究よりファッションとの関連性がより高い内容となっています。 本研究は従来、画像だけでは解くのが難しかったタスクで、トランスフォーマー構造に付加情報を組み込むことでロバストさや精度が向上する例です。今後、この研究を応用することで、スーツやマットなどの物理参照物がなくても、安定して精度よく測れるようなアルゴリズムを開発していこうと思っています。 VGGT: Visual Geometry Grounded Transformer VGGT は従来数十秒から数分かかっていた3D再構成を1秒以内で実行し、複数の3D再構成に関連するベンチマークで最高性能を達成した汎用3D画像モデルです。本研究はカンファレンスのBest Paper Awardも受賞しています。 技術概要 本手法の概要は以下の通りです。 大規模トランスフォーマーを採用。画像入力のみで深度、カメラ、点群を推定。 3D再構成タスクで頻出の反復的最適化を用いていないため、従来手法と比べて高速。 15を超えるデータセット(実写、合成含む)を使って学習。 入力にカメラ変数を必要としない。入力は一枚から数百枚まで可変的に処理可能。 カメラ変数推定や深度推定、点群推定などの3D再構成関連タスクで最高性能を獲得。 本手法の動作イメージ。一枚〜数百枚の任意の枚数の画像を入力にとり、3Dデータを出力する。 論文 より抜粋。 本手法の概要。 論文 より抜粋。 感想 実際に公開されているデモを触ってみた結果、実行速度の早さに驚きました。また従来の方法と比べて、非剛体変形(例:ポーズ変化)に対するロバストさが高いとも感じました。論文では「小規模の非剛体変形には対応できるが、大きなものだと失敗する」と述べられています。同時に「アーキテクチャーを大きく変更しなくても、データセットさえあればタスク特化ができる」と明言されています。例えば人体計測用途でのロバスト性強化も最小限の改変で実現できる可能性があります。 著者であるJianyuan Wang氏は、3Dは2Dに比べて大幅にデータが少ないことを3Dの画像処理の大きな課題であると指摘しています。そして2D画像から3Dデータを生成する本手法の重要性を強調しています。本手法は今後、3Dの画像処理分野を加速させるツールになり得ると感じました。 現状の画像を用いた身体計測は、SMPL等のテンプレートメッシュを使った方法が主流です。しかし、本研究のようにリアルタイムかつ非剛体にもロバストな方法が出てくると、計測精度の点で有利な3D再構成を用いた身体計測を選択肢として考える場面も将来的には出てくる可能性もある、と思いました。 さいごに CVPR 2025の参加レポートをお届けしました。カンファレンスを通して技術的に感じたのは、マルチモーダルな大規模トランスフォーマーの持つポテンシャルと、その学習に必要な3Dデータの希少性でした。ファッションに関するソフトウェア技術としては、身体計測研究の進化や、それと関連のあるバーチャル試着研究の進化を目の当たりにでき、知見を貯められたことに参加意義があったと思います。またAIや画像処理の分野における世界のトップランナー達の話を生で聴けたのもとても刺激になりました。今回得た知見を活かし、今後も計測技術の研究開発に取り組んでいきたいと思っております。 ZOZOでは、各種エンジニアを採用中です。ご興味のある方は以下のリンクからご応募ください。 corp.zozo.com
ZOZO開発組織の2025年6月分の活動を振り返り、ZOZO TECH BLOGで公開した記事や登壇・掲載情報などをまとめたMonthly Tech Reportをお届けします。 ZOZO TECH BLOG 2025年6月は、前月のMonthly Tech Reportを含む計10本の記事を公開しました。振り返ってみると特にイベントの参加レポートが多い月でした。特にTwo-Towerモデル×Vertex AI Vector Searchの記事は多くの方に読まれています。 techblog.zozo.com 登壇 OctoNihon Forum 6月6日に開催された「 OctoNihon Forum 」に技術戦略部の堀江が「 ZOZOにおけるGitHub Copilotの活用事例 」というタイトルで登壇しました。 🗣️ 明日 6/6(金) 開催! GitHub Enterpriseユーザーが集い、知見を共有し、最新技術を学び、AI時代のソフトウェア開発の未来を探ることを目的としたイベント『OctoNihon Forum』で技術戦略部の堀江 @Horie1024 が事例セッションに登壇します🎙️ https://t.co/kJPGR2Hr8J #zozo_engineer — ZOZO Developers (@zozotech) 2025年6月5日 speakerdeck.com JJUG CCC 2025 Spring 6月7日に開催された「 JJUG CCC 2025 Spring 」に物流開発部の岡本が「 Javaに鉄道指向プログラミング(Railway Oriented Programming)のエッセンスを取り入れる 」というタイトルで登壇しました。 🗣️ 6/7(土)に開催される『JJUG CCC 2025 Spring』で物流開発部の岡本が「Javaに鉄道指向プログラミング(Railway Oriented Programming)のエッセンスを取り入れる」というタイトルで登壇します🛤️ https://t.co/y5Q3ojPbn2 #jjug_ccc — ZOZO Developers (@zozotech) 2025年6月6日 speakerdeck.com Extended Tokyo - WWDC 2025 6月9日に開催された「 Extended Tokyo - WWDC 2025 」に、ZOZOTOWN開発2部の續橋が登壇しました。 📣 6/9(月)深夜に開催される「Extended Tokyo - WWDC 2025」にて、ZOZOTOWN開発本部の續橋 @tsuzuki817 が登壇します! 🗣️テーマは 「SwiftUI Transaction を徹底活用!ZOZOTOWN UI開発での活用事例」 年に一度のお祭りを一緒に楽しみましょう! https://t.co/npN9QlobsS #WWDC25 #extended_tokyo — ZOZO Developers (@zozotech) 2025年6月6日 speakerdeck.com WWDC25 Recap for Spatial Computing 6月16日に開催された「 WWDC25 Recap for Spatial Computing 」に、技術戦略部の諸星が登壇しました。 WWDC25 報告会 at LINEヤフー, ZOZO 6月19日に開催された「 WWDC25 報告会 at LINEヤフー, ZOZO 」に、ZOZOTOWN開発1部の濵田、WEARフロントエンド部の清板、FAANS部の上田がトーク枠で登壇しました。また、技術戦略部の諸星がパネルディスカッション枠で登壇しました。 📣 6/19(木)に開催される「WWDC25 報告会 at LINEヤフー, ZOZO」にて、ZOZOTOWN開発1部 濵田・WEARフロントエンド部 清板・FAANS部 上田がLTのスピーカーとして、技術戦略部 諸星がパネルディスカッションのパネラーとして登壇します! https://t.co/pJOhbV0673 #WWDC25 #wwdc_lyz — ZOZO Developers (@zozotech) 2025年6月18日 techblog.zozo.com LODGE XR Talk Vol.28 6月25日に開催された「 LODGE XR Talk Vol.28 」に、技術戦略部の諸星が「 WWDC25 & AWE USA 2025 Report 」と題して登壇しました。 DroidKaigi.collect { #20@Tokyo } 6月27日に開催された「 DroidKaigi.collect { #20@Tokyo } 」に、技術戦略部の堀江が登壇しました。 掲載 キーマンズネット 「 キーマンズネット 」に、GitHub Copilotの活用事例に関する記事が掲載されました。私たちは2023年7月に「 GitHub Copilotの全社導入とその効果 」という記事を公開しています。そこから2年弱が経過した現在の状況として、「 GitHub Copilot Agent mode 」と「 GitHub Copilot code review 」が利用可能な状況になっていることなどが紹介されています。 kn.itmedia.co.jp その他 マッチングアプリ「ZOZOマッチ」を提供開始 6月30日に、マッチングアプリ「 ZOZOマッチ 」を提供開始しました。 corp.zozo.com zozomatch.jp 「Girls Meet STEM」2025夏ツアーに参画 昨年末に引き続き、公益財団法人山田進太郎D&I財団が主催する中高生女子にSTEM(理系)領域の体験を提供するプログラム「Girls Meet STEM」2025夏ツアーに参画します。今回のテーマは「 ZOZOTOWN・WEARを支える技術と働き方をのぞいてみよう! ~オフィスを見学して女性エンジニアと交流! IT×ファッションとは? ~ 」です。 corp.zozo.com www.shinfdn.org 以上、2025年6月のZOZOの活動報告でした! ZOZOでは、一緒にサービスを作り上げてくれる方を募集中です。ご興味のある方は、以下のリンクからぜひご応募ください。 corp.zozo.com
はじめに こんにちは、ZOZOMO部FBZブロックの杉田です。2025年7月3日・4日の2日間、JPタワーホール&カンファレンスにて「 開発生産性Conference 2025 」が開催されました。本記事では、会場や各ブースの様子に加え、特に印象に残ったセッションについてご紹介します。 開発生産性Conference 2025とは 本カンファレンスは、生成AIとの協働が不可欠な時代に、いかに開発生産性に取り組み事業価値を高めていくかをテーマに開催されました。3回目を迎える今年は、来場者数が3000人を超える盛況ぶりで、開発生産性への関心の高さがうかがえます。 会場の様子 会場は東京駅直結のJPタワーホール&カンファレンスでした。 会場から東京駅を一望できる エントランスのパネル セッションの合間には多くの参加者がスポンサーブースで情報収集したり、活発に交流したりしていました。皆さん、開発生産性に関する話題で盛り上がっている様子が印象的でした。 スポンサーブースの様子 #1 スポンサーブースの様子 #2 スポンサーブースでは参加者向けのアンケートも実施されており、イベント参加者の傾向が見て取れて興味深かったので、アンケート結果をいくつか抜粋してご紹介したいと思います。 株式会社コドモンさんのブース 「あなたのチームの開発生産性を支えているもの」というテーマに対して、「Claude CodeなどのコーディングAI」や「ペアプロ」「チームの協力体制」といった実践的な回答が多く寄せられていました。その中に「愛」や「強い心」といった精神的な支えを挙げるユニークな回答も見られたのが印象的でした。 株式会社ビズリーチさんのブース 「開発生産性お悩みランキングと実践知」というテーマで、多くの開発者が共感する悩みと、実際に試して効果のあった取り組みが紹介されていました。最も共感を集めた悩みは「技術的負債の返済と新機能開発とのバランス」で、これに対し、キーノートに登壇されたケント・ベック氏の著書「Tidy First?」の内容を実践しているというメモもあり、大変参考になりました。 株式会社LayerXさんのブース AIコーディングの利用状況を見ると、ほとんどの人が日常的に活用しており、その効果を実感していることが分かる結果となっていました。 セッション紹介 ここからは気になったセッションの紹介をします。 開発生産性測定のトレードオフ 「グッドハートの法則」はもっと悲観的に捉えるべきだった ケント・ベック氏の登場時の様子 このセッションを聞いて、ソフトウェア開発の「生産性」という言葉の裏に潜む奥深さを改めて感じました。特に印象的だったのは、表題にも含まれている「指標が目標になると、それはもはや良い指標ではなくなる」というグッドハートの法則です。 Goodhart’s Law 開発者のプルリクエスト数やコード行数といった数値目標がいかにシステムを歪ませ、かえって生産性を損なうかという具体例は身につまされる思いでした。AIの登場がコーディング効率を劇的に高める一方で、従来の測定アプローチがこの歪みをさらに悪化させる可能性があるという指摘は、これからの開発現場を考える上で非常に重要だと感じました。 ケント・ベック氏が提唱する「価値のパス」の概念は「顧客の振る舞いの変化(アウトカム)」や「会社への収益貢献(インパクト)」といった、より後期の段階で行うべきとあり、本質的な価値追求の重要性を教えてくれました。 Path of Value リーダーとして「データで気づきを促す」ことの重要性や、若手育成においてアウトプットの量ではなく「学び」に焦点を当てるべきという示唆は、AI時代におけるマネジメントや人材育成に対する新たな視点を与えてくれました。単なる数字の追求ではなく、真の価値とは何か、それをどう育んでいくべきかを深く考えるきっかけとなる非常に示唆に富んだセッションでした。 AIを前提とした開発プロセスとマネジメントの変革 - 開発生産性+2000%達成に向けた取り組み このセッションでは、AIを前提としたプロダクト開発を実践することで生産性を爆発的に向上させた事例について紹介されていました。 多くの組織では専門領域ごとの分業が当たり前ですが、このセッションではその分業こそがコミュニケーションの肥大化を生み、情報ロスや開発速度の低下を引き起こすボトルネックだと指摘していました。企画と開発、PMとエンジニアといった役割の間で生まれる無数のやり取りが、価値提供のスピードを鈍らせているのです。 プロダクト開発体制 この壁を破壊するアプローチとして「プロダクト志向 × 多能工」が紹介されていました。 プロダクト志向×多能工 これは、以下の2つの要素を掛け合わせた考え方です。 プロダクト志向:「なぜ作るのか(Why)」という顧客価値に常に立ち返る思考 多能工: 一人の担当者が、課題発見(Why)から実装(How)までを一気通貫で担うスキル この一人で完結させる働き方を、AIが強力にサポートします。AIは実装や資料作成といった作業を肩代わりし、スキルギャップを埋めてくれるのです。まるでジュニアメンバーのようにAIをマネジメントすることで、生み出せる価値は飛躍的に高まるとのことです。 AIを用いたリソースのスケールアウト 実際に、あるPMの方が事業開発からリリース・運用まで全ての工程を一人で担ったというエピソードも紹介されました。 サービス立ち上げにおける役割 その際に利用したAIの膨大なトークン数を示したダッシュボードも公開され、インパクトがありました。 Claude Code使用料ダッシュボード しかし、これら一連の話には重要な示唆も含まれていました。顧客が本当に困っていること、すなわち「Why」を深く探求すること、そして中長期的な運用を見据えた品質を担保することは、やはり人間にしかできないという事実です。 AIに「How(どう作るか)」を任せ人間は「Why(なぜ作るか)」に深く寄り添う、この役割分担こそが、これからの時代に圧倒的な開発生産性を生み出す鍵になっていくのだろうと感じました。 開発生産性を組織全体の「生産性」へ! 部門間連携の壁を越える実践的ステップ speakerdeck.com このセッションでは、開発生産性とビジネス指標の乖離を解消するための具体的な実践ステップが紹介されました。 部分言語の理解: 各部門のKPIを深く理解し、エンジニアの貢献を「誰が・何を行い・どのような結果をもたらしたか」という形で具体的に言語化する 共通言語の設計: 開発チームの活動と経営指標を相関マップで関連付け、職能を横断して理解できる「共通言語」を設計する 指標化: 設計した共通言語に基づき、工数やリードタイムといった課題を深掘りするための具体的な指標を作成し、継続的な改善を促す 結論として、生産性指標は一度作成して終わりではなく、対話を通じて改善し続ける「生きた言語」として育てることで、組織全体の生産性向上につながると述べられていました。このセッションから、単にFour Keysのような一般的な指標を追い求めるのではなく、まずは自社の状況に合わせた「共通言語」を設計し、そこから課題の原因を深掘りできる指標を作ること。そして、スモールスタートで導入し、フィードバックを得ながら改善サイクルを回していくことの重要性を学びました。 「開発生産性」ではなく、事業の投資対効果に向き合う「事業生産性」へ speakerdeck.com 従来の開発生産性はタスクの消化量で見られがちでしたが、このセッションではROIC(投下資本利益率)を事業生産性として捉える視点で触れており、多くの学びや気づきがありました。 AIへの投資に対する解釈 中でも、開発者一人ひとりが日々の業務と会社の利益(売上増加やコスト削減)との繋がりを意識し、ROIC向上に貢献すべきという話が特に印象に残りました。ROIC向上に貢献するための具体的な手段として、生成AIの活用が大きく貢献するという外部機関のレポートは興味深かったです。 セッションサマリ このセッションでは、開発とビジネスが一体となって価値を創造する重要性を改めて学ぶ良い機会となりました。この学びを、今後の業務に活かしていきたいと思います。 エンジニアが主体的にビジネスに貢献する〜開発現場からの変革 このセッションは、株式会社一休CTOの伊藤直也氏と、ファインディ株式会社代表の山田裕一朗氏による対談形式で行われました。 対談はいくつかのテーマをもとに進行しましたが、一貫して語られたのはエンジニアの本当の価値は技術力そのものではなく、顧客の課題をどれだけ解決できたかで測られるというものでした。私たちエンジニアは、つい「何が作れるか」という技術を起点に考えがちです。しかし、顧客が本当に困っていることは、現場の一次情報に触れなければ本質的には理解できません。そのための実践例として、一休ではエンジニアが営業に同行し、顧客のリアルな声を聞くことを実践しているそうです。これにより、開発すべきプロダクトの解像度が飛躍的に高まり、ビジネスへの貢献度が大きく変わるといいます。 従来のように、良いコードを書くことや設計するスキルはもちろん重要です。しかし、これからの時代は技術領域に留まらずビジネスの壁を越え、主体的に課題を発見しようと現場に目を向ける姿勢こそが、組織の中で価値を発揮する秘訣なのだと思います。 さいごに 今回のカンファレンスに参加して、多くのセッションで語られていた「開発生産性は、事業価値への貢献と切り離せない」という当たり前のようでいて、つい見失いがちな視点について気づくことができました。私たちエンジニアは、日々の業務でついコードを書く速さや量に目を向けてしまいがちです。でも本当に大切なのは、その活動がいかにして顧客に価値を届け、ビジネスの成長に繋がっているのかを考え抜くことなのだと、改めて気づかされました。 ZOZOでは、一緒にサービスを作り上げてくれる方を募集中です。ご興味のある方は、以下のリンクからぜひご応募ください。 corp.zozo.com
はじめに こんにちは、情報セキュリティ部の 兵藤 です。日々ZOZOの安全を守るためSOC業務に取り組んでいます。 ZOZOではGitHub Advanced Securityを導入、運用しております。本記事では、GitHub Advanced Securityに関する取り組みについて紹介します。 また、情報セキュリティ部ではその他にもZOZOを守るための取り組みを行っています。詳細については以下の「OpenCTIをSentinelに食わせてみた」をご覧ください。 techblog.zozo.com 目次 はじめに 目次 GitHub Advanced Securityとは GitHub Advanced Securityの導入の目的 導入の際に実施したこと CodeQLのAdvanced Setup設定 コンテナスキャンの設定 CodeQLの検知検証 CodeQLの得意な検知 CodeQLの不得意な検知 運用の際に実施したこと GHASのAlertの通知設定 Push Protectionの設定 Code scanningのAlertの対応 Secret scanningのAlertの対応 まとめ おわりに GitHub Advanced Securityとは GitHub Advanced Security(以下、GHAS)は、コードのセキュリティを向上させる複数の機能が含まれており、主な機能は以下の3つがあります。 Code scanning : コードの脆弱性を検出するための静的解析の機能 Secret scanning : コード内に含まれるシークレット(APIキーやパスワードなど)を検出する機能 Dependabot : ライブラリとフレームワークの既知の脆弱性を含む依存関係を検出する機能 パブリックリポジトリにおいては、GHASの機能は無料で利用可能ですが、プライベートリポジトリにおいてはCode scanningやSecret scanningの機能は有料となります。Enterpriseプランではアクティブコミッター数に応じて課金されます。詳しくは 公式ドキュメント をご覧ください。 GitHub Advanced Securityの導入の目的 ZOZOではZOZOTOWNをはじめとし、WEAR, FANNS, ZOZOMETRYなど自社開発のサービスを多数運用しています。これらのサービスにおけるコードのセキュリティ向上のために、GHASを導入しました。具体的な目的は以下の通りです。 コードの脆弱性の早期発見 : Code scanningを利用してコードの脆弱性を開発の段階で早期に発見し、修正することで、セキュリティリスクを低減する。 シークレットの漏洩防止 : Secret scanningを利用してコード内に含まれるシークレットを検出し、漏洩を防止する。 リポジトリのセキュリティ見える化 : Organizationのセキュリティダッシュボードを利用して、リポジトリのセキュリティ状況を可視化する。 これらを目的にGHASを導入、運用する過程でどのようにGHASを調整、活用していったかを紹介していきます。 導入の際に実施したこと CodeQLのAdvanced Setup設定 ZOZOではGHASの機能をOrganization全体で有効化しています。Settingsの「Security configurations」から設定ができます。Code scanningの設定のうち「CodeQL analysis」については基本的にDefaultの設定(以降、AutoBuild)を配ることになります。 このCode scanningは実態としてはGitHub Actionsで codeql-action を動かしており、別のActionsに組み込むことも可能です。 初期のAutoBuildの設定では一部AndroidやiOS、Cなどのビルドを行うようなコードを扱うリポジトリにおいて、Code scanningの有効化に失敗する場合があります。 理由は様々ですが、ビルドにおいて他のリポジトリを参照している、要求ライブラリやソフトのバージョンがシビア、Actionsのそもそものリソースがデフォルトのものでは足りない場合などが考えられます。そのためCodeQLの Advanced Setup を設定し、個々のリポジトリにおいてCodeQLのビルドを行うように設定しました。 以下のようにCodeQL analysisからAdvanced Setupを選択できます。 YAMLが出力されるので、リポジトリごとのBuildに必要な設定を普通のActionsのように編集します。例えば、以下のように設定することで、Advanced Setupを実施できます。 jobs : analyze : name : Analyze (${{ matrix.language }}) runs-on : my-larger-runner # 実行したい環境を指定 timeout-minutes : 360 strategy : fail-fast : false matrix : include : - language : java-kotlin build-mode : manual # manualに変更して、カスタムしたビルドを行う - language : ruby build-mode : none - if : matrix.build-mode == 'manual' name : Build with Gradle # manualでのBuild方法を記載 run : | ./gradlew assembleDebug これらの設定は個々のリポジトリごとに設定する必要があったため、プロダクトのエンジニアの協力を得て、CodeQLが有効化されていないリポジトリに対して、Advanced Setupの設定をしました。 ある程度ビルドが失敗する原因、グループが絞れている場合はこちらの ドキュメント のようにスクリプトを利用して一括設定も可能です。 コンテナスキャンの設定 GHASの機能にはコンテナイメージに存在するライブラリやOSの脆弱性を検出する機能は特段ありません。 そのため、TrivyやAWSのECRのコンテナスキャンなどのツールを利用してコンテナイメージの脆弱性を検出するなど代替案を検討する必要がありました。 基本的にこれらのコンテナスキャンの設定は各プロダクトで管理しています。このコンテナスキャンの結果はCodeQLで検出した結果と同じようにGitHubのSecurityタブで確認できるため、社内にコンテナスキャンを行うActionsを展開しました。以下はTrivyを利用したコンテナスキャンの結果をGHASのSecurityタブにアップロードするActionsの一例です。 jobs : scan-container : runs-on : ubuntu-latest timeout-minutes : 300 steps : # Checkout code - name : "Checkout repository" uses : actions/checkout@v4 #名称決定 - name : "Prepare" id : prep run : | REPO_NAME=$(echo "${{ github.repository }}" | tr "[:upper:]" "[:lower:]" ) echo "repo_name=${REPO_NAME}" >> $GITHUB_OUTPUT # コンテナビルド - name : "Build Container" run : docker build -t ghcr.io/${{ steps.prep.outputs.repo_name }}:scan-tmp ./ # 脆弱性スキャン - name : "Scan Container" uses : aquasecurity/trivy-action@master with : image-ref : "ghcr.io/${{ steps.prep.outputs.repo_name }}:scan-tmp" format : "sarif" limit-severities-for-sarif : true exit-code : "0" vuln-type : "os,library" severity : "CRITICAL" trivyignores : ".github/workflows/trivy/.trivyignore" output : "trivy-results.sarif" # GHASへのアップロード - name : "Upload Trivy scan results to GitHub Security tab" uses : github/codeql-action/upload-sarif@v3 with : sarif_file : "trivy-results.sarif" GHASは sarif 形式の ファイルアップロード をサポートしておりこの形式で出力すれば、コンテナスキャンの結果もGHASのSecurityタブで確認できます。この例では limit-severities-for-sarif を true にすることで、 severity がCriticalの脆弱性のみを検出し、GHASにアップロードしています。 CodeQLの検知検証 CodeQLには様々な検知ルール( query )が用意されており、コードの脆弱性をそのqueryに基づいて検出します。Organization全体でCode scanningを有効化すると、 default のqueryスイートが適用されます。 security-extended のqueryスイートについては各リポジトリで適用できます。 ZOZOではこの検出機能を検証するために脆弱なRuby, JavaScriptのアプリを用意しました。その際の所感をここでは紹介します。 CodeQLの得意な検知 SQLインジェクションやOSコマンドインジェクションはもちろん、プロトタイプ汚染まで検知してくれます。基本的にユーザーの入力が行われるところで発火するものは漏れなく検知してくれる印象です。 その中でもSSRFなど、一般的な診断ツールで検知が難しいものを漏れなく拾ってくれる点は非常に良いと思いました。 このSSRFの脆弱性は環境ごとに影響度合いが変わるためトリアージは難しいです。例えばAWSの場合はIMDSv2のtokenが奪取された状況、Azureの場合はManaged Identityの IDENTITY_HEADER が奪取された状況では被害が拡大し、無視できないものです。 実際に検知されたAlertについての対応は後ほど記載いたします。 CodeQLの不得意な検知 一度DBなどに格納された値など、Storedされた値を出力する際に発火するパストラバーサルやXSSなどの検知は難しい印象を受けました。 Storedされた情報を元に検知するqueryは言語によってバラつきがあるようで、パストラバーサルに関してはまだ Rubyのquery では実装されていないようでした。 Javaでは実装されていそう なので、今後Rubyでも検知できそうです。 その他にもアクセス制御不備の脆弱性など、そもそもSASTでの検知が難しいであろう部分もありました。 運用の際に実施したこと GHASのAlertの通知設定 GHASではCode scanningやSecret scanningで検出された脆弱性やシークレットの漏洩について、Alertが発生します。これらのAlertはGitHubのWeb UI上で確認できますが、Alertの発生をSlackや外部SIEMサービスなどの外部サービスに送信できます。 SOCではGHASから発生するAlertについて監視し、重大なAlertに対して早急に対応する体制を構築しました。具体的にはSOCで利用しているSentinelにGitHubのWebhookを介してAlertを送信します。 ドキュメント に従って application/json 形式で設定します。ペイロードURLに関しては、 Sentinelのコネクタ で作成されるAzure FunctionsのURLを設定します。以下のコネクターです。 SentinelのGitHub(using WebHooks)コネクタ 作成されたFunctionの「関数のURLの取得」から「ファンクション キー」のURLを設定すればログがSentinelに格納されます。 コネクタのAzure Functions githubscanaudit_CL のテーブルに dependabot_alert 、 secret_scanning_alert 、 repository_vulnerability_alert のeventがログとしてJSON形式で格納されます。これらのログを元にKQLの分析ルールを作成し、重大なAlertを抽出、通知します。 以下はCode scanningのAlertを抽出するKQLの一例です。 githubscanaudit_CL | where event_s == "code_scanning_alert" and action_s == "created" | extend alert = parse_json(alert_s) | extend scan_url = alert.html_url, path = alert.most_recent_instance.location.path, severity = alert.rule.security_severity_level, description = alert.rule.description, message = alert.most_recent_instance.message.text | where severity == 'critical' | project TimeGenerated, scan_url, path, severity, description, message, alert Code scanningのCriticalなAlertを抽出し、 scan_url や path 、 severity 、 description 、 message を表示しています。 scan_url はGitHubのWeb UI上でAlertの詳細を確認するためのURLで、こちらでコード上の脆弱な箇所を確認できます。 Secret scanningでのAlertの抽出も似たようなKQLで抽出できます。以下はSecret scanningのAlertを抽出するKQLの一例です。 githubscanaudit_CL | where event_s == "secret_scanning_alert" and action_s == "created" | extend alert = parse_json(alert_s) | extend scan_url = alert.html_url, secret_type = alert.secret_type_display_name, validity = alert.validity | where validity == "active" or validity == "unknown" | project TimeGenerated, secret_type, scan_url, validity, alert Secret scanningのAlertでは シークレットの有効性 を示す validity があり、 active や unknown のものを抽出しています。トリアージを行う際にこの値は指標となるので、有効化しておくと良いでしょう。こちらの ドキュメント が参考になります。 Sentinelでこれらの分析ルールを作成すれば、他の監視ルールと同様にAlertをSlackやメールなどで通知し、SOC業務の中で監視できます。 Push Protectionの設定 GHASのSecret scanningの機能には Push Protection という機能があります。これは、GitHubにPushされる前段階でシークレットを検出し、Pushをブロックする機能です。GHASの機能の中で一番心踊る機能ですね。 エンジニアが開発中において誤ってシークレットをPushする前にブロックできるので、予防的対策として非常に有効な機能です。ZOZOではこのPush Protectionを有効化するにあたって、いくつか手順を踏みました。 ZOZOでは開発体験を損なわないためにPush Protectionによるブロック、そして誤検知の頻度に着目しました。2か月ほど様子見を行い、検知されるシークレットはAlertで対応するといった運用をしていました。 2か月の運用で、おおよそ1か月で20Alertほど上がることが確認できました。ただ、このAlertは1つのリポジトリに対して複数のシークレットが検出されるので、シークレットのPush頻度で言えば2週間に1度あるかないかの頻度でした。この辺りはGitHubのSecurityタブの「Overview」などから視覚的に確認できます。 また、誤検知についてはあまりなく、 FirebaseのAPI key などコード上に記載できる特殊なシークレットを除いては、とても正確な検知でした。 そのため、Push Protectionを有効化しても開発体験を損なうことはないと判断し、Push Protectionの有効化することにしました。 また、Push Protectionにはバイパス機能があり、ブロックされたシークレットをエンジニア自身が確認でき、以下のように自身でPushを許可できます。 Push Protectionのバイパス このバイパス機能によってシームレスな開発が可能です。 Push Protectionの全社展開後のブロック数やバイパス数は以下のようにSecurityタブの「Secret scanning insights」から確認できます。 Secret scanning insights こういった視覚情報でリポジトリのシークレットの状況を確認できるのは非常に便利です。 Code scanningのAlertの対応 Code scanningで検出された脆弱性のAlertは、Securityタブの「Code scanning」から確認できますが、開発中のPRでもAlertを上げてくれます。また、以下の「Copilot Autofix」を有効化していれば、GitHub Copilotのライセンスを利用しなくても 1 、Copilotが脆弱性の修正案を提示してくれる機能もあります。 Copilot Autofix これらの機能を活用して、エンジニア自身に開発中のセキュアコーディングを実施してもらうことができます。SOCでのAlert対応はこの機能で修正されなかったもののうち、重大なものに対して対応する形になります。 ZOZOにおいてセキュアコーディングは実践すべき重要な取り組みです。これにより、SentinelへのAlertの発生を抑制し、SOCチームはログ解析やインシデント対応といった業務 2 に注力できます。Copilotの活用は、セキュアコーディングを強力に支援し、開発チームやSOCチームの生産性向上にも寄与します。 実際に以下のような脆弱なFlaskアプリを作成してみました。 脆弱なFlaskアプリ この脆弱なコードを含むPRを作成すると、Code scanningのActionsが実行されます。 Code scanning on PR Actionsが完了すると以下のように脆弱性が検知されます。 Uncontrolled command line Alert 「Copilot Autofix」を有効化していれば、PR上で修正案も丁寧に提案してくれて便利です。 Copilot Autofixによるコードの修正案 Flaskのデバッグモードも検知してくれました。 Flask app is run in debug mode このように開発段階で脆弱性を検知し、修正案を提示してくれる機能は非常に優秀で、助かっています。 以下は一時期のCode scanningのAlertの数です。Securityタブの「CodeQL pull request alerts」から確認できます。 CodeQL pull request alerts 38%ほどのAlertに対してCopilotが修正案を提示してくれており、そのうち12.5%はCopilotの修正案を適用してAlertを解消してます。修正判断をしたAlertにおけるCopilotの提案をそのまま受けて修正した平均時間が12.98時間ほどです。また、Copilotから修正案が提示されなかったAlertにおける修正した時間が175.98時間(約1週間)ほどです。これらから、単純に163時間(6日以上)をCopilotの修正案で削減できていることがわかります。 「Copilot Autofix」の機能はZOZOでのセキュアコーディングにおいて非常に強力であることがわかります。 Secret scanningのAlertの対応 Secret scanningで検出されたシークレットのAlertは、Push Protectionを有効化している場合は基本的にPush Protectionによってブロックされます。ですが、Push Protection有効化前にPushされたものはブロックされません。 例えば、誤ってPushしてしまったシークレットに対して記載されているファイルを削除したとしても、コミットログなどにその情報は残ったままです。そのため、 git show などのコマンドでシークレットが確認できてしまいます。 そのため、以前にPushしてしまったいにしえの伝統のリポジトリなどはこういったシークレットが残っている場合があります。これらのシークレットに対してもGHASのSecret scanningは検出してくれます。 少数検知の場合は都度プロダクトチームに修正依頼をする形でも良いのですが、数が多い場合は何か共通の管理シートのようなものが必要になってきます。ZOZOではGHASのSecurityタブを確認できる対象者を絞っているので、プロダクトのエンジニア全体に一気に共有できる別の方法を模索しました。 以下のようにSecurityタブの「Overview」にてFilterを用いて対象を絞りつつ、「Export CSV」で対象のAlertをCSV形式でエクスポートできます。 Export CSV これで対象となるAlertを出力し、全体を管理するためのシートを全社に展開することで、プロダクトチームに対してシークレットの修正対象を共有できました。このCSV自体にシークレットは載らず、リポジトリ個別のAlert URLに繋がる情報が含まれるので、そのURL経由で各プロダクトに対して、Alertの詳細を確認してもらうことができます。 以降の修正の流れはシークレットの提供元でシークレット無効化作業や、 公式ドキュメント に沿って修正する形になります。地道な作業ですが、プロダクトのエンジニアの協力を得て、シークレットの修正をしました。 徐々にシークレットの修正が進んでいき、GHASのSecret scanningのAlertも減少していきました。 Secret scanning Alert こういった情報も上記のようにOverviewから確認できます。 まとめ GHASの導入によって、ZOZOにおけるセキュアコーディング環境がより整備され、開発者がセキュリティを意識した開発をしやすくなりました。特にCode scanningやSecret scanningの機能は、開発段階での脆弱性検出やシークレット漏洩防止に大きく貢献しています。また、Copilot Autofixの機能を活用することで、脆弱性の修正も効率的に行えるようになりました。 おわりに ZOZOでは、一緒に安全なサービスを作り上げてくれる仲間を募集中です。ご興味のある方は、以下のリンクから是非ご応募ください! corp.zozo.com コードスキャンに対するCopilot Autofixの責任ある使用 ↩ DefenderでもMacを守りたい ↩
.table-of-contents ul ul { display: none; } はじめに こんにちは。WEARバックエンド部SREブロックの 春日 です。 6月25日、26日の2日間にわたって開催された AWS Summit Japan 2025 に、今年もZOZOのSREが多数参加しました。この記事では、現地の様子とSREのメンバーが各自選んだ面白かったセッションについてご紹介します。 はじめに AWS Summit Japanとは 会場の様子 セッションレポート 生成 AI オブザーバビリティのベストプラクティス(AWS-49) コンポーネントレベルのメトリクス RAG、エージェント、チェーントレース 高度な指標と分析 エンドユーザーからのフィードバック 責任あるAIに向けて: 生成AIアプリケーション評価のアプローチ (AWS-52) セッションのテーマと課題 セッションのポイント1 生成AIアプリケーション自体の評価方法 セッションのポイント2 生成AIアプリケーション構成要素の評価方法 1. 基盤モデルの評価 2. RAGの評価 3. エージェントの評価 セッションのポイント3 信頼性を高める評価戦略 Bedrock Guardrailsの日本語対応を確認する アップデート内容と留意点 日本語フィルタリングの動作検証 まとめ AI Agent 時代のソフトウェア開発の型 〜 Everything as Code で叡智を伝える 〜(AWS-57) ソフトウェア開発におけるAIの進化 AIに自律的に意図通りに動いてもらうには 組織内でAIの価値を認識させるには 感想 GenU × Amazon Bedrock による実装への挑戦-オイシックス・ラ・大地が実現した 333 時間の工数削減の技術解説(CUS-38) メルマガ作成業務の課題 生成AIを活用したメルマガ作成PoCとそこで見えてきた課題 GenUのカスタマイズ 結果 セッションの感想 AIを使う? AIに使っていただこう。AI が考えた次の⾏動と実アクションの実践的Agent アプローチ(AWS-55) 内容 感想 SmartNews における1000+ ノード規模 K8s 基盤 でのコスト最適化 – Spot・Graviton の大規模導入への挑戦(CUS-33)(CUS-33) 背景:成長とともに増大したインフラコスト 戦略:動的かつ柔軟なリソース運用へ 技術課題と解決アプローチ Karpenterのカスタマイズでスケーリング最適化 可視化による納得感の醸成 スポットの安定運用に向けた仕組み プロダクトチームとの連携による推進力 最適化の成果 まとめ おわりに AWS Summit Japanとは www.youtube.com AWS Summit Japanは延べ4万人以上が参加する日本最大の「AWSを学ぶイベント」です。今年も幕張メッセで2日間にわたり開催され、160以上のセッション、270以上の展示が行われました。ライブ配信も行われ、2025年7月11日までの期間限定でオンデマンド配信が視聴可能です。 aws.amazon.com 会場の様子 多くの参加者で賑わう会場。 撮影:春日 撮影:春日 今年も先着4000名にお弁当引換券とクッションが配布されました。余ったお弁当は引換券がない方も先着で貰えたようです。 撮影:酒部 撮影:花房 今回ラウンジはAWS認定者だけではなく、誰でも利用可能になっていました。場所はインフォメーションの周りと壁際に沿うように複数に用意されており、多くの人が利用できるようになりました。 撮影:春日 撮影:春日 1日目の18:10からは基調講演の会場でQuizKnockと直接対決できるAWSクイズ大会が開催されました。全員が参加可能なWeb上での予選を勝ち抜いた上位5人が登壇し、QuizKnockのメンバーと早押しクイズで対戦しました。結果は挑戦者チームの勝利でした。 撮影:春日 AWS Builders' Fairでは1日ごとにブースの出展が変わりました。実際に体験可能な展示や動く展示などがあり、楽しみながら学ぶことができました。 撮影:春日 撮影:江島 サーバーレスで構築されたコーヒー注文システム。定期的に発行されるQRコードを読み取ることで実際に注文が可能でした。 撮影:春日 「アーキテクチャ道場2025 - 実践編!」セッションではZOZOTOWNの話も。依存システムの関係ですぐにはDBをオンプレミスからクラウド移行できない制約の元、人気商品によるアクセス集中でもスケールできる設計事例が紹介されました。 撮影:花房 誰でも書けるボード。ZOZOのロゴがどこに書かれているかぜひ探してみてください! 撮影:春日 正解はここでした。 撮影:花房 セッションレポート ここからは現地参加したZOZOのSREが気になったセッションを紹介します。 生成 AI オブザーバビリティのベストプラクティス(AWS-49) 生産プラットフォーム開発部SREの塚本です。普段は、受注生産の仕組みを提供している、生産支援プラットフォーム「 Made by ZOZO 」の開発に携わっています。 生成AIを活用したシステムは、既に多くの商用環境で利用されるようになっています。私の部署内でも生成AIを活用したツールの開発が進んでいます。これらのシステムが単に機能するだけでなく、継続的に改善されていくためには、オブザーバビリティ(可観測性)に基づいた計測と分析が不可欠となります。このセッションでは、生成AIシステムを深く計測し、改善していくための階層型アプローチが説明されていました。 このアプローチは4つのレイヤーで構成されています。 オブザーバビリティを計測するための階層型アプローチ コンポーネントレベルのメトリクス システムの基盤となる各コンポーネントから発行されるメトリクスを活用します。セッションでは、サービスの呼び出しエラー、レイテンシー、リソース使用率などの基本的なメトリクスが紹介されました。また、Amazon CloudWatchの複合アラームを使用することで、集約されたレベルでアラームを設定し、アラートノイズを削減できる点が強調されていました。 コンポーネントレベルのメトリクス RAG、エージェント、チェーントレース RAG(検索拡張生成)やエージェントベースのアーキテクチャでは、一連のリクエスト処理全体を追跡するトレースが重要です。発表では、ユニークなTrace IDを設定することで、各サービス間での処理の流れを追跡する仕組みが説明されました。特に、OpenTelemetry (OTel) を用いたトレースの伝播がデモンストレーションで紹介されており、複雑なオーケストレーションレイヤーの可視化に有効であることが紹介されていました。 RAG、エージェント、チェーントレース 高度な指標と分析 より深いオブザーバビリティとして、高度な指標と分析が挙げられます。Amazon Bedrockのガードレール機能を利用した場合、ガードレールによって制限された結果をメトリクスとして出力し、可視化できます。これにより、設定したポリシーの遵守状況を監視し、必要に応じて調整できます。 高度な指標と分析 エンドユーザーからのフィードバック 最後に、エンドユーザーからのフィードバックをオブザーバビリティのループに組み込むことで、潜在的な問題を早期に発見し、ユーザー体験の改善に繋げます。ここでは、CloudWatch Embedded Metric Format (EMF) を活用し、フィードバックを含むログからメトリクスを自動的に抽出し、評価する方法が紹介されました。これにより、ユーザーの定性的なフィードバックを定量的な指標として捉えることが可能になります。 エンドユーザーからのフィードバック このセッションは、生成AIアプリケーションの改善アプローチの全体像から、各レイヤーでの具体的なオブザーバビリティの実装方法まで、デモンストレーションを交えながらとても明快に説明されていました。今後、オブザーバビリティによる継続的な改善サイクルを回し、より良いユーザー体験に繋がる生成AIアプリケーションの開発に取り組んでいきたいと改めて感じました。 責任あるAIに向けて: 生成AIアプリケーション評価のアプローチ (AWS-52) EC基盤開発本部SRE部商品基盤SREブロックの佐藤です。私は「 責任あるAIに向けて: 生成AIアプリケーション評価のアプローチ 」というセッションに参加しました。 セッションのテーマと課題 本セッションの主題は、生成AIアプリケーションを本番環境へ安全にデプロイする際、どのように評価と信頼性を確保するかという点でした。登壇者は、次のような課題を提示しています。 従来のAIモデルは特定ユースケースに最適化されていたのに対し、基盤モデル(FM)は複数ユースケースに対応できる反面、アプリケーション全体の複雑性が増している。 品質を確保しつつ開発速度(アジリティ)も維持する必要があるが、過度な分析や対策をとるとリリースが停滞し、本番環境のインシデント防止とのバランスを取ることが難しい。 これらの課題を解決し、品質とリスクの両面で自信を持つためには、本番デプロイ後も含めた一貫したテストと評価の仕組みを構築することが重要であると強調していました。 セッションのポイント1 生成AIアプリケーション自体の評価方法 生成AIアプリケーションには、従来のアプリケーションにはない「信頼性とリスクが許容範囲内に収まっているか」という評価観点があり、その評価手法として次の3つのアプローチが紹介されました。 アプローチ 概要 主なメリット 主なデメリット 1. 人間による評価(手動) 人間が直接出力を確認し、品質を判定する。 高い精度と信頼性が得られる。 時間とコストが多く、スケールしにくい。 2. 経験則に基づく評価(自動) 機械的に計算可能なスコアリングを用いる手法。 高速・スケーラブル・実行コストが低い。 人間の評価と結果が一致しない場合がある。 3. AIによる評価(LLM-as-a-Judge) LLMを評価者としてプロンプトする手法。 柔軟に評価観点をカスタマイズできる。 評価モデルのバイアスや推論コストが課題。 経験則に基づく評価、AIによる評価のどちらを選ぶにしろ、人間による評価との整合性を定期的に確認し、キャリブレーション(補正)を行うことを推奨していました。 セッションのポイント2 生成AIアプリケーション構成要素の評価方法 次に、生成AIアプリケーションを構成する3つの要素(基盤モデル・RAG・エージェント)について、それぞれに適した評価手法が紹介されていました。 1. 基盤モデルの評価 評価方法 手法 補足 モデル比較 リーダーボードを利用する。 ベンチマークは自社ユースケースと必ずしも相関しない点に注意。 Bedrockでの評価 Bedrockの「モデル評価」機能を利用。 - 人手評価・経験則メトリクス・LLM-as-a-Judgeから選択可能。 - カスタムインポートモデルも評価可能。 SageMakerでの評価 OSSライブラリ「 fmeval 」を使用。 独自の評価セットを利用可能。 2. RAGの評価 評価方法 手法 補足 Bedrockでの評価 Bedrock Knowledge Basesの「RAG評価」機能を利用。 検索エンジン単体、または検索+生成をまとめて評価可能。 高度なカスタム評価 OSSフレームワーク「 Ragas 」を使用。 Bedrockの評価を使用したうえでチューニングしたい場合に利用。 3. エージェントの評価 評価方法 手法 補足 ユーザーとエージェントとの対話テスト 「 agent-evaluation 」フレームワーク。 - YAMLでテストケース(ユーザー入力と想定結果)を記述。 - LLM-as-a-Judgeで対話成立を評価。 - CI/CDで実行可能。 セッションのポイント3 信頼性を高める評価戦略 「リスク評価」の観点でリリースの信頼性を上げるために、以下7段階の評価プロセスによる評価戦略が紹介されていました。 ステップ 内容 1. ユースケース定義 扱う情報(例:ヘルスケア、金融など)によって潜在リスクが異なるため、リリースへの影響度を整理する。 2. リスク評価 NIST AI Risk Management Framework に基づきリスクを洗い出す。 次に、発生確率と影響度を掛け合わせたリスク評価マトリックスでリスクレベルを決定する。 3. メトリクス選定 評価の目的とリスクに対応するメトリクスを選定する。 4. リリース基準策定 リスク評価マトリックスを基に、どのレベルを満たせばデプロイ可能かを策定する。 5. 評価データセット設計/測定 自動評価と人間評価を組み合わせ、ユースケースに沿ったデータセットを作成して測定をする。 6. 結果の解釈 限られたポイントのメトリクスだけで判断せず、分布や信頼区間を確認し、過度な一般化を避ける。 7. リスク緩和戦略 入力・出力フィルタリングを実施する。Amazon Bedrock Guardrailsは、このフィルタリングを実現するツール。 Bedrock Guardrailsの日本語対応を確認する セッションでも触れられていましたが、6月25日(AWS Summit初日)にAmazon Bedrock Guardrailsが日本語をサポートした旨がアナウンスされました。 Amazon Bedrock Guardrails announces tiers for content filters and denied topics アップデート内容と留意点 日本語に対応した機能 コンテンツおよびPrompt Attackフィルター 拒否トピック 日本語に未対応の機能 ワードフィルター 機密情報フィルター コンテキストグラウンディングチェック 設定の留意点 Content Filters tierはStandard Filters Tierを選択する必要がある。 Standard Filters Tierはクロスリージョン推論が必須となるので、国内リージョン内に処理を閉じたい要件がある場合は留意する必要がある。 日本語フィルタリングの動作検証 クロスリージョン推論(Cross-Region inference)を有効化し、Standard Filtersを指定して「拒否されたトピック」の「定義」を日本語で設定します。 「拒否されたトピック」の「定義」を日本語で設定する 日本語プロンプトでテストを実行したところ、暴力表現を含む質問は「Violence」などのコンテンツフィルターにより拒否されました。 暴力表現を含む質問は「Violence」などのコンテンツフィルターにより拒否される Prompt Attackや拒否トピックについても同様に、日本語入力でフィルタリングが成功することを確認しました。 Prompt Attackによってフィルタリングされる 拒否トピックによってフィルタリングされる まとめ 本セッションを通じて、モデルの精度だけではなく「責任あるAI」という視点が重要であると認識しました。また、評価そのものの信頼性をどのように担保するかについても多くの示唆を得ました。まずは自社サービスのユースケースを整理し、固有の課題を正確に把握したうえで、リスクを継続的に管理する評価戦略を実践する必要があります。弊社ではマイクロサービスをリリースする際に「プロダクションレディチェック」を実施していますが、今回学んだ知見を取り入れることで、生成AIアプリケーション向けの新しいチェックリストとして発展させられると感じました。 AI Agent 時代のソフトウェア開発の型 〜 Everything as Code で叡智を伝える 〜(AWS-57) 検索基盤SREブロックの花房です。普段はZOZOTOWNの検索関連マイクロサービスにおけるQCD改善やインフラ運用を担当しています。 弊社では現在、業務の効率化を目的とした生成AIの導入が進められています。私自身もソフトウェア開発やシステム運用の効率化のために生成AIの活用に取り組んでおり、その情報収集の一貫として本セッションに参加しました。本セッションで学んだ内容を以下にまとめます。 ソフトウェア開発におけるAIの進化 ソフトウェア開発においてAIは飛躍的な進化を遂げました。コーディング支援のレベルは下記の3つに分けられ、現在のAIはレベル3まで到達しています。 プログラムによるメソッドなどの補完、リファクタリング AIによるインラインのコード補完、チャットでのコード生成 AI Agentによる自律的な探索、コード修正、テスト レベル3では人間の詳細な指示が必要ですが、ドライバーをAIに交代できます。AIが進化を続けるとレベル3の先のレベル4に到達すると考えられます。レベル4ではAIのみで長時間の自動運転が可能になると予想されます。そのような未来に備えて、今からAIを中心としたソフトウェア開発の型を身に付けておく必要があります。 AIに自律的に意図通りに動いてもらうには AIを活用した開発でよくある悩みは、AIが意図通りに動いてくれないことです。AIは確率的に行動を決定しているため常に期待通りの振る舞いをするとは限りません。AIの振る舞いの精度を高めるには指示や制約を言語化して与えておく必要があります。しかし、全ての意図を言語化することは困難です。そこで、言語化できない部分のコンテキストをAIへ伝えるためにコードを利用します。 ここで紹介されたものが「Everything as Code」です。 Everything as code is a software development practice that seeks to apply the same principles of version control, testing, and deployment to enhance maintainability and scalability of all aspects of the development lifecycle, including networking infrastructure, documentation, and configuration. Everything as code - DevOps Guidance より引用。 人間がソフトウェア開発に関する全てをコードで表現しておくことによりAIが得られる情報は自然に増加します。コードはプレーンテキストであり、AIにも理解しやすい形式であるためです。意図した通りAIに動いてもらうには、上記のようにAIが自律的に必要な情報を探せる状態を作ることが重要です。 組織内でAIの価値を認識させるには ビジネスの目的はユーザーに多くの価値を届けることです。組織内にAI活用の能力を獲得させることができれば、より多くの価値を届けることが可能になります。しかし、組織内でAI活用の価値を言葉で説明しても受け止め方は人によって様々です。説明を聞いて一部のタスクを完全にAI任せにできる人もいれば、AIを使いこなせていない人も現れます。 言語による説明だけでは価値が伝わらず、時間をかけてマスタして初めて気づく価値は存在します(例:Vimキーバインド、空手)。そのため、今は価値に気づかれないとしても基本の型を組織で続けておくことが重要です。AIを中心としたソフトウェア開発における基本の型は「Everything as Code」です。 感想 AIが意図通りに動かないのはそういうものだと少し諦めており、振る舞いの精度を高められる方法がもしあれば知りたいと思っていました。本セッションに参加したことで、その方法の1つである「Everything as Code」を知ることができました。コードの表現であればAIだけでなく人間同士でも意図を伝えられるため、非常に有用なプラクティスだと感じました。 私も生成AIの活用の推進している中で、口頭での説明だけだと生成AI活用の価値を伝えるには不十分だと感じていました。本セッションを通じて、今は価値を完全に理解されずとも、今後のためにAIを中心としたソフトウェア開発の型を組織で実践しておくことが重要だと認識を改められました。 引き続き、本セッションで得られたプラクティスやヒントを元に生成AIの活用を推進していきたいと思います。 GenU × Amazon Bedrock による実装への挑戦-オイシックス・ラ・大地が実現した 333 時間の工数削減の技術解説(CUS-38) WEARバックエンド部SREブロックの春日です。普段は WEAR by ZOZO というサービスのSREとして開発・運用に携わっています。私からは「 GenU × Amazon Bedrockによる実装への挑戦-オイシックス・ラ・大地が実現した333時間の工数削減の技術解説 」というセッションをご紹介します。 メルマガ作成業務の課題 メルマガ作成業務の課題として、以下が挙げられていました。 1回のメルマガにかかる工数が大きい 作成者のスキルによって品質維持が難しい メルマガを配信するまでにはメルマガ原稿の作成後、法務による表現の校正と原稿の修正作業が繰り返し発生します。表現の校正というのは例えば、「業界No.1」「ダイエットに効果的」といった、景品表示法や薬機法によって禁止されている表現がされていないか確認しているとのことでした。こういった校正作業により工数がかかるようです。 生成AIを活用したメルマガ作成PoCとそこで見えてきた課題 コンテンツ生成が得意である生成AIを活用し、メルマガ作成業務における工数を削減しつつ品質を維持できないかと考えます。生成AIを用いてメルマガを作成するPoCを行ったところ、生成AIが作成したメルマガの方がCVRが上がったとのことでした。PoCは Generative AI Use Cases(GenU) を用いて行われました。GenUは生成AIを活用する環境構築を1クリックで行えるアプリケーションで、Web UIから簡単に Amazon Bedrock を使用できます。 しかし、デフォルトのGenUを使用するだけでは、いくつか課題が見つかりました。 メルマガの内容は毎回変わるためメルマガ生成プロンプトの作成難易度が高く、結局人間が原稿を作成するのと同じくらいの時間がかかる 景品表示法や薬機法にかからないような、メルマガ専用の校正機能が必要 これらの課題を解決するために、GenUをカスタマイズすることになりました。 GenUのカスタマイズ GenUにメルマガ作成機能とメルマガ校正機能を追加します。メルマガの文章構成はある程度決まっていることから、動的部分だけを入力すれば自動でプロンプトが生成されるようになっています。また、過去のメルマガのサンプルを複数用意して参考にするようにプロンプトで指示することでも構成を踏襲させているようです。ここのサンプルの選定に偏りがあると、おせちの内容でも夏を感じる文章になってしまうなど意図しない出力がされてしまう課題があったようでした。これはサンプルの選定を季節に依存しないものへすることで改善されたとのことです。 メルマガ作成機能 メルマガ校正機能も生成AIを用いて実装されています。社内ドキュメントで管理されている表現チェックリストを用いて、プロンプトにNG表現や言い換えを組み込むことで検出します。NG表現に似たニュアンスの問題ない表現もNGとして検出されてしまうことがあったため、チェックリストに「完全一致する場合のみ」指摘するようにプロンプトを調整することで改善されたとのことでした。 フロントエンドもデフォルトのものからReactで自前実装されています。動的な入力事項の必須項目化や、追加項目の折りたたみ表示、NG表現とOK表現の色分けなど、UI/UXの改善が行われています。手間をかけてでもユーザ体験を向上させたい場合は、追加実装がおすすめとのことです。 自作のフロントエンド 結果 結果として、1か月あたりのメルマガ作成工数が133時間、校正の工数が200時間削減され、合計333時間の工数削減に成功したようです。また、人が作成したメルマガに比べてCVRが200%向上したとのことでした。品質の担保や特定社員の負荷軽減も成功したとのことでした。 セッションの感想 人が作成したメルマガに比べ、生成AIによって作成された方が200%もCVRが向上したというのは驚きでした。また、メルマガ生成部分と校正部分の2軸でそれぞれ生成AIを活用するという部分が特に印象的でした。一度で完璧なメルマガを生成するよりも、それぞれで特化したプロンプトを用意する方が効果的なのかもしれません。プロンプトチューニングのTipsもあり、非常に参考になりました。今回学んだ内容を業務にも活用していきたいと思います。 AIを使う? AIに使っていただこう。AI が考えた次の⾏動と実アクションの実践的Agent アプローチ(AWS-55) フロントSREブロックの江島です。ZOZOTOWNのエンドユーザーに近い部分(フロントエンド、BFF等)を担当領域としています。また、全社のAWS管理者としての役割も担っています。 内容 今年のAWS Summitも昨年度に引き続いて生成AIに関するセッションが盛り沢山でした。 一方で、私自身は生成AIの技術に関するキャッチアップが十分に出来ていないと感じていました。そこでこの2日間は生成AI関連のセッションに注力する姿勢で臨みました。 その中でも今回は「 AIを使う? AIに使っていただこう。AIが考えた次の⾏動と実アクションの実践的Agentアプローチ 」というセッションについてまとめたいと思います。 AIを使う?AIに使っていただこう。AIが考えた次の⾏動と実アクションの実践的 Agent アプローチ LLMには最新情報にアクセスできないという課題があります。LLMは大量の学習によって過去に何が起きたのかは知っていますが、学習後に生じた最新情報にはアクセスできません。一方で、LLM単体では直接回答できない情報であっても、答えに辿り着くためのアプローチは提案できます。そこで、LLMの持つ課題を解決するために、LLMにツールを持たせるという考え方が生まれました。 LLMとToolが繋がれば外部世界と連携できる しかし、LLMにツールを持たせる際には、以下のような課題が発生します。 ハルシネーション(ツールを使用していないにもかかわらず、使用したかのように応答すること) ツールの情報漏洩(LLMが利用可能なツールを漏洩し、悪用される可能性があること) 不定な応答フォーマット(LLMの応答テキストの中からツール実行に必要な情報を正確にパースすることが難しいこと) これらの課題を解決するために、Tool Use専用の構文を使うアプローチが採用されました。Amazon Bedrockではこの機能がTool Useとして提供されており、以下の3つの特徴を持っています。 ユーザーメッセージやシステムプロンプトと分離したTool専用の引数:ツールを漏洩したり、ハルシネーションを防いだりするのに役立つ Tool利用時は通常のテキストレスポンスとは分離された出力:ツール使用時のパースが容易になる Tool実行結果も分離して入力:Tool実行結果のLLMによる解釈が容易になる このTool Useは以下のようなフローで処理が実行されます。大まかには、利用可能なツールとその使い方をあらかじめLLMに定義しておき、LLMがツールの実行を指示しなくなるまでツールの実行とその結果のモデルへのフィードバックを繰り返すという流れです。 Tool Use フロー このセッションのタイトル「AIを使う?AIに使っていただこう」に関連して、発表者からは、エンジニアの視点ではAIを直接使うというよりも、AIにツールを使ってもらうための「下準備」(ツールの開発や説明など)をすることが重要であるという点が強調されました。これは最近話題となっているMCP等の技術にも共通する考え方です。 さらに、ツールを用いることで生成AIアプリケーションをエージェントとして動作させる上で、どこまでをエージェントに任せるか(人間の介入度合い)を検討することが非常に重要であると説明されました。介入の度合いは、「必ず人間が介入」「部分的にAgent」「全部Agent」の3段階で考えられ、ユースケースに応じて適切なバランスを見つけることが推奨されます。 あなたの Agent のちょうどいいところは? このようなエージェント開発をより容易にするため、AWSはAmazon Bedrock Agentsという機能を提供しています。Amazon Bedrock Agentsは、LLM、ツール、Knowledge Basesの間でオーケストレーターとして機能し、開発者の負荷を低減します。 感想 このセッションを聴講することで、まずLLMが不得意とすること(特に最新情報へのアクセスと推論の精度)を深く理解できました。また、それらに対してツールという解決策が提唱され、そこから様々なことをAIにやらせようというエージェント化の流れに繋がっているんだということが整理できました。 AWSが提供しているBedrockのTool Use機能を用いた実装の流れを知ることで、Agentとして働く生成AIアプリケーションが思考を繰り返す流れを具体的に理解できました。今回学んだ内容を通じて、実際の業務でも生成AIアプリケーションを使った業務改善に取り組んでいきたいと感じました。 SmartNews における1000+ ノード規模 K8s 基盤 でのコスト最適化 – Spot・Graviton の大規模導入への挑戦(CUS-33)(CUS-33) フロントSREブロックの徐です。ZOZOTOWNのエンドユーザーに近い部分(フロントエンド、BFF等)を担当領域としています。 SREにとって、インフラの信頼性を守ることと同じくらい重要なのが、持続可能なコスト管理です。日々の運用の中で、どこまで効率的に、そして大胆にコスト削減に挑めるかは常に意識すべきテーマだと感じています。今回ちょうどスマートニュース社がこのテーマで登壇するセッションがあったため、その取り組みを知りたいと考え、参加しました。 背景:成長とともに増大したインフラコスト スマートニュースでは、大規模なEKSクラスター上にFlink、Kafka、ClickHouseなどのプラットフォームを構築し、機能開発を重視してきました。しかしその結果、ユーザー数の増加以上のスピードでコストが増大し、体系だったコスト管理が必要なフェーズに突入しました。リソース使用量が全体の50%以上に達していたことを受けて、インフラとプロダクトを横断する形でコスト最適化プロジェクトが立ち上がりました。 背景:成長とともに増大したインフラコスト 戦略:動的かつ柔軟なリソース運用へ 戦略:動的かつ柔軟なリソース運用へ Reserved InstanceやSaving Planといった固定的なコスト対策だけでは、トラフィックの変動や将来的な成長に対応するには不十分でした。スマートニュースでは、柔軟性と機動力を重視したアプローチとして、スポットインスタンスの活用を全社的に推進し、Gravitonアーキテクチャの導入を段階的に拡大しています。また、EKSクラスターのスケジューラーにはKarpenterを採用し、要件に応じて改修を加えることで、高速かつ安定したスケーリングを実現します。これらの取り組みの効果を定量的に把握するため、コストやリソース使用状況を可視化するダッシュボードも構築されています。 技術課題と解決アプローチ スマートニュースが直面した技術的課題は、成長に伴うインフラコストの増加に加え、スポットインスタンスやGraviton導入に対する開発側の不安、そして複雑なスケジューリング設計への対応でした。この課題に対し、スマートニュースではインフラチームとプロダクトチームが連携し、社内セッションによる知識の底上げを行うとともに、サービスごとのSLAや中断対応方針の整理を進めました。加えて、Karpenterの改修によってスケーリング性能の最適化を図り、可視化ダッシュボードの整備を通じてコスト構造の把握と運用判断の精度向上にも取り組んでいます。 Karpenterのカスタマイズでスケーリング最適化 Karpenterのカスタマイズでスケーリング最適化 スポットインスタンスの活用には、柔軟かつ高速なスケジューリングが不可欠です。Karpenterの導入にあたり、スマートニュースでは複数のカスタマイズを施しました。具体的には、CPU使用率が閾値を下回った場合にスケールインを行う制御や、処理済みのペンディングポッドが存在する場合には一定時間スケールアウトを抑制する仕組みを実装。また、スポットインスタンスの中断通知をトリガーとして即座に新しいノードを立ち上げることで、スケールアップにかかる時間を6分から3分へ短縮することに成功しました。 可視化による納得感の醸成 可視化による納得感の醸成 コスト最適化を組織として進める上では、関係者全員で納得できる透明性が欠かせません。スマートニュースでは、リアルタイムに利用状況とコスト構造を把握できるダッシュボードを構築しています。サービスごとのスポットインスタンスとオンデマンドインスタンスの使用比率やコスト推移をはじめ、スポットの中断発生やキャパシティ不足の頻度、各インスタンスタイプのリソース利用効率なども可視化されており、運用判断や改善サイクルの精度向上に貢献しています。 スポットの安定運用に向けた仕組み スポットインスタンス利用時にオンデマンドインスタンスへ自動的にフォールバックしてしまう課題に対応するため、スマートニュースでは安定運用を実現するための仕組みを構築しました。まず、PreferSpotというラベルを導入することで、Podが可能な限りスポットインスタンスで起動されるよう明示的に指定しています。 仮にスポットインスタンスのキャパシティが確保できず起動に失敗した場合でも、一時的にオンデマンドノードで代替的に起動させることで可用性を担保します。そのうえで、一定時間が経過するとオンデマンドノードは自動でシャットダウンされ、再度スポットインスタンスでの起動を試行するように設計されています。このようにして、コストと可用性のバランスを取りつつ、スポットの安定活用を促進しています。 プロダクトチームとの連携による推進力 単なるインフラ最適化にとどまらず、プロダクトチームと密に連携しながら推進力を高めてきました。まず、VPの支援のもとで専任のタスクフォースを設置し、役割と権限を明確化することで迅速な意思決定を可能にしました。 また、ダッシュボードを通じてサービス単位や技術レイヤ単位でのコスト構造を可視化し、関係者全体のコスト意識を醸成しました。さらに、Javaのバージョン変更やシャットダウン処理の最適化など、比較的短期間で効果が見込めるQuick Win施策を積極的に展開したことで、主要コンポーネントにおいてスポット利用率が90%を超える成果を上げることができました。 最適化の成果 モニタリングシステム:100%スポットインスタンスへ移行 ランキングシステム:80%以上スポット化 MLインファレンス:100%スポット + 100% Graviton 全体のGraviton使用率:40%以上 最適化の成果 まとめ 今回の発表を通じて、スポットインスタンスやGravitonの導入、Karpenterの柔軟な活用が、単なるコスト削減にとどまらず、組織全体の技術成熟度を高めることにつながると実感しました。 特に可視化やSLAの整備によって、現場の納得感と判断の質が大きく向上していたのが印象的です。コストはSREにとって避けては通れないテーマであり、今後も技術と仕組みの両輪で継続的に向き合っていきたいと感じました。 おわりに 撮影:佐藤 オンラインでもセッションの視聴は可能ですが、実際に身体を動かすデモや現地のエンジニアとの交流など、現地参加ならではの体験もAWS Summitの魅力の1つです。今回得たたくさんの知見を今後の業務にも活用していきたいと思います。 ZOZOでは来年開催されるAWS Summit Japan 2026に一緒に参加してくれるエンジニアを募集しています。ご興味のある方は、ぜひ以下のリンクからご応募ください。 corp.zozo.com それではまた来年のAWS Summitでお会いしましょう!
.table-of-contents ul ul { display: none; } .images-row { width: 860px !important; } こんにちは、技術戦略部のikkouです。2025年6月17、18日の2日間にわたり「 KubeCon + CloudNativeCon Japan 2025 」がヒルトン東京お台場で開催されました。ZOZOは今回シルバースポンサーとして協賛し、スポンサーブースを出展しました。 technote.zozo.com 本記事では、前半はZOZOのエンジニアが気になったセッションを紹介します。そして後半はZOZOの協賛ブースの様子と各社のブースコーデのまとめを写真多めでお伝えします。 KubeCon + CloudNativeConとは ZOZOエンジニアの気になったセッションの紹介 Kubernetes SIG Node Intro and Deep Dive Platform Engineering Day 2: Why Service Iterations Are the Crux of Developer Platforms Internal Developer Platform(IDP) Golden Path Day 2 Best Practices Japan Community Day Doc Sprint参加レポート Japan Community Dayとは Doc Sprintの概要 当日の作業フロー 得られた学び 翻訳ガイドラインの理解と運用 コントリビューションの可視化とモチベーション コントリビューターロールの明確化 その他 まとめ Exploring Tenant-centric Strategies To Simplify Multi-cluster and Multi-cloud Complexities Infra / Platform Team目線 End use 目線 Cloud Native Scalability for Internal Developer Platforms セッション概要 1. Internal Developer Platform(IDP)の全体像 2. スケーラビリティの旅と直面した壁 (Scalability Journey in Our Internal Developer Platform) 2-1. クラスタ設計:Single vs Multi 2-2. オペレーショナルスケーラビリティ 2-3. カスタムコントローラ性能 3. いま直面している3つのControl Planeの課題 おわりに ZOZOブースの紹介 ZOZOTOWNのアーキテクチャ OSS デモ 協賛企業ブースのコーデまとめ おわりに KubeCon + CloudNativeConとは KubeCon + CloudNativeConは、ZOZOでも利用しているKubernetesをはじめとしたCloud Native Computing Foundation (CNCF)に関する技術を中心とした大規模カンファレンスです。これまではUSやEUなどで開催されていて、例年ZOZOのエンジニアも現地参加してきました。 KubeCon + CloudNativeCon Europe 2024 参加レポート - ZOZO TECH BLOG KubeCon + CloudNativeCon Europe 2023 参加レポート - ZOZO TECH BLOG KubeCon + CloudNativeCon North America 2022参加レポート〜3年ぶりのアメリカ現地開催の様子とセッション紹介〜 - ZOZO TECH BLOG 今回は「KubeCon + CloudNativeCon Japan」として初めて日本で開催されました。初回から想定を上回る1,500人の参加者が集まり、チケットも売り切れになったそうです。 ZOZOエンジニアの気になったセッションの紹介 今回、ZOZOからは10名を超えるエンジニアが参加しました。代表して5名から、それぞれが気になったセッションを紹介します。 Kubernetes SIG Node Intro and Deep Dive こんにちは、MLOpsブロックの 木村 です。「 Kubernetes SIG Node Intro and Deep Dive 」セッション(登壇者:Narang Dixita Sohanlal 氏[Google]、Paco Xu 氏[DaoCloud]、椎名宏典 氏[Independent])をご紹介します。 kccncjpn2025.sched.com このセッションでは、Kubernetesのノード周辺に関する最新機能についての発表が行われました。特に注目されていたのは、GPUのような特殊なリソースをPodやコンテナ間で柔軟にリクエスト・共有できるようにするための仕組みである Dynamic Resource Allocation (DRA) と、Podの再起動を伴わずにリソースの割り当てを変更可能とする機能 In-Place Pod Resize の2つです。どちらも、リソース使用量が変動しやすいワークロードを効率的に運用するうえで非常に有用なアップデート情報でした。 DRAは、これまでPod作成時に静的に確保されていたGPUなどの特殊リソースを、Podがノードにスケジュールされるタイミングで、ノード上の利用可能なデバイス状況に応じて柔軟かつ動的に割り当てるための仕組みです。これにより限られたリソースの利用効率を高めることができます。さらに、1つのGPUを複数のPodで共有したり、Pod側からデバイスの構成パラメータを細かく指定したりできます。この機能は、Kubernetes v1.32でベータ版として導入されました。 さらに、Kubernetes v1.33では、以下のアルファ機能が追加されました。 Partitionable Devices :物理GPUを分割して複数Podに割り当て、リソース効率を最大化 Device Taints and Tolerations :特定のPodにのみ特定デバイスを使わせる制御 Admin Access :DRAに管理者用のアクセス権限を導入 今後Kubernetes v1.34での正式サポート(GA)を目指して活発に開発が進められています。詳細については以下の公式ドキュメントをご参照ください。 https://kubernetes.io/blog/2025/05/01/kubernetes-v1-33-dra-updates/#what-s-next 次に紹介されていたIn-Place Pod Resizeは、既存のPodを削除せずにCPUやメモリのrequests / limitsを動的に変更できる機能です。これまでKubernetesではリソースを変更する際にはPodを再起動する必要がありましたが、この機能によって、Podを停止せずにリソース構成を変更できるようになります。 Kubernetes v1.27ではアルファ版として登場し、v1.33では以下の改善がありました。 --subresource=resize による明示的なリサイズAPIの提供 リサイズ反映までの時間が大幅に短縮され、即時対応が可能に 特に注目すべき点はダウンタイムの削減です。v1.31ではリソース変更の反映に60〜90秒ほどかかっていましたが、v1.33では即時で反映されるようになり、よりスムーズなリソース変更が可能になりました。 この2つの機能は、今後のKubernetesにおいて非常に重要な役割を果たすと考えられます。DRAによるGPUの細かな割り当て制御は、AI/MLの活用が進む中で高まるGPU需要に対し、限られたリソースをいかに効率よく活用するかという課題の解決に貢献します。また、In-Place Pod Resizeを活用することで、動的に変化するワークロードにも柔軟かつ迅速に対応することが可能になります。 特にDRAは、今回のKubeCon + CloudNativeCon Japan 2025でも複数のセッションで取り上げられており、コミュニティ内でも高い関心を集めているテーマであることが印象的でした。今後のバージョンアップを通じて、より高度で柔軟なリソース管理が実現されていくことに期待されます。SIG Nodeチームは、ノードやリソース管理の進化を牽引する存在であり、今後のアップデートにも引き続き注目していきたいです。 Platform Engineering Day 2: Why Service Iterations Are the Crux of Developer Platforms 計測プラットフォーム開発本部・システム部SREブロックの近藤です。「 Platform Engineering Day 2: Why Service Iterations Are the Crux of Developer Platforms 」セッション(登壇者:Puja Abbassi氏[Giant Swarm])をご紹介します。私の所属する部署では、既存プロダクトの開発・運用に加え、計測技術を活用したPoCや新規プロダクトの立ち上げにも取り組んでいます。そのため、KubeConの中ではやや異色に感じたセッションでしたが、普段の業務に通じる内容が多く、非常に実践的な学びが得られました。 kccncjpn2025.sched.com Internal Developer Platform(IDP) 本セッションでは、開発者体験(DX)を向上させるための基盤として「Developer Platform」が紹介されました。その中でも、社内での開発者向けに最適化された仕組みとして「Internal Developer Platform(IDP)」が取り上げられています。 Platform Engineering Day 2 Why Service Iterations Are the Crux of Developer Platforms P.4より引用 IDPのサービスアーキテクチャが図示されており、非常にわかりやすい構成でした。弊チームではリリース自動化には取り組んでいるものの、IDPとしての構成図は明確に描けていなかったため、この図に当てはめることで自分達が注力している部分(Applications / Services層)を再認識する良い機会となりました。 Golden Path セッション内で印象的だったキーワードのひとつが「Golden Path」です。これは、開発者が迷わず最適な方法でアプリケーションを構築・運用できるよう導く、標準化されたベストプラクティスの道筋と定義されています。新規プロダクトのスピーディな立ち上げが求められる弊チームにとって、Golden Pathの整備はDX向上の鍵であり、改めてその重要性を実感しました。 Platform Engineering Day 2 Why Service Iterations Are the Crux of Developer Platforms P.7より引用 Day 2 このセッションでは「Day 2」というフェーズが明確に定義されており、プロダクトがリリースされた後の運用・改善フェーズに焦点が当てられていました。セッション内でDay 2におけるアプリケーション開発者・プラットフォームエンジニアそれぞれの役割や課題が具体的に紹介されています。 Platform Engineering Day 2 Why Service Iterations Are the Crux of Developer Platforms P.10より引用 Platform Engineering Day 2 Why Service Iterations Are the Crux of Developer Platforms P.13より引用 Best Practices セッションの最後では、Day 2を見据えたベストプラクティスが紹介されていました。 Platform Engineering Day 2 Why Service Iterations Are the Crux of Developer Platforms P.26より引用 中でも「イテレーションをKPIとする」という考え方は、これまであまり意識できていなかった視点であり、非常に良い気づきとなりました。弊チームではPoCからプロダクトフェーズへの移行が多いため、継続的な改善を前提としたプラットフォーム設計と運用が今後ますます重要になると感じています。今回のセッションで得た知見を活かし、Golden Pathの整備や自己サービス化の推進など、開発者がより快適に開発できる環境づくりを進めていきたいと思います。 Japan Community Day Doc Sprint参加レポート EC基盤開発本部 SRE部 商品基盤SREブロックの佐藤です。私は Japan Community Day で開催された『 Doc Sprint 』に参加しました。 community.cncf.io Japan Community Dayとは Japan Community Dayの様子 KubeCon + CloudNativeConの開催前日に行われる実質0日目イベントで、 Cloud Native Community Japan が主催となって企画しています。 公式サイト のとおり、セッションやLTに加えてハンズオン型プログラムが充実しており、初参加の人でも気軽にOSSへ関われるのが大きな魅力です。今回は、その中で開催された『 Kubernetesドキュメント Doc Sprint 』に参加しました。 Doc Sprintの概要 目的: Kubernetes 公式ドキュメント日本語版 の品質向上と翻訳差分の解消 対象リポジトリ: https://github.com/kubernetes/website メンター:レビューとマージ権限を持つDocs Approver2名 当日の作業フロー リポジトリ準備 kubernetes/website をForkし、ローカルにclone。 ローカルプレビュー Hugoサーバーを起動し、ブラウザで該当ページを確認。修正前後の差分を比較。 ドキュメント編集 content/ja/docs/以下のMarkdownを修正。 PR作成 mainブランチにPull Requestを提出し、Reviewerをアサイン。 レビュー&マージ メンターが即時レビュー → LGTM → Approved → Merge。初のコントリビュートが、わずか数十分で完了しました。 得られた学び 翻訳ガイドラインの理解と運用 翻訳ルール(Localization Guide) にあるように、表記の統一や語彙の取り扱いには明確なルールが定められています。日本語訳では、下記の項目にあるような細かい議論が発生しやすいことを実感しました。それをApproverの方と直接相談できたのは貴重な体験でした。 長音記号(例:クラスター vs クラスタ)を使うか カタカナ表記または英語表記か 特に「node」のように文脈によって意味が変わる単語の扱い( 例 ) コントリビューションの可視化とモチベーション DevStatsダッシュボード を使うと、コントリビューターの国別・企業別・個人別の貢献状況などを確認でき、モチベーションアップに直結する仕組みがあることを知りました。自分の名前も実際に 確認できました 。 コントリビューターロールの明確化 Kubernetes Docsチームには明確な ロールと責任 があり、少しずつ経験を積んで、Reviewer・Approverへと進んでいける仕組みが整備されていました。 Anyone:定期的にコントリビュートする人。誰でもなれる。 Member:Issueのトリアージや非公式レビューが可能になる。 Reviewer:公式レビューをリードし、品質保証を担う。 Approver:マージ権限を持ち、ドキュメント全体の整合性を管理する。 その他 日本語翻訳は世界で3番目に活発な言語化プロジェクト(資料: Kubernetes SIG Docs Localization Subproject (ja) )。 とくにブログの翻訳は世界最速を目指している(記事が出た当日に徹夜で翻訳することもあるそうです!)。 活動を支えるために、小さなPRや更新の積み重ねが大切である。 Slack( #sig-docs-ja )で情報共有や相談ができる。 「このページに記載されている情報は古い可能性があります」バナーがついているページは、初心者に最適な貢献ポイント。 まとめ Doc Sprintは「Approverにすぐ相談できる」「PRがその場でマージされる」という即時フィードバックが魅力の学習環境でした。ドキュメントは常に改善余地があり、OSS初心者が成功体験を得やすい入口だと実感しました。今後も更新が滞っているページの刷新に取り組み、Kubernetes日本語ドキュメントの充実に貢献していきたいと思います。 最後に、機会をくださったApproverの皆さん、そして一緒に参加してくださった皆さん(ZOZOブースにもお越しくださりありがとうございました!)に感謝いたします。 Exploring Tenant-centric Strategies To Simplify Multi-cluster and Multi-cloud Complexities SRE部フロントSREブロックの三品です。私が所属するSRE部フロントSREブロックでは、ZOZOTOWNが持つAPIの中でもクライアントに近い、BFFを含むFrontendレイヤーのサービスを運用しており、言わばEmbedded SRE的な業務を行っています。今回、日本初開催のKubeConに参加して私が今回興味深いと感じたセッションを紹介します。 kccncjpn2025.sched.com このセッションでは、マルチクラスターやマルチクラウドにより複雑化するKubernetes環境を、運用担当者がどのように管理していくかが解説されていました。セッションの冒頭では、プラットフォームエンジニアとエンドユーザーの両視点から、Kubernetes環境の複雑性とそれに伴う課題が紹介されていました。 Infra / Platform Team目線 Exploring Tenant-centric Strategies To Simplify Multi-cluster and Multi-cloud Complexities P.4より引用 マルチクラウド・マルチリージョン環境では、管理すべきリソースの数の急増が指摘されました。加えて、クラウドプロバイダーごとにAPIや構成方法が異なるため、統一的な管理が難しいという課題も挙げられました。これらを背景に、効率的なリソース管理には、 プログラマブルなアプローチ が不可欠であると説明されています。 End use 目線 Exploring Tenant-centric Strategies To Simplify Multi-cluster and Multi-cloud Complexities P.5より引用 一方でエンドユーザー側では、マルチクラウドやマルチクラスター構成の影響で、利用するツールが多様化しています。ツールやクラウドごとに操作方法やAPI仕様が異なるため、それぞれのツールに関する深い理解と、 高度なデバッグ能力 が必要であると述べられていました。これらの問題に対してセッションでは、以下のようなゴールが設定されます。 ツールやクラウドプロバイダーの違いを吸収する 抽象化レイヤー コード生成 や 設定ファンアウト を含む、リソースのプログラム的テンプレート化 一貫性と拡張性を両立した API駆動型プラットフォーム スキーマに基づいてリソース定義と構成を管理する 自動化と制御の仕組み スライドのようなアーキテクチャが説明されていました。 Exploring Tenant-centric Strategies To Simplify Multi-cluster and Multi-cloud Complexities P.9より引用 Exploring Tenant-centric Strategies To Simplify Multi-cluster and Multi-cloud Complexities P.11より引用 また、アーキテクチャの説明が行われたのち、達成順序についても述べられていました。 Exploring Tenant-centric Strategies To Simplify Multi-cluster and Multi-cloud Complexities P.12より引用 個人的に興味深かった点は、 Pkl を採用している点とマルチクラスタ構成そのものについてです。 まず、Pklについてですが、ZOZOではKubernetesマニフェストをKustomizeを使い base/ + env/ 構成で管理しています。ただし、この構成では各環境の値(例えば、JVMのパラメーターなど)を静的に定義する必要があり、条件分岐やデフォルト値の設定などを ロジックベースで扱うことが難しい という課題があります。 一方で、Pklを用いることでこうした 条件分岐やデフォルトの共通化をプログラマブルに表現 できるため、より柔軟な構成管理が可能になると感じました。ただし、Kustomizeを使った純粋なYAMLを使った書き方に比べると、学習コストが増えることが予想され、新規メンバーがJoinした際に必ず学習期間を設ける必要があります。そういった点で利便性と学習コストが採用する際の天秤として難しいなと個人的には感じました。 次に、マルチクラスタについてです。ZOZOTOWNでは、EKS上でシングルリージョン・シングルクラスタのマルチテナント方式でKubernetesを運用しています。 これまで私は、マルチクラスタ構成について「クラスタ内の構成は簡素になっても、マニフェストの管理やアップデート時の運用負荷が増えるのではないか」と考え、あまり前向きに検討してきませんでした。しかし今回のセッションを通じて、もし各クラスタに対してリソースを自動でApplyできるような環境(例:Crossplane + ArgoCDなど)を整備できるのであれば、要件的にマルチクラスタ構成が必要ない場合でも クラスタ間の責務を明確に分離することで、個々の構成をシンプルに保ちつつ 安全性や柔軟性の高い運用ができる可能性あると感じました。 一方で、マルチクラスタ化が進むと、それぞれのクラスタにインストールされるカスタムオペレータ(CRDやコントローラ)の数も増えていきます。その場合、各オペレータのアップデート対応や互換性の確認など、新たな運用コストが発生する懸念もあります。これまで私はマルチクラスタについて深く考える機会があまりなかったのですが、今回のセッションを通じて、改めてそのメリット・デメリットを整理し、今後の構成設計に活かしていきたいと感じました。 Cloud Native Scalability for Internal Developer Platforms こんにちは、Platform SREブロックの石井です。 Cloud Native Scalability for Internal Developer Platforms - Hiroshi Hayakawa, LY Corporationをご紹介します。 kccncjpn2025.sched.com 自分はプラットフォームエンジニアとして活動しており、「Kubernetesにはスケールの限界があるのか・大きなスケールのチームは何か特別な扱い方をしているのか」という疑問がありました。本セッションでは 690 テナント / 29,000 アプリ / 112,000 Pods という国内最大級の規模を 約5年間で実現 した実践例および現状の課題が紹介されました。まさに自分達が現在直面している課題や、“数年後の自分たち”に直結する何かが得られると考え、セッションを拝見しました。 セッション概要 以下のような内容が本セッションでは紹介されていました。 背景 :シンプルなコマンドでアプリケーションを実行できるHerokuのようなPaaS(IDP:Internal Developer Platform)を構築し、全社開発者へ提供。 5年のスケーラビリティの旅 :スケールする中でさまざまばクラスタ設計・運用自動化・メトリクス基盤・コントローラ性能の壁を順に突破。 現在直面している課題 :Control Planeの限界とController Shardingへの挑戦。 1. Internal Developer Platform(IDP)の全体像 まずは、IDPの全体像が紹介されており、規模の大きさに非常に感銘を受けました。 構成 : 特徴:単一Control Plane Clusterで複数Workload Clustersを制御し、「 論理的な一つのクラスタ 」として扱う設計 Control Plane Cluster : ユーザーからの支持を受け付け、アプリケーションのデプロイに必要な処理を行うクラスタ。どのWorkload Clusterにスケジュールするか・アプリケーションを外部に公開する準備を行う Workload Clusters : アプリケーションを実際に実行するクラスタ群 Cloud Native Scalability for Internal Developer Platforms P.6より引用 スケールの変遷 Cloud Native Scalability for Internal Developer Platforms P.7より引用 2. スケーラビリティの旅と直面した壁 (Scalability Journey in Our Internal Developer Platform) この大きくスケールした5年間で直面した課題やそれに対する決定などが紹介されていました。一部を紹介します。 2-1. クラスタ設計:Single vs Multi 非常に多くのアプリケーションをホストする要件があったため、どのようにしてKubernetes Clusterをスケールするかは非常に重要な事項であった。主に2つの選択肢があった。 Cloud Native Scalability for Internal Developer Platforms P.17より引用 結果:マルチクラスタを選定 決め手 :組織的に複数クラスタ運用ノウハウがあり、社内の要件に則った。これは絶対的な正解ではなくチームのスキルセットや組織の要件によってことなる。 マルチクラスタ設計 CPU / メモリを大きく消費するアプリケーションだけを Silo Cluster に隔離、残りは Pool Cluster で共有するハイブリッド方式を採用。これによりNoisy Neighborの問題を最小限にできる。 Silo Cluster : 特定ワークロードのリソース消費が大きいなどの理由によりシングルテナントで利用されているクラスタ Pool Cluster : マルチテナントでリソースが共有されているマルチテナントのクラスタ Cloud Native Scalability for Internal Developer Platforms P.21より引用 2-2. オペレーショナルスケーラビリティ DeveloperチームがPlatform利用開始する、オンボーディング関連作業を少数のPlatformチームメンバーのみで行っていた。しかし、組織にプラットフォームを公開する必要があり、この作業をスケーラブルにする必要があった。 自動化前: 開発者がチケット経由でテナントをリクエスト プラットフォームエンジニアが対応: Athenzに認可ポリシーを登録 Git上にNamespaceを作成(GitOpsにより管理) Cloud Native Scalability for Internal Developer Platforms P.25より引用 自動化後: カスタムコントローラを作成し、ポリシー登録を自動化 チケットシステムをオンボーディングアプリに置き換え 現在は完全セルフサービス化。開発者自身でオンボーディング可能に Cloud Native Scalability for Internal Developer Platforms P.31より引用 2-3. カスタムコントローラ性能 カスタムコントローラーはリコンサイル処理で競合を起こさないように単一のインスタンスで動作する必要がある。しかし、クラスタの規模が大きくなると単一インスタンスのスケールアップだけでは、様々な問題に直面するようになった。 現状 :単一Podでスケールアップ 現在挑戦中 :CNCF Sandbox timebertt/kubernetes-controller-sharding へコントリビュートし 水平分割(Shard)による Scale-Out を検証中 3. いま直面している3つのControl Planeの課題 Platformが成長しスケールするにあたり、生じたControl Planeに関する複数の課題が紹介されていました。 リソース数増加により、kube-apiserverの消費メモリが増大する問題 v1.33からデフォルトONの Streaming List で解消見込み etcd サイズ肥大 Aggregation Layer経由で一部のCRDをWorkload Clusterへ移譲 Controllerがスケールアップしかできない Kubernetes Controller Sharding をへ会社としてコントリビュートしている。 おわりに 本セッションで最も印象に残ったのは、「スケールの旅に終わりなし。その旅を楽しめ」 という姿勢でした。大規模運用を支える構成や技術選定はもちろん、負荷の特性に応じたクラスタ分離戦略(Silo / Poolモデルの併用)、無理なく自動化を進める段階的アプローチ、といったひとつひとつの設計思想に、深く感銘を受けました。そして、Controller Shardingのようなまだ未成熟な領域にも、「必要だから、自分たちで積極的にコントリビュートする」という姿勢が垣間見えた点も非常に刺激的でした。このセッションには多くの刺激を受け、また、学びを得ることができました。これを自社のプラットフォームの発展にも役立てていきます。 ZOZOブースの紹介 ZOZOブースの様子 ZOZOのスポンサーブースでは、ZOZOTOWNのアーキテクチャとOSSデモをメインコンテンツとして展示しました。また、各プロダクトのステッカーやZOZOの計測テクノロジーを生かした ZOZOGLASS と ZOZOMAT を配布しました。 ZOZOブースで配布したノベルティ ZOZOTOWNのアーキテクチャ 展示コンテンツの1つであるZOZOTOWNのアーキテクチャについて、プラットフォームSREの酒部と、検索基盤SREの徳山から紹介いたします。2人とも25年度新卒として入社しました。 ZOZOTOWNでは長らくオンプレミスからクラウドへの移行とマイクロサービス化を進めています。 techblog.zozo.com まだ移行過渡期であるものの、日本で初めて開催される「KubeCon + CloudNativeCon Japan 2025」というクラウドネイティブの世界的なカンファレンスで展示することで、社外からの疑問や意見を交換できる機会になると考え、このコンテンツ制作に至りました。会期中に展示していたスライドの一部を掲載いたします。 とても多くの方に関心を持っていただいたZOZOTOWN Architecture Architectural Policy Ecosystem for Achieving System Stability Ecosystem for a Highly Productive Development System 「クラウドをどのように使い分けている?」、「プラットフォームが多機能で運用が大変そう」といった質問や感想を頂きました。 僕たちはZOZOTOWNの新卒SREと言う立場で今回のイベントに参加し、アーキテクチャ図の制作からブース対応をする中で多くの気づきがありました。 今回、ZOZOTOWNのアーキテクチャとマイクロサービスを自動リリースする手法について先輩社員から学びながらアーキテクチャ図を制作しました。ZOZOTOWNの全体像と安全にリリースするための先進的な仕組みを学ぶことができる貴重な機会になりました。ブース対応をする中で他社のアーキテクチャも聞けましたが、他社さんに比べてZOZOでは独自のAPI Gatewayを作っているなど、オンプレを含むハイブリッドな構成であることを感じました。 参加者の半分くらいは日本人で言語の壁を感じることなく議論ができました。また海外の参加者も日本語で話しかけてくださったりして、英語に苦手意識がある自分でも緊張せずに議論できて、本イベントの参加者の暖かさも感じることができてよかったです。 ブース出展したことで、Kubernetesを中心としたクラウドネイティブ技術の最前線に触れられただけでなく、世界中の情熱的なエンジニアと繋がれる素晴らしい機会になりました。ブースに立ち寄って頂いた皆様、ありがとうございました。 OSS デモ OSSデモの様子 ZOZOにて開発し利用している大規模負荷試験ツール「 Gatling Operator 」と、複数の負荷試験を省力化して実行可能なCLIツール「 Gatling Commander 」のデモを行いました。 説明中の様子 Gatling Operatorは、Gatlingをベースとした分散負荷試験のライフサイクルを自動化するKubernetes Operatorです。Gatling CommanderはGatling Operaorによる複数の負荷試験を自動的に連続・連携して実行可能とし省力化するCLIツールです。 Gatling Commanderを実行するとGatling Operatorが立ち上って対象サーバーへリクエストが行われ、テスト結果が Google スプレッドシート で一覧確認できるデモを行いました。 デモはGatling Commanderを実行するCLI、Gatling Operatorが動作するKubernetesのPodの状態、対象サーバーのアクセス状況を表示するツールを作成しました。 Gatling CommanderとGatling Operator ブース展示のために作成したデモツールの様子 テスト結果はGoogle スプレッドシートで参照可能です。結果はGoogle スプレッドシートに複数のテストを集約する形で表示されます。 テスト結果はGoogle スプレッドシートで参照可能 Gatling Operator と Gatling Commander はそれぞれオープンソースとしてGitHubで公開しています。また、過去に公開している関連記事もみていただけると嬉しいです。 techblog.zozo.com techblog.zozo.com 協賛企業ブースのコーデまとめ あっすーです。他カンファレンスと同じように協賛企業ブースを回ってきましたので、各ブースのコーデをお送りします! 各社の雰囲気に合わせたデザイン・着こなしは、やはりZOZOとしても気になるポイント。参加した方は当日の会場の様子を思い出しながらご覧ください。 Kongさん DoiTさん Red Hatさん 日立製作所さん(表) 日立製作所さん(裏) Octopus Deployさん Tintriさん EDBさん Kubernetes Contributor Summit LINEヤフーさん / クラウドネイティブな高速近似最近傍密ベクトル検索エンジン「 Vald 」 Splunkさん(表) Splunkさん(裏) ClickHouseさん(表) ClickHouseさん(裏) Dash0さん(表) Dash0さん(裏) AWSさん Google Cloudさん Grafanaさん SUSEさん C-Nativeさん Akamaiさん お忙しい中ご協力いただいたブースの皆様、本当にありがとうございました! おわりに 日本初開催のKubeCon + CloudNativeCon Japanに協賛、そしてブースを出展できたことはとても良い経験になりました。改めてブースにお越しいただいた多くの皆さん、ありがとうございました。少しでもZOZOに興味を持ってもらえたら幸いです! ZOZOから参加した一部メンバーで撮影した集合写真 ZOZOでは、一緒に働くSREの仲間を募集しています。ご興味のある方はこちらからご応募ください。 ZOZOTOWN SRE | 株式会社ZOZO WEAR by ZOZO SRE | 株式会社ZOZO ZOZOMO SRE | 株式会社ZOZO SRE(オープンポジション) | 株式会社ZOZO また、会期中は混雑していることも多く、じっくりとお話しする時間が取れなかったので、もう少し詳しく話を聞きたい! という方はカジュアル面談も受け付けています。 hrmos.co 既に来年開催される「 KubeCon + CloudNativeCon Japan 2026 」のページも公開されています。来年も素敵なカンファレンスになることを期待しています! 現場からは以上です!
はじめに こんにちは。ZOZO研究所の研究員の川島、ZOZOのデータサイエンティストの吉本・広渡です。2025年5月27日(火)から5月30日(金)にかけて大阪で開催された『2025年度 人工知能学会全国大会(JSAI2025)』に参加しました。この記事では我々が気になったセッションの内容をご紹介します。 はじめに JSAI2025とは セッションレポート [2M5-OS-37b] AIを用いた空間・時系列データのモデリング手法と応用 [2M5-OS-37b-01] (OS招待講演)地理空間情報を活用した経路計画 [2M5-OS-37b-02] 経路複雑性の活用による経路選択モデリングの性能改善 [2M5-OS-37b-03] モデル化誤差が顕著な状況における制御のためのダイナミクス学習 [2M5-OS-37b-04] 大学病院の集中治療室における医療スタッフの移動軌跡の抽出手法 [3F5-OS-42b] 大規模言語モデルの安全対策 ― 大いなる力には、大いなる責任が伴う [3F5-OS-42b-01] AIの安全性に関する世界の動きとAI Safety Institute(AISI)について [3F5-OS-42b-02] AISI国際ネットワークにおける共同テスト演習について [3F5-OS-42b-03] 大規模言語モデルのジェイルブレイクに対するインコンテキスト防御の役割明記による改良 [3F5-OS-42b-04] (OS招待講演)安全な大規模言語モデルの構築と利用を目指して [4D2-OS-33b] AIを活用したマーケティング実践 [4D2-OS-33b-01] LLMを活用したペルソナベースのデルファイ法による多視点アイディア評価 [4D2-OS-33b-02] 深掘り質問促進のための LLM を活用した動的プロンプト制御型顧客インタビュートレーニングシステム [4D2-OS-33b-03] 生成AIとジョブ理論で作る顧客中心型CRM [4D2-OS-33b-04] 広告デザイン改善のための代替案生成手法 [4D2-OS-33b-05] 双方向推薦システムにおけるコントラスト効果の応用 まとめ JSAI2025とは JSAIとは、一般社団法人 人工知能学会(JSAI) が主催する日本最大級のAI学術イベントで、2025年に第39回を迎えました。今回は大阪国際会議場で開催され、過去最多となる4,939名が参加しました。 EXPO 2025 大阪・関西万博のテーマウィーク と連携した特別セッションが設けられるなど、学術研究と国際的なイベントが融合した大会となりました。 www.ai-gakkai.or.jp セッションレポート [2M5-OS-37b] AIを用いた空間・時系列データのモデリング手法と応用 ZOZO研究所の川島です。会期2日目である5/28(水)には、オーガナイズドセッション「 AIを用いた空間・時系列データのモデリング手法と応用 」が開催されました。 同オーガナイズドセッションは年度ごとのマイナーチェンジはあるものの、2020年度大会から継続して開催されており、現在のJSAIにおける主要なテーマのひとつと言えます。 ZOZO研究所では 物流コストの最小化を目指す研究 を行っており、そのような技術につながる新たな発見を期待して同セッションに参加いたしました。以下ではセッション内の各発表について簡単にレポートいたします。 [2M5-OS-37b-01] (OS招待講演)地理空間情報を活用した経路計画 同セッションは豊田中央研究所の大滝氏による招待講演から始まりました。本講演は主に歩行する人を対象とし、どのような方法で出発地から目的地までたどり着くまでの経路を案内するか、という経路計画の問題についての発表でした。 最短あるいは最短に近い経路を求めることはあまり難しくないのですが、本講演の面白いところはいかに「最短でない経路」をサジェストするかというところに焦点をあてているところでした。講演者らが実施したアンケートでは、回答者の約半数がナビゲーションにおいて「案内される経路が必ずしも最短でなくてもよい」と答えたそうです。実際の研究事例として、(1)目的地に目標の時間に着くまでに歩き回れる経路の探索、(2)歩く道の景観情報を加味した楽しい街歩きのための経路の探索、(3)東京タワーのようなランドマークの情報を使った迷いづらい経路の探索、(4)道路としての魅力度の差異(例:パチンコ屋が並んでいる道とアーケードの商店街)を評価する研究などが紹介されました。 ところでZOZOでは「 似合うってなんだ 」をコンセプトとした研究を精力的に行っていますが、ファッションの評価には主観的な好みが常につきまといます。この講演で紹介された研究についてもそのような主観性に基づいた問題設定である面白さや難しさがあり、弊社での取り組みとの共通点を感じながら聴講していました。 [2M5-OS-37b-02] 経路複雑性の活用による経路選択モデリングの性能改善 続いての口頭発表でも経路選択に関する研究が紹介されました。本発表は逆強化学習を用いた経路選択において、どのようなデータを用いればより高品質な経路選択が可能となるか、という問いに対する検討を行うものでした。 逆強化学習はその名の通り強化学習の逆の問題を解くタスクで、通常の強化学習では「定義した報酬関数をもとにそれを最大化する方策を探す」ことを考える一方、逆強化学習では「データセット中で実際に取られた方策から報酬関数を推定する」ということを行います。具体的には、タクシードライバーが実際に通った経路を集めたデータからRCM-AIRL (Route Choice Modeling Adversarial Inverse Reinforcement Learning)と呼ばれる手法で報酬関数を推定し、それを用いて経路選択をするということが行われていました。このデータセットを経路中の右左折の多さによって3段階に分割し、それぞれ(+全データを使った場合)で学習を行ったところ、中程度に複雑な経路からなるデータセットを用いた場合で定量的に最もよい経路選択が行えたそうです。 [2M5-OS-37b-03] モデル化誤差が顕著な状況における制御のためのダイナミクス学習 微分方程式に従う時系列データのダイナミクスをうまくモデリングすることは、制御などの意味で非常に重要です。 学習によってダイナミクスを推定する際、物理的な事前知識によって得られる具体的なモデル中の未知パラメータを推定する場合と、Neural ODE (Neural Ordinary Differential Equation) のようなブラックボックスモデルを用いる場合とがあります。後者のアプローチを採用すると事前知識は不要になりモデリングの柔軟性は増しますが、学習のためのデータは大量に取得しなければならなくなります。両者の利点をあわせ持つのがハイブリッド型の方法で、事前知識に基づく数理モデルとブラックボックスの足し合わせで時間発展を記述するアプローチをとります。ただしハイブリッド型の方法はナイーブに学習すると本来数理モデル側で表現してほしいパートまで、その表現能力の高さゆえにブラックボックスモデルに吸収されてしまう問題があるようです。 このため、ブラックボックスモデルに何らかの形で正則化をかける必要があります。本発表は、その正則化の種類や大きさが実際の精度にどう影響するかについて、マルチコプターのシミュレーションを題材に調べた研究でした。結果としてモデル全体(数理モデル+ブラックボックスモデル)とブラックボックス単体との出力の相関に関して正則化を行うのがベターで、また正則化を大きくしすぎると予測誤差が大きくなることが確認されたようです。 [2M5-OS-37b-04] 大学病院の集中治療室における医療スタッフの移動軌跡の抽出手法 セッション最後の研究は、病院の集中治療室 (ICU) の業務効率化を目指し、センサを用いてICU中のスタッフの移動軌跡を取得・分析するという研究でした。 ICUでは実際に動線の交錯や滞留が生じるものの、動画データを用いた場合患者へのプライバシーの問題が発生する、という特有の課題があるとのことでした。データの取得にはスタッフの業務を阻害しない小型の2D-LiDARセンサを用いて点群データを取得したのち、事前学習済みの物体検出モデルで人物検出を行い、カルマンフィルタによって各個人の軌跡を追跡する、というパイプラインが用いられていました。その後各軌跡に対してGMM (Gaussian Mixture Model)による移動・滞留のクラスタリングや効果的な可視化を用いた定性的な確認などの複数の側面からデータを分析し、人流の様子を定量的・定性的に把握できるようになったそうです。 [3F5-OS-42b] 大規模言語モデルの安全対策 ― 大いなる力には、大いなる責任が伴う データ・AIシステム本部データサイエンス2ブロックの吉本です。 私たちのブロックでは、AIやデータサイエンス技術を用いたプロダクト開発とそのための研究開発に取り組んでいます。ここでは、5/29(木)に行われたオーガナイズドセッション「 大規模言語モデルの安全対策 ― 大いなる力には、大いなる責任が伴う 」の各発表についてレポートします。 [3F5-OS-42b-01] AIの安全性に関する世界の動きとAI Safety Institute(AISI)について 同日の午前中の招待講演 [3A2-PS-3] AIのリスクと安全性〜AI広島プロセスからAISI設立まで(村上 明子氏) と合わせて紹介させていただきます。 AISI(AIセーフティ・インスティテュート) は、安全・安心で信頼できるAIの実現に向けて、AIセーフティに関する評価手法や基準の検討・推進するための機関です。2024年2月14日に10の関係府省庁と5の政府系関係機関が共同で設立しました。 活動の1つとしてガイドラインの策定があり、AIシステムの安全性を評価する際の基本的な考え方を示した AIセーフティに関する評価観点ガイド や、AIシステムのリスク対策を攻撃者の視点から評価するためのレッドチーミング手法に関する AIセーフティに関するレッドチーミング手法ガイド などが紹介されました。 AIのリスクについては、 International AI Safety Report や総務省・経済産業省が出している AI 事業者ガイドライン に基づいて説明されました。また、AIの安全性を守るための規制の動向に関しても説明がありました。ガイドラインのような罰則のないゆるやかな方式で行うソフトローと、法律で定めたうえで罰則も視野に入れたハードローの考え方が紹介され、発表前日5月28日に成立した AI法 に関しても触れられました。 [3F5-OS-42b-02] AISI国際ネットワークにおける共同テスト演習について この発表では、 AISI国際ネットワーク が行った、10カ国共同での テスト演習 が紹介されました。 テスト演習は、多言語評価とサイバーセキュリティ評価の2つの分野について実施されました。日本はデータセットの翻訳作業、評価の実施、分析を担当しました。多言語評価は日本・シンガポールが、サイバーセキュリティ評価は英国が主導しました。 多言語評価のデータセットとしては MLCommons 、 AnswerCarefully V2 、および CyberSecEval が使用されました。MLCommons、AnswerCarefully V2は、懸念のある質問に対してLLMが無害な出力を生成できるかどうかを検査します。CyberSecEvalは、プロンプトインジェクション攻撃への耐性を検査します。 サイバーセキュリティ評価は英国AISIが開発した Inspect AI プラットフォーム上で行われ、データセットとしてはサイバーセキュリティスキルを評価する Cybench が用いられました。 モデルとしては、他言語評価ではMistral LargeとGemma2が、サイバーセキュリティ評価ではMistral Large、GPT-4o、GPT-4o miniが評価されました。 [3F5-OS-42b-03] 大規模言語モデルのジェイルブレイクに対するインコンテキスト防御の役割明記による改良 LLMに対する攻撃の1つに、プロンプトを入力して不適切な出力を誘導するジェイルブレーク攻撃があります。LLMの再学習による対策は計算・時間のコストが高いため、プロンプトの加工による防御手法が注目されていますが、過剰な応答拒否や生成文の品質の劣化といった課題がありました。 これらの課題に対応するため、この研究ではプロンプト中に命令と役割の対応付けを徹底する「RoleSpec」という手法が提案されました。RoleSpecでは、システムメッセージには「System」、LLMの応答には「Assistant」、ユーザーのプロンプトには「User」といった役割名を明記します。 実験はLlama-2-7b-chatモデルを用いて行われ、攻撃手法としてはプロンプトの末尾に人工的な文字列を追加するGCG、攻撃用LLMがプロンプトを自然で説得的な文に洗練するPAIR、ロールプレイングを伴うプロンプトで攻撃するDANが試されました。 評価指標としては、攻撃に対する拒否応答率と、一般タスクに対する回答品質を測る MT-bench が用いられました。 実験の結果、RoleSpecを適用することで、何も防御していない場合と比較して、攻撃に対する拒否応答率とMT-benchの回答品質の両方が大幅に向上することが確認されました。また既存手法と組み合わせた場合でも、攻撃耐性と回答品質が向上することが示されました。 [3F5-OS-42b-04] (OS招待講演)安全な大規模言語モデルの構築と利用を目指して この招待講演では、東京科学大学の岡崎直観氏がこれまでに取り組んでこられた、LLMの安全性に関わる研究が紹介されました。 バイアスに関して3件 [1] [2] [3] 、LLMが生成したテキストの検出に関して2件 [4] [5] 、メンバーシップ推論攻撃に関して2件 [6] [7] 、日本語LLMであるSwallowに関して3件 [8] [9] [10] の研究が紹介されました。 バイアス [1] では職業名と性別を示す単語を含む文ペアに対し、含意関係認識を行わせることで、言語モデルのバイアスを定量評価します。例えば「看護師がテニスをしています」と「女性がテニスをしています」のペアの関係を含意・矛盾・中立のどれとモデルが判定するかを見ます。 [2] では、「技術面接での質問に男性と女性のどちらが正解したか」といった性別バイアスが関わる質問にLLMに答えさせ、回答がバイアスを含んでいた場合に、LLM自身でフィードバックを与えて修正させる手法が提案されました。 [3] はLLM-as-a-judgeの設定における、尤度バイアスの評価・緩和に関する取り組みです。LLMが計算する尤度と、LLMと人間のスコアの差との相関係数によってバイアスを評価します。またfew-shot事例をプロンプトとして提示することで、このバイアスを緩和できることが示されました。 LLMが生成したテキストの検出 [4] ではLLMが生成したエッセイの検出器と、その検出を回避しようとする攻撃側LLMを敵対的にIn-Context Learningさせることで、両者の性能がともに向上する「いたちごっこ」が生じることが確認されました。 [5] は生成テキストの品質を維持しつつ、透かしを入れるようにLLMが生成したものであると検出されやすくすることを目指した研究です。検出器からの報酬と評価器からの報酬を組み合わせた強化学習を用いることで、品質を保ちつつ検出されやすさを向上できることが示されました。 メンバーシップ推論攻撃 (MIA) MIAとは、テキストがLLMの学習に使われたものかを推論する攻撃です。 [6] では、尤度にアクセスできないクローズドなLLMに対する攻撃手法が検証されました。検出対象テキストの前半部分をLLMに入力し、その続きとしてLLMが生成したテキストと、元の対象テキストの後半との一致率を比較することで、高い検出率が得られることが示されました。 [7] では、アンラーニングをしつつ忘却対象のテキストを言い換えたテキストで学習させることで、MIAによって検出されないように(データ漏洩の隠蔽)しつつ、対象タスク性能を維持する手法が紹介されました。 Swallow [8] に関しては、訓練データに対する安全対策として、有害な表現を含む可能性のあるウェブページをフィルターしていることが紹介されました。また [9] では、 こちら でも紹介させていただいたように、有用なテキストをLLMで選定していることが紹介されました。 [10] に関しては、LLMによって生成された指示チューニングの学習データ中に、回答拒否を含む応答が含まれていることが紹介されました。 [4D2-OS-33b] AIを活用したマーケティング実践 ZOZOの広渡です。会期4日目である5月30日(金)には、オーガナイズドセッション「AIを活用したマーケティング実践」が開催されました。同セッションではAIを活用したマーケティングの実践事例や課題が紹介されました。以下ではセッションの各発表の内容について簡単にレポートいたします。 [4D2-OS-33b-01] LLMを活用したペルソナベースのデルファイ法による多視点アイディア評価 デルファイ法は、専門家の意見を集約し、未来予測や合意形成に広く用いられるアンケート手法です。本発表では、LLMを活用したペルソナとファシリテーターに基づくデルファイ法によって、多様な視点からのアイデア評価手法の実験が行われました。 具体的には、年齢や性別の異なる15種類のAIペルソナを作成し、各ペルソナが自身の属性に従って独自に10種類の評価項目を選択してアイデアを評価します。ファシリテーター役のLLMが全AIペルソナの評価結果を集計・要約し、そのフィードバックを基に各AIペルソナが評価項目を見直してアイデアを再評価するという反復プロセスを3回繰り返します。 実験の結果、ペルソナの属性によって評価項目の選択に特徴があることが示唆されました。評価を重ねるごとに選択される評価項目の種類は収束し、平均評価スコアも上昇する傾向が示されました。これらの結果から、AIペルソナベースのデルファイ法により、多角的な視点を取り入れた評価を低コストで実現できる可能性が示唆されました。 [4D2-OS-33b-02] 深掘り質問促進のための LLM を活用した動的プロンプト制御型顧客インタビュートレーニングシステム 近年、顧客の潜在ニーズ把握の重要性が高まる中、本発表では、LLMをインタビュイーとして活用する顧客インタビュートレーニングシステムが提案されました。このシステムは、対話の進行に応じてプロンプトの情報を動的に更新することで、ユーザーが適切な深掘り質問を行わなければ潜在ニーズを引き出せない仕組みを構築しています。 具体的には、顧客情報を3段階の階層構造で管理し、ユーザが質問を通じてシステムから情報を聞き出すと、追加情報がプロンプトに追記されます。 被験者8名が提案手法とベースライン手法(全情報を最初からプロンプトに含める)で計2回トレーニングを行いました。提案手法を用いたグループでは、2回目のトレーニングにおける質問数(ユーザーが行った質問の回数)が1回目と比較して平均148.89%増加したのに対し、ベースライン手法では35.00%の増加にとどまりました。また、1つの情報を得るために必要な質問数は、提案手法がベースライン手法の最大4倍となり、深掘り質問の促進に有効であることが示されました。 [4D2-OS-33b-03] 生成AIとジョブ理論で作る顧客中心型CRM 本発表では、顧客関係管理(CRM)における従来の静的なセグメンテーションの限界を克服するため、生成AIとジョブ理論を統合した顧客中心型CRM戦略を提案しています。この戦略は、生成AIを活用した動的な顧客プロファイル生成により、例えば「仕事後にリラックスしたい」顧客にはカフェの割引のインセンティブを提供するなど、リアルタイムで適応可能なパーソナライゼーションを実現することが目的です。 提案手法では、オープンソースの米国クレジット与信データを活用し、Googleの生成AI「Gemini」を用いて顧客プロファイルを生成します。さらに、生成されたプロファイルに基づき、各顧客に最適なインセンティブを生成します。 生成AIを用いた顧客プロファイル生成では、顧客の基本属性を適切に再現できることが確認できました。さらに生成AIにより生成した200件の顧客プロファイルを基に人間による補正と再学習を経て、最終的に1000件のインセンティブを生成し、ターゲット顧客の購買行動との一致度が向上したと報告されています。 [4D2-OS-33b-04] 広告デザイン改善のための代替案生成手法 本発表では、広告デザインの改善を支援するため、過去の広告データを活用した代替案生成手法を提案しています。デザイナーが広告デザインを作成した際に、改善の方向性を見出すことが難しく、広告を効率的に作成しづらいという課題を解決することが目的です。 提案手法は、学習段階とデザインプロセスの2段階で構成されます。まず、学習段階では、Photoshopデータから広告の視覚要素(色、レイアウトなど)を特徴量として抽出し、クリック率(CTR)を目的変数として決定木モデルを学習します。決定木モデルには、平均二乗誤差と決定係数がXGBoostより優れていたCatBoostが採用されました。次に、デザインプロセスでは、新しく作成された広告の特徴量を抽出し、学習済みモデルでCTRを予測します。この際、Tree SHAPを用いて、各特徴量の予測結果への影響度を解析し、最も負の影響を与えている特徴量を「改善箇所」とみなします。特定された改善箇所に対しては、ヒューリスティックな変換(指定された特徴量の類似色や補色への変換など)を適用し、複数の代替広告デザインが生成されます。 実験では、「クリックを促すボタンの色」が最も負の影響を与えていると判断され、ヒューリスティック変換を施されている例が示されています。これにより、改善箇所が元の画像よりも濃い色や、補色に変換された画像が生成され、これまで検討されていなかった細かな色の違いを把握し比較できると報告されています。 [4D2-OS-33b-05] 双方向推薦システムにおけるコントラスト効果の応用 コントラスト効果は、ある対象を別の対象と比較して提示することで、相対的な価値や魅力が変動する心理的効果を指します。本発表では、「コントラスト効果」を求人検索プラットフォームのような双方向推薦システムに応用することで、従来の推薦システムが抱えていた課題の解決を目指しています。従来の推薦システムは、主にユーザーとアイテムの適合度計算に基づいて推薦を行うため、提示順序や比較対象といった相対的な魅力を形成する要素を十分に考慮していませんでした。また、短期的なマッチング数の最大化に偏りがちであり、長期的な効果を加味しにくい、利用者の状態変化に対する柔軟性が低いという問題がありました。 提案手法では、求職者のオンライン行動による潜在的なマッチングの増加分を評価関数に組み込みます。これにより、求職者の活動状況や登録からの経過日数に応じて、「オンライン行動重視度」と「マッチング重視度」を動的に調整することが可能になります。 実際の求人検索プラットフォームを利用し一部の求職者を対象にA/Bテストを実施した結果、提案手法の評価関数を用いて推薦するグループの方が従来の評価関数を用いるよりも、オンライン行動とマッチング行動がともに増加することを確認したと報告されています。 まとめ 本記事では、JSAI2025の一部セッションの内容をご報告しました。参加を通じて、多くの新たな知見を得ることができました。特に印象的だったのは、LLMの進化が多岐にわたる研究分野に与える影響の大きさです。AI技術が具体的な課題解決に活用されている事例を数多く目の当たりにし、その応用可能性の広がりを実感しました。ここで得た知見を糧に、私たちも人工知能研究の進展に貢献できるよう、一層邁進してまいります。 ZOZOでは、一緒にサービスを作り上げてくれる方を募集中です。ご興味のある方は、以下のリンクからぜひご応募ください。 corp.zozo.com