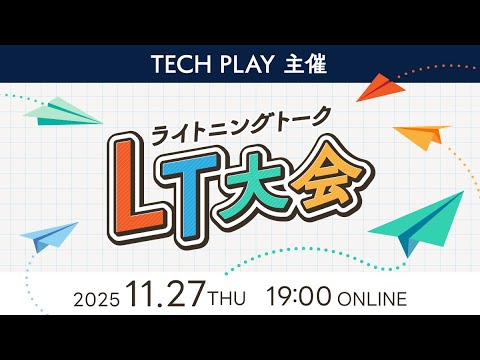
LT(ライトニングトーク)
ライトニングトーク(LT)とは、通常5分から10分程度の短時間でテンポよく行われるプレゼンテーションの一種です。
稲妻のように素早く伝えることを目的としているため、「ライトニング」トークと呼ばれています。
将来は大きなカンファレンスで登壇してみたいとお考えの方も、まずはLT会などに参加して発表の経験を積むことをお勧めします。
イベント


マガジン



技術ブログ
こんにちは!医療プラットフォーム本部 コンシューマーサービス室 第一開発グループの森です。 2026年4月にメドレーへ新卒入社し、 いつもの医療が変わるアプリ「melmo」 を開発しています。 株式会社メドレーは、2026年9月11日(金)〜13日(日)に開催された iOSDC Japan 2026 に、ゴールドスポンサーとして協賛しました。 私はブーススタッフとして3日間参加しました。新卒1年目で参加する、初めての技術カンファレンスです! 本記事では、当日の会場やブースの様子、印象に残ったセッションをレポートします。 メドレーと iOSDC Japan メドレーは複数のモバイルアプリを開発しており、コミュニティとのつながりを通じた開発力・プロダクト価値の向上を目指して、2017年から iOSDC Japan への協賛を続けています。そして iOSDC Japan 2026 で、節目の10回目を迎えました! その一つが、私も開発に携わる melmo です。 インターネットを通じて、自宅や職場からいつもの医師との診察、薬剤師との服薬指導を受けることができるサービスです。オンラインで処方されたお薬はご自宅に直接届けられます。 iOS アプリでは Swift Package Manager によるマルチモジュール構成を採用し、Swift 6 への移行を進めています。iOSDC Japan 2025 では、この取り組みについて弊社の吉田が登壇しました。 止められない医療アプリ、そっと Swift 6 へ 2025年9月21日(日)に開催のiOSDC Japan 2025の登壇資料です。 イベントURL:https://iosdc.jp/2025/ 発表者情報:医療プラットフォーム本部 エンジニア 吉田将吾 speakerdeck.com 2025年の参加レポートもぜひご覧ください! iOSDC Japan 2025 参加レポート - ゴールドスポンサーとして協賛しました! | MEDLEY Developer Portal こんにちは!株式会社メドレーでDevRelを担当している重田です。 株式会社メドレーは、2025年9月19日(金)〜21日(日)に開催された iOSDC Japan 2025に、ゴールドスポンサーとして協賛しました。昨年同様、今年はセッショ... developer.medley.jp 会場の様子 iOSDC Japan 2026 は、有明セントラルタワーホール & カンファレンスでの現地開催に加え、ニコニコ生放送でのオンライン配信も行われるハイブリッド形式で開催されました。 3日間で70本以上のトーク・ライトニングトークが行われました。 オンライン・オフラインあわせて、1,100名を超える参加者が集まったそうです。 朝には、先着でドーナツの配布もありました! ブースに立つ前に、メドレーメンバーもいただきました。運営の皆様、ありがとうございます! セッションの様子 Track A〜D の4トラック並行で、どのセッションを聴講するか迷うほどの充実ぶりでした! エンジニアに聞いた面白かったセッション ブース運営の合間に、さまざまなセッションを聴講しました。 弊社エンジニアが気になった・聴講して面白かったセッションをご紹介します! 通話はつながれば終わりじゃない ― CallKitで通話機能の裏側 by 金 瑠加須さん 通話はつながれば終わりじゃない ― CallKitで通話機能の裏側 私も最初はそう思っていました。しかし実際に開発してみると、CallKitはあくまで”電話らしいUI”を提供してくれるだけで、本当に難しいのはその先でした。 リアルタイム通信サービスとの連携、AVAudioSessionによる音声ルーティング、着信音やBluetooth・スピーカーの切り替え、PushKitによる着信、バックグラウンドでのライフサイクル管理、そしてネットワーク切断やユーザーの途中退出など、実運用では数え切れないほどのエッジケースが待っています。 本セッションでは、Agoraを利用した音声通話機能を題材に、「ユーザーが毎日安心して使える通話機能」を実現するために、どのような設計や実装が必要になるのかを紹介します。 具体的には、以下の内容を扱います。 * CallKitとAgoraを組み合わせた通話アーキテクチャ * AVAudioSessionによる着信音・通話音声・Bluetooth・スピーカーの制御 * 発信・着信・拒否・切断・通信断・途中退出まで考慮した通話ステート設計 * PushKitやバックグラウンド実行を含めたライフサイクル管理 * 実際に遭遇した不具合や設計上の落とし穴、デバッグ方法 CallKitのAPIを紹介するだけではなく、「通話ボタンを押した瞬間から通話が終了するまで」に起こるさまざまな課題をどのように設計し、解決したのかを実例を交えて共有します。 このセッションを通じて、実運用レベルのiOS通話機能を設計・実装するための考え方と実践的な知見を持ち帰っていただければと思います。 fortee.jp 純正の電話アプリと同じように扱える通話を実装するための、細かな工夫が詰まったセッションでした。 通話中にアプリを強制終了されると終了 API を呼べず通話が active なまま残ってしまうなど、正常系だけでなく異常系にどう向き合うかが具体的に語られていたのが印象的でした。 melmo もオンライン診療で通話を扱うアプリなので、業務に直結する話題として聞き入ってしまいました。 「誰ひとり取り残されない」サービスを作る。行政アプリとしてのアクセシビリティとの向き合い方。 by かじたにさん 「誰ひとり取り残されない」サービスを作る。 行政アプリとしてのアクセシビリティとの向き合い方。 GovTech東京では、東京都の行政DXの一環として「東京都公式アプリ」の開発・運営を行っています。現在はアプリの内製化を進めながら、アクセシビリティの向上にも継続的に取り組んでいます。 行政サービスは、子どもから高齢の方、障害のある方まで、幅広い利用者に届く必要があります。だからこそアプリのアクセシビリティの対応は特別な追加機能ではなく、行政サービスに求められる「あたりまえ品質」だと私たちは考えています。 一方で、アクセシビリティの実務経験を持つ開発者は多くありません。私たちも内製開発の体制や運用の仕組みそのものを一から立ち上げる中で、「何から手をつければいいのか」「支援技術が実際どう使われているのか」など手探りからのスタートでした。 本セッションでは、そんな私たちが、iOSアプリのアクセシビリティにどう向き合い、どんな工夫や仕組みで解決してきたのかを、実体験をもとにご紹介します。 GovTech東京には、支援技術を使う当事者の方が在籍しており、直接コミュニケーションを取りながら継続的に改善していける環境があります。こうした環境だからこそ得られた知見を広く共有することも、私たちの大切な役割の一つだと考えています。 このセッションが、アクセシビリティ対応への理解を深め、明日からの実践への一助となれば幸いです。 fortee.jp 社内に知見がない状態から、アクセシビリティ対応を開発プロセスに組み込むまでの手順が整理されたセッションでした。 WCAG(Web Content Accessibility Guidelines)の読み合わせから始めて受け入れ基準に落とし込み、最終的には仕組み化して AI に開発させるところまで到達しているのが印象的でした。 医療サービスを提供する私たちにとっても、誰もが使えるアプリづくりは向き合い続けたいテーマです。 (VoiceOverスクリーンリーダー実演)目が見えなくてもXcodeやApp Store Connectは操作できる? by Yoshiyuki Koyanagi さん (VoiceOverスクリーンリーダー実演)目が見えなくてもXcodeやApp Store Connectは操作できる? 趣味でアプリを開発している@moutendと申します。私は視覚に障害があり目が見えません。しかし、VoiceOverスクリーンリーダー、Appleが提供する画面の読み上げアクセシビリティ機能を活用することで完全に自力でアプリの開発から公開までを行えています。 今回のLTでは私物のMacBookを持ち込み、XcodeやApp Store Connectの操作を実演します。一般的に、アクセシビリティ機能は操作できるかどうかの2択で語られがちです。しかし、実際には、利用者の観点から「素早く快適に操作できる」「時間をかければ操作できる」「操作できないが代替手段がある」「全く操作できない」といった多様な側面があります。 アクセシビリティ機能では先進的な取り組みが目立つAppleですが、実際のところ開発向けツールの操作はどれくらい担保されているのでしょうか。ぜひアクセシビリティ機能が切り開く可能性を覗いてみてください。 fortee.jp VoiceOver を日常的に使われている方による実演のライトニングトークです。 普段お使いの読み上げ速度があまりに速く、それを聞き取って操作されている様子に会場からは驚きの声が上がっていました。 どんな単語が並んでいるかを記憶していて、読み上げの最初の一音で判別しているのだと考えると、人間の能力の底知れなさを感じました。 AI時代におけるiOS設計の守り方と人間の役割 by 遠藤拓弥さん AI時代におけるiOS設計の守り方と人間の役割 コーディングはもうAIのフェーズ」——チームでそう話すようになって、ふと考えました。 じゃあ、僕らiOSエンジニアは何をする人なんだっけ、と。 AIに"書く"を渡してまず気づいたのは、「AIが速く書くほど、設計が速く崩れる」ことでした。でも崩れ方をよく見ると、AIが悪いというより "AIにとって崩しやすい設計" になっていることが多い。そこで僕らが手を入れたのは、AIを監視して矯正することではなく、設計そのものをAIが扱いやすい形に作り替えることでした。機能ごとにモジュール(Package)を切って境界をはっきりさせる、AIが参照すべき場所が一目で分かるようにする——実際、新しく切ったPackageほどAIは優先して参照し、正しい場所に正しいコードを書くようになります。「AIが速く書けて、かつ崩れにくい設計とは何か」を、TVer iOSアプリでの試行錯誤とあわせて紹介します。 そしてもう半分は、"何を人間が決めるか" の話です。AIに"書く"を任せた結果、僕らの手が向かったのは、ずっと後回しにしてきた"質の仕事"(テスト、リファクタ、いらないコードの削除、仕様やルールの整備)と、"リード"でした。ここで言うリードは幅広くて、何を作って何を作らないかの優先順位づけ、やりたいことをissueに分解して設計方針を先に決める、人もAIも同じ前提を読めるようにルールとドキュメントを整える、レビューやチェックを属人化させず"仕組み"に落とす、そして複数のAIエージェントを並行で走らせるための役割分担と段取りを設計する——コードを書く時間が減った分、こうした"前提を作る仕事"に時間が向くようになりました。Howはお任せ、人間は"何を"に集中する。そこに辿り着くまでにやったこと・うまくいったこと・空回りしたことを、正直に話します。 fortee.jp AI が実装を担うようになった今、設計をどう守り、人間は何を決めるべきかを整理したセッションでした。 タスクには並行作業の向き不向きがあるという指摘や、「コードを書く時間が、仕様を書く時間に置き換わった」という話に強く共感しました。 機能仕様のドキュメントをどう管理していくかが今後のキーになりそうだと、エンジニア以外の方との仕様の共有まで含めて考えさせられる内容でした。 ブース出展の様子 60社を超える企業がスポンサーとして協賛し、ブースエリアには34社が出展。連日多くの参加者で賑わっていました。 ここでは、私たちのブースと特に印象に残ったブースをいくつかご紹介します! 弊社ブースの様子 メドレーブースでは、医療や介護のお悩みとメドレーのプロダクトを結びつける「お悩み × プロダクト マッチングゲーム」を実施しました! NFC カードをスマートフォンで読み取ってご参加いただき、正解数に応じてポータブル防災7点セットやポーチなどのノベルティをお渡ししました。 ゲームは、医療や介護にまつわるお悩みが出題され、そのお悩みを解決できるプロダクトを選択肢の中から選んでいただくクイズ形式です。 正解すると、そのプロダクトの紹介が表示されます。ゲームを楽しみながら、メドレーが医療ヘルスケア領域で幅広くプロダクトを展開していることを知っていただけたのではないかと思います。 あわせて、パネルとモニターではメドレーのプロダクトと技術スタックの一覧をご紹介しました。 ブースには、3日間で本当に多くの方にお立ち寄りいただきました! 「ちゃんとサービスの内容が頭に残る」とクイズを褒めてくださる方や、App Store でメドレーのアプリをひとつずつ調べながら真剣に解いてくださる方もいて、嬉しい手応えがありました! 会話の中では「AI でコードは書けるようになったけど、レビューはどうしている?」といった質問をいただくなど、AI を開発にどう活用しているかへの関心の高さを感じました。 また印象的だったのは、 「頭痛ーる」 の認知度の高さです!普段から使ってくださっている方が多く、会話が弾む場面が何度もありました。 ブースにお越しいただいた皆様、ありがとうございました! その他のブースの様子 転職ドラフト 「いま評価される iOS エンジニア」をテーマに、来場者が付箋を貼っていく参加型のブースでした。 これからキャリアを積んでいく身として、どんなスキルや経験が評価されるのか、ヒントをもらえたような気がします。 株式会社エブリー 「iOSアプリ開発、AIにどこまで任せていますか?」というボードが設置されており、参加者の皆さんが AI をどこまで活用しているのかを知ることができる、興味深い展示でした。 ノベルティには、CTO の方がブレンドしたコーヒーをいただきました。「CTO ブレンド」という発想が面白く、飲むのが楽しみです! 懇親会 最終日の夜には懇親会が開催されました。 会場には豪華な料理がずらりと並び、参加者の方々の交流で賑わっていました! 新卒1年目、はじめての技術カンファレンス 冒頭でお伝えした通り、私にとって iOSDC Japan 2026 は、新卒1年目で参加する初めての技術カンファレンスでした。 正直、参加前は「技術の話を振られて、ちゃんと答えられるだろうか」という不安のほうが大きかったです。 実際にブースに立ってみると、その不安はいい意味で裏切られました。 初対面でも、iOS やアプリ開発、AI の活用といった共通の話題があるだけで自然と会話が始まります。 私が新卒目線でサービスや開発の話をすると、皆さんがご自身の経験も交えて話を広げてくださって、とても充実した時間を過ごせました! 入社1年目でこのような機会をいただけたことに感謝しています。 次に参加する機会があれば、より深い技術の話ができるように、そして会社やサービスについての質問にももっと答えられるように、知識と経験を積んでいきたいと思います! おわりに ブースに立ち寄ってくださった皆様、ありがとうございました! 今後もメドレーは技術コミュニティへの貢献、そして弊社をより多くの方々に知っていただくためにイベントへの協賛を継続していきます。 またカンファレンスでお会いしましょう! 過去にスポンサーとして協賛した技術カンファレンスの参加レポート記事はこちら! Product Engineering Conference 2026 参加レポート -ゴールドスポンサーとして協賛しました | MEDLEY Developer Portal Product Engineering Conference 2026 について こんにちは!人材プラットフォームエンジニアの山河です。 弊社メドレーは、先日中野セントラルパークで開催された、Product Engineering Con... developer.medley.jp 関ケ原Ruby会議01 参加レポート - Goldスポンサーとして協賛しました! | MEDLEY Developer Portal こんにちは。医療プラットフォーム本部 歯科診療所事業部 DENTIS開発グループの藤原です。 2026年4月にメドレーに入社、エンジニアとしてクラウド歯科業務支援システム「DENTIS」を開発しています。 メドレーは2026年5月30日に岐... developer.medley.jp TSKaigi 2026 参加レポート - Bronzeスポンサーとして協賛し、弊社の髙橋が登壇しました! | MEDLEY Developer Portal はじめに こんにちは。医療プラットフォーム本部 CLINICS 開発グループの吉岡です。 メドレーは 5 月 22 日・23 日にベルサール羽田空港にて開催された TSKaigi 2026 に Bronzeスポンサーとして協賛しました。 T... developer.medley.jp RubyKaigi 2026 にRubyスポンサーとして協賛しました! | MEDLEY Developer Portal こんにちは!メドレーDevRelの重田(@Shige0096)です。 4/22(水)-24(金) に函館で開催されたRubyKaigi に今年も参加してきたので、その参加レポートをお送りします👟 はじめに 株式会社メドレーはRubyスポン... developer.medley.jp We’re hiring! メドレーでは一緒に働く仲間を大募集しています! カジュアル面談も実施しております。「お話だけでも聞いてみたい!」「ちょっと雑談してみたい!」でも構いませんので、お気軽にお問い合わせください! メドレーで働く|株式会社メドレー メドレーでの働き方や人事制度、求人情報など、採用に関する情報をご紹介します。 www.medley.jp Medley Engineer Entrance Book この度は株式会社メドレーに興味をお寄せいただきありがとうございます。本資料は、メドレーへの転職をご検討いただいている皆様に、当社をより深くご理解いただくために作成いたしました。 medley-inc.notion.site

はじめに こんにちは!サイオステクノロジーのなーがです。前回、 Claude Code のテストゲートが編集ゼロで12分!?Stop hook が「黙って効かなくなる」まで について書きましたが、あれから個人開発の Python プロジェクトでマルチエージェント運用を続けています。委譲そのものは安定してきました。ただ、そのあいだずっと手を出せずにいた問題が残っていました。 レートリミットです。 サブエージェントを何本も並列で走らせていると、当然トークンの消費は速くなります。そして usage limit に当たった瞬間、走っていたサブエージェントは道半ばで殺されます。ここまでは仕方ない。問題はその後で、 制限が明けて作業を再開したとき、「どこまで終わっていたのか」がどこにも残っていない のです。 結果どうなるかというと、さっき 数千トークン使って終わりかけていた調査を、まったく同じ内容で新しいサブエージェントに投げ直すことになります。1 回の中断で同じ作業のトークンを 2 回払う。これが地味に効きます。 レートリミット自体は昔からあるものですし、これに悩まされていたのも今に始まった話ではありません。ずっと手を出せずにいたのは、 中断そのものを検知する手立てが無い と思い込んでいたからです。ターンが API エラーで打ち切られると、hooks から見れば何も起きないまま会話が終わる。記録を残そうにも、記録するきっかけが無い。そう決めつけて、そのままにしていました。 しかし、ハーネスを自作することで解決できるのではないかと思い自作しました。下記はそのサンプルリポジトリになります。 .claude/ 一式と hook のテストに加えて、本物のレート制限を待たずに中断から再開までを再現する examples/simulate-interruption.sh が入っています。 サンプルリポジトリ : Shotaro-Yoshinaga-sti/claude-code-turn-recovery ところが改めて調べてみると、 StopFailure という hook イベントが とっくに追加されていました 。API エラーでターンが終わったときに発火するものです。追加されたのは Claude Code 2.1.78。手元は 2.1.260 だったので、180 バージョン以上も前の話でした。完全に見落としていたわけです。 しかも、これを実際に組み立てるための部品は StopFailure だけではありません。改めて CHANGELOG を追ってみると、必要なものが 知らないあいだにひととおり揃っていました 。 バージョン 追加されたもの このハーネスでの役割 1.0.41 Stop から SubagentStop を分離 サブエージェントの完了だけを単独で捉えられる 2.0.42 SubagentStop に agent_id / agent_transcript_path 完了記録を agent_id で紐付けられる 2.1.47 Stop / SubagentStop に last_assistant_message 完了時の最終報告をトランスクリプトを解析せずに残せる 2.1.77 Agent の resume を廃止し SendMessage({to: agentId}) に一本化 中断したサブエージェントを agent_id で再開できる 2.1.78 StopFailure 中断の瞬間そのものを検知できる 2.1.98 失敗したバックグラウンドサブエージェントが部分的な進捗を親に報告 長い作業をバックグラウンドに置く判断が成り立つ 2.1.199 API エラーで打ち切られたサブエージェントが部分成果を親に報告 中断時に拾えるものが「無」ではなくなった 面白いのは 2.1.77 と 2.1.78 です。 再開の口( SendMessage )と、中断の検知( StopFailure )が隣り合ったバージョンで揃っていました。 片方だけでは足りません。中断を検知できても再開する手段が無ければ記録は活かせませんし、逆に再開できても何を再開すべきか分からなければ意味がない。両方あって初めて成立します。 つまり「hooks では手が出ない」という私の前提のほうが、とっくに古くなっていました。せっかく揃っているので、 中断を記録して次のセッションで再開するハーネスを自作することにしました。 さきほどのサンプルリポジトリが、その成果物です。 ……そして、組み終えてから公式ドキュメントを読み直して、 もっと大きな前提のほうが崩れました 。このハーネス、ほとんど要りませんでした。 順番が前後しますが、先にその話から書きます。実装だけ見たい方は ハーネスの全体像 まで読み飛ばしてください。 参考: Hooks リファレンス(公式ドキュメント) 先に結論: 公式だけでどこまで戻れるのか 私がハーネスを作った動機は「レートリミットで打ち切られたサブエージェントの成果は丸ごと消える」という思い込みでした。 これが間違いでした。 サブエージェント内の API エラー に、実行場所ごとの挙動が明記されています(v2.1.199 以降)。 バックグラウンド : 失敗とマークされ、親が受け取るメッセージには API エラー名と そのサブエージェントの最後の出力 が含まれる。ドキュメントの言葉を借りれば「部分的な作業は失われません」 フォアグラウンド : すでに何かを出力していれば、その部分出力が「遮断されタスクを完了しなかった」という注記付きで返る。v2.1.200 以降、何も出力していない/ツール呼び出ししかしていないサブエージェントだけが Agent terminated early due to an API error で失敗する そして決定的なのがこちらです。 セッション永続性 :サブエージェントトランスクリプトはセッション内で永続化されます。Claude Code を再起動した後、同じセッションを再開することでサブエージェントを再開できます。 再開されたサブエージェントは、すべての前のツール呼び出し、結果、および推論を含む、完全な会話履歴を保持します。サブエージェントは、新規に開始するのではなく、停止した場所から正確に再開します。 つまり、制限が明けたあとにやることはこれだけです。 claude --continue あとは「さっきの調査を続けて」と頼むだけ。Claude は SendMessage で該当のサブエージェントを起こし、そのサブエージェントは止まった場所から再開します。トランスクリプトはメイン会話とは別ファイルに保存されるので、 メイン会話が圧縮されても影響を受けません 。 自作ハーネスと並べるとこうなります。 自作のほうが明確に劣っています。 ハーネスが次のセッションに渡せるのは JSON の記録とノートの要約ですが、公式はサブエージェントのトランスクリプトそのものを復元します。情報量で勝ち目がありません。 しかも時系列がよくない。部分成果を親に返す修正(2.1.199)が公開されたのは 2026 年 7 月 2 日、私が StopFailure hook を書き始めたのは 8 月 26 日でした。 公式が手当てしてから 2 か月近く経ったあとに、同じ問題を自力で解こうとしていた ことになります。CHANGELOG で StopFailure を見つけたところで満足してしまい、サブエージェント側のドキュメントを読み直さなかったのが敗因です。 それでもハーネスに残る用途 では完全に無駄だったかというと、狭いながら残る場面はあります。 同じセッションを再開しない場合 です。 コンテキストが膨らみすぎて、新しいセッションで仕切り直したいとき /clear した後 cleanupPeriodDays (既定 30 日)を過ぎて、トランスクリプトが掃除された後 そもそも「どのセッションだったか」を人間が思い出せないとき このときに手がかりになるのは、ディスクに残る .claude/recovery/ の中断記録と .claude/agent-notes/ のノートだけです。 SessionStart hook は どのセッションで開いても 発火するので、まっさらな新しいセッションにも前回の中断内容を持ち込めます。ノートのほうも、サブエージェントの最後の 1 発言ではなく「途中で確定した所見」が時系列で残るという違いはあります。 とはいえ、 claude --continue で済む場面のほうが圧倒的に多いです。 まずこれを試して、足りないと感じたときだけ hooks を検討する 、という順序が正解でした。 以降は、その「作ってしまったハーネス」の実装記録です。 StopFailure の癖や、hook で状態を持つときに踏んだ落とし穴自体は別のものを作るときにも効くはずなので、そのまま残しておきます。 中断を捕まえられるイベント: StopFailure 見落としていた StopFailure を、もう少し詳しく見ておきます。 公式ドキュメントによると、入力ペイロードは共通フィールドに加えて次の 3 つを持ちます。 フィールド 型 内容 error string ターンを終わらせたエラー種別 error_details string 追加の詳細(optional) last_assistant_message string 会話に表示されたエラー文言(optional) error に入りうる値も列挙されています。 rate_limit / overloaded / authentication_failed / oauth_org_not_allowed / account_on_hold / billing_error / invalid_request / model_not_found / server_error / max_output_tokens / unknown の 11 種類です。 last_assistant_message には注意が要ります。 Stop や SubagentStop では Claude の発言が入るフィールドですが、 StopFailure では "API Error: Rate limit reached" のような API エラー文字列そのもの が入ります。同じ名前でも中身の意味が違うので、共通の処理でまとめて扱うと取り違えます。 そして重要な制約が 2 つあります。 終了コードは無視される 。エラーはもう起きているので、hook が中断をブロックしたり結果を変えたりはできません。 stdout と JSON 出力も無視される 。decision control は使えず、出力はデバッグログにしか出ません。 つまり StopFailure hook にできるのは「 ディスクに書くこと 」だけです。ここが設計の出発点になります。書いたものを読んで人間(と Claude)に見せる役目は、別のイベントに持たせる必要があります。 その相方が SessionStart です。こちらは逆に、 stdout がそのまま Claude のコンテキストに追加される 数少ないイベントのひとつです(他は UserPromptSubmit と UserPromptExpansion )。 stdout is added to Claude’s context as the first input before the initial prompt. 書く側が StopFailure 、読ませる側が SessionStart 。この 2 つをディスク上の JSON で繋ぐ、というのが今回のハーネスの骨格です。 参考: Hooks リファレンス – StopFailure(公式ドキュメント) 自作したハーネスの全体像 不要になってしまいましたが、自作したハーネスの全体像です。関係するファイルはこれだけです。 .claude/ ├── settings.json # hook の登録と env ├── hooks/ │ ├── agent-call-record.sh # PostToolUse(Agent): 起動を .call.json に記録 │ ├── agent-call-complete.sh # SubagentStop: 完了を .done.json に記録 │ ├── pending_agents_shared.py # 「未完了」判定の2パス走査(共有モジュール) │ ├── turn-failure-record.sh # StopFailure: 中断を recovery/ に記録 │ ├── session-start.sh # SessionStart: 再開ブリーフィングを注入 │ └── agent-calls-gc.sh # UserPromptSubmit: 古い状態を掃除 ├── agent-calls/ # <session_id>/<prompt_id>/*.call.json / *.done.json ├── recovery/ # <session_id>.json(提示後は .json.consumed) └── agent-notes/ # サブエージェントが残す途中成果 時系列で並べるとこうなります。 ポイントは、 「未完了だったエージェント」を判定するための材料が既にあった ことです。前回の記事で作ったリレーガードが、Agent 呼び出しの内容を台帳に記録していました。これを流用します。 ハーネスを実装する 1. Agent 呼び出しの台帳を作る(.call.json / .done.json) まず土台になる台帳です。「起動」と「完了」を別々のイベントで記録します。 起動側は PostToolUse (matcher は Agent )です。ここで注意したいのは、 このイベントは完了ではない という点です。サブエージェントは既定でバックグラウンド実行されるため、 PostToolUse は起動が返った時点( tool_response.status == "async_launched" )で発火します。 それでもここで記録する理由は、 PostToolUse が tool_input.prompt と tool_response.agentId の 両方を持つ唯一のイベント だからです。「どの agent_id がどんな依頼で起動されたか」はここでしか確定できません。 # agent-call-record.sh(Python 部分の抜粋) session_id = as_str(data.get("session_id")) prompt_id = as_str(data.get("prompt_id")) subagent_type = as_str(tool_input.get("subagent_type")) prompt = as_str(tool_input.get("prompt")) agent_id = as_str(tool_response.get("agentId") or data.get("agent_id")) state_dir = os.path.join( state_root, safe_name(session_id, "unknown-session"), safe_name(prompt_id, "no-prompt-id"), ) record = { "agent_id": agent_id, "subagent_type": subagent_type, "norm_lines": normalize_lines(prompt)[:MAX_PROMPT_LINES], "time": time.time(), } # → <session_id>/<prompt_id>/<agent_id>.call.json 完了側は SubagentStop です。 agent_id と最終報告テキストを .done.json に書きます。 # agent-call-complete.sh(抜粋) record = { "agent_id": agent_id, "agent_type": agent_type, "output_lines": normalize_lines(output[:MAX_OUTPUT_CHARS])[:MAX_OUTPUT_LINES], "time": time.time(), } # → <session_id>/<prompt_id>/<agent_id>.done.json これで判定式が立ちます。 .call.json はあるが、対応する .done.json が無い = 中断された瞬間に走っていたエージェント この 2 パス走査( .done.json のキーを集める → .call.json の未完了を抽出する)は、後述するとおり StopFailure 側と SessionStart 側の両方が必要とするので、共有モジュール pending_agents_shared.py に切り出しています。 def collect_done_keys(session_dir: str, prompt_dir_names: list[str]) -> set[str]: """パス1: セッション全体の .done.json キーを1つの集合へ集約する。""" done_keys: set[str] = set() for prompt_dir_name in prompt_dir_names: prompt_dir = os.path.join(session_dir, prompt_dir_name) try: names = os.listdir(prompt_dir) except Exception: continue done_keys.update(n[: -len(".done.json")] for n in names if n.endswith(".done.json")) return done_keys 2. StopFailure で中断を記録する 台帳が揃ったので、中断の瞬間に「何が失われたか」をスナップショットします。 { "hooks": { "StopFailure": [ { "hooks": [ { "type": "command", "command": "\"$CLAUDE_PROJECT_DIR/.claude/hooks/turn-failure-record.sh\"", "timeout": 10 } ] } ] } } matcher は あえて付けていません 。 rate_limit に絞りたくなるところですが、 overloaded でも server_error でも「作業が飛ぶ」という事情は同じです。全部記録して、区別は読む側( session-start.sh )に任せます。 記録する中身はこんな形です。 record = { "session_id": session_id, "prompt_id": prompt_id, "error_type": error_type, "error_message": error_message, "time": record_time, "branch": git_output(["branch", "--show-current"]).strip(), "git_status_lines": git_output(["status", "--porcelain"]).splitlines()[:MAX_STATUS_LINES], "pending_agents": pending_agents, # 未完了だったエージェント "pending_total": pending_total, # 上限で切り捨てる前の総数 "finished_agents": finished_agents, # このターンで完了済み(再実行させないため) "payload_keys": payload_keys, # 診断用 "payload_preview": payload_preview, # 診断用 } finished_agents を持っているのがポイントです。再開時に「未完了はこれ」だけを伝えると、 既に終わっているエージェントまで念のため走らせ直す という反応が起きがちです。「これは終わっているので再実行しない」を明示的に渡します。 書き込みは tempfile.mkstemp() + os.replace() の原子的置換です。中断はターンの途中で起きるので、読む側が壊れた JSON を掴まないよう「完全な内容が見えるか、古い内容が見えるか」の二択にしています。 fd, tmp_path = tempfile.mkstemp(dir=state_root, prefix=".tmp-", suffix=".json") with os.fdopen(fd, "w", encoding="utf-8") as f: json.dump(record, f, ensure_ascii=False) os.replace(tmp_path, path) そして全体が try/except で囲まれ、 何が起きても exit 0 です。 StopFailure は終了コードも stdout も無視されるイベントなので、失敗を通知する手段がありません。静かに諦めるしかないので、fail-open に振り切ります。 3. SessionStart で再開ブリーフィングを注入する 書いたものを読ませる側です。 SessionStart hook の stdout はそのままコンテキストに入るので、Markdown で人が読める形に整形して出します。 記録の引き当ては 2 段構えです。 def pick_record(state_root, session_id): """(パス, 記録, 別セッション由来か) を返す。""" cutoff = time.time() - ttl_seconds() # 既定 24 時間 if session_id: exact = os.path.join(state_root, f"{safe_name(session_id, ...)}.json") record = load(exact) if record is not None and float_or_zero(record.get("time")) >= cutoff: return exact, record, False # 一致しなければ TTL 内で最新の記録を「別セッションの記録」として拾う --continue / --resume は同じ session_id でセッションを開き直すので完全一致が直撃します。一方で、制限に当たった後は新しいセッションを立て直す運用も多いため、一致しなければ TTL(既定 24 時間)内の最新記録をフォールバックで拾い、「別セッションの記録です」と断り書きを添えて出します。 出力されるブリーフィングはこんな感じです。 ## 前回ターンの中断記録 (rate_limit) - 中断の原因になったAPIエラーがまだ続いているかどうかは、この記録からは分からない。 ただし「まだ制限中かもしれない」はサブエージェントへの委譲を控える理由にならない。 制限が明けていれば委譲は普通に動くし、明けていなければメインセッションが自分で 実装しても同じように失敗する - 中断: 2026-09-02 20:41 / You've hit your session limit · resets 8:40pm (Asia/Tokyo) - 未完了だったサブエージェント (2件): - investigator [agent_01AbC...] 認証まわりのエラー処理を洗い出す / … - implementer [agent_01XyZ...] サムネイル生成のキャッシュを追加する / … (古い) - このターンで完了済み (1件): reviewer [agent_01Def...] — 再実行しない - 再開の手順 (上から順に試し、成功した時点で次には進まない): 1. `.claude/agent-notes/` に途中成果が残っていないか先に確認する。 残っていれば、次の指示はそこからの差分だけでよい 2. 未完了エージェントに SendMessage(to: "&lt;agent_id>") を送って再開する。 同じ依頼を新規 Agent で作り直さない 3. SendMessage が届かない (エージェントが既に消えている) 場合は、 残りの作業を新しいサブエージェントに委譲する 4. メインセッションが自分で実装するのは最後の手段 - 組み込みの Explore / Plan は再開できない。 再開できる investigator / implementer に置き換えて起動する 工夫している点をいくつか挙げます。 手順を 1〜4 の順序付きで書く。 「再開してください」だけだと、 SendMessage が届かなかった時点で消去法的に「じゃあメインが自分で実装するか」に落ちます。不達時の出口(手順 3)を明記して、委譲ルールの中で完結できるようにしています。 鮮度に注意を添える。 呼び出しから 1 時間( STALE_AGENT_AGE_SEC )を超えたエージェントには (古い) を付けます。数時間後の再開では、もうプロセスが消えている可能性が高いためです。 切り捨てが起きたことを見せる。 記録側は 12 件、表示側は 8 件で切りますが、切る前の総数( pending_total )も記録しておき、 (他 N 件、上限により省略) と出します。上限が黙って情報を落とすのは避けたい。 一度出したら二度出さない。 提示後は os.replace(path, f"{path}.consumed") でリネームします。削除ではなくリネームなのは、後述の GC が同じ基準で拾えるようにするためです。 なお、 error は unknown を正規の値として取りうるので、空文字と同じく「原因不明」に寄せています。ここを素通しにすると、ドキュメント記載の正規値そのものを経路として、日本語のブリーフィングに英語の (unknown) が混ざります。 4. サブエージェント側に途中成果を書かせる hooks だけでは埋まらない穴があります。 未完了のエージェントを再開できても、そのエージェントが何を掴んでいたかは本人しか知らない という点です。親に返るのは最後の 1 発言だけで、その全履歴は同じセッションを再開しないと辿れません。新しいセッションで仕切り直したときに SendMessage が届かなければ、そこで打ち切りです。 そこで、エージェント定義そのものに「途中成果の保全」を書いています( .claude/agents/investigator.md )。 ## 途中成果の保全 調査が数分を超えそうなら、確定した所見をその都度 `.claude/agent-notes/&lt;YYYYMMDD>-investigator-&lt;短いスラッグ>.md` に追記する。 - なぜ: レート制限などのAPIエラーで打ち切られると、親に渡るのは最後の1発言だけで、 それも親のターンごと落ちれば次のセッションには残らない。ノートが無ければ 再開時に一から流し直すことになる。 - ノートの1行目に依頼の1行要約を書く。中断記録と突き合わせるための目印になる。 - 最終報告はノートへの参照と要約でよい。同じ内容を二重に書かない。 - 追記は `cat >> &lt;パス> &lt;&lt;'EOF'` で行う。**書いてよいのは自分のノートだけ**で、 ソースツリーは読み取り専用のまま。 読み取り専用エージェントに書き込みを許すのは一見矛盾していますが、 書いてよい場所を自分のノートだけに限定 することで、ソースツリーの読み取り専用性は保っています。 再開ブリーフィングの手順 1 が「まずノートを見る」になっているのはこのためです。ノートが残っていれば、 SendMessage が届かなくても「どこまで終わっていて、次に何をするか」を書いた 新しい指示 を作れます。前回の依頼文を丸写しするのではなく、差分だけを渡す。ここは前回の記事で作ったリレーガードの思想とも一致します。 5. 設定側で被害そのものを減らす 記録と再開の仕組みとは別に、 settings.json の env で被害の総量そのものを削っています。 { "env": { "CLAUDE_AUTO_BACKGROUND_TASKS": "1", "CLAUDE_CODE_MAX_TOOL_USE_CONCURRENCY": "6" } } CLAUDE_AUTO_BACKGROUND_TASKS=1 は、約 2 分を超えたサブエージェントを自動でバックグラウンドへ移す設定です。前節のとおり、まだ何も出力していないフォアグラウンドのサブエージェントだけは中身ごと失われるので、長い作業をバックグラウンドへ逃がすのはそのまま保険になります。 なお v2.1.198 以降、サブエージェントは既定でバックグラウンド実行になりました。Claude が「結果を待ってから続けたい」と判断した場合はフォアグラウンドを選ぶので、この設定はそこに掛ける保険という位置づけです。 CLAUDE_CODE_MAX_TOOL_USE_CONCURRENCY=6 は並列実行の上限を下げるものです。1 回の中断で巻き添えになる作業を減らす狙いですが、下げすぎると通常の調査が目に見えて遅くなります。6 はそのトレードオフの落としどころでした。ただしこの変数は 公式ドキュメントに記載がありません 。挙動が変わっても不思議はないので、無くても困らない設定として扱っています。 6. 状態ファイルを GC する 放っておくと .claude/agent-calls/ も .claude/recovery/ も溜まる一方なので、 UserPromptSubmit で掃除します。 GC_DAYS="${HOOK_STATE_GC_DAYS:-7}" find "$CALLS_DIR" -mindepth 1 -maxdepth 1 -type d -mtime "+$GC_DAYS" -exec rm -rf {} + 2>/dev/null || true find "$RECOVERY_DIR" -mindepth 1 -maxdepth 1 -type f \ \( -name '*.json' -o -name '*.json.consumed' \) -mtime "+$GC_DAYS" -delete 2>/dev/null || true find "$NOTES_DIR" -mindepth 1 -maxdepth 1 -type f -name '*.md' -mtime "+$GC_DAYS" -delete 2>/dev/null || true 保持は 7 日。中断記録もノートも、7 日経てば再開の役には立ちません。 -name で対象を絞っているのは、同じ場所に置いた無関係なファイルを巻き込まないためです。 なお、ブリーフィングとして提示する条件(24 時間)と GC の保持期間(7 日)は別物です。24 時間を過ぎた中断は「別の作業の話」として提示しませんが、ファイルは調査用に 7 日残ります。 運用して分かった落とし穴 ここからが本題かもしれません。素直に作ると壊れるところが、思ったより多くありました。 完了判定を prompt_id 単位でやると完了済みを未完了と誤認する 最初の実装では、 .call.json と .done.json の突き合わせを 同じ prompt_id ディレクトリの中だけ でやっていました。素直な設計に見えます。 これが盛大に外れました。バックグラウンドのサブエージェントは ユーザーの発言をまたいで生き続ける ので、起動時の prompt_id と完了時の prompt_id は日常的に別物になります。同じ prompt_id の中だけを見ると、既に完了しているエージェントが軒並み「未完了」に化けます。 修正は、 .done.json の集約範囲を セッション全体 に広げることでした。これが collect_done_keys() がセッション配下の全 prompt_dir_names を舐めている理由です。 UUID の辞書順で切り捨てると本命が枠から漏れる 記録する未完了エージェントは 12 件を上限にしています。当初はこれを os.listdir() のソート順、つまり prompt_id の辞書順 のまま切っていました。 prompt_id は UUID です。 発行順とはまったく無関係 なので、辞書順で後ろに来た prompt_id に「いま本当に走っているエージェント」がいると、上限に押し出されて落ちます。実際、古い prompt_id に未完了の .call.json が 15 件、現在の prompt_id に本命が 1 件、という配置を作ったところ、本命が pending から完全に脱落しました。 いまは 呼び出し時刻の降順 に並べてから切っています。 time が無い/不正なレコードは最も古い扱いです。 pending_with_time.sort(key=lambda pair: pair[0], reverse=True) pending_total = len(pending_with_time) pending = [entry for _, entry in pending_with_time[:MAX_AGENTS]] 「上限で切る」実装を書くときは、 何の順で切っているか を必ず意識する、という教訓でした。 サブエージェントだけが殺されると StopFailure が発火しない これが一番気づきにくかったケースです。 レートリミットは、 サブエージェントだけを殺してメインのターンを生かす ことがあります。メインが生きているのでターンは正常終了扱いになり、 StopFailure は発火しません。つまり .claude/recovery/ に記録が作られない。 その場でメインが気づけば SendMessage で再開できますが、気づかないままセッションが終わると、走りかけのサブエージェントの存在は次のセッションに一切伝わりません。ハーネスの穴です。 塞ぎ方は、 session-start.sh に フォールバック走査 を足すことでした。中断記録が「無い」ときに限り、 .claude/agent-calls/ の台帳を セッションをまたいで 直接走査します。 def find_orphan_agents(calls_root, current_session_id, now): """中断記録が無いとき、他セッションに走ったまま終わったサブエージェントを探す。""" for session_dir_name in session_dirs: if session_dir_name == safe_name(current_session_id, "unknown-session"): continue # 現在のセッションはまだ生きている可能性があるので除外 done_keys = collect_done_keys(session_dir, prompt_dirs) pending_calls = collect_pending_calls(session_dir, prompt_dirs, done_keys, now, ttl_sec) ... 面白いのは、 turn-failure-record.sh は現在のセッションだけを見て、 session-start.sh は現在のセッションを除く全セッションを見る という、ちょうど裏返しの関係になっていることです。どちらも同じ 2 パス走査を使いますが、対象セッションの選び方だけが違う。だから pending_agents_shared.py は 2 パス判定そのものだけを持ち、 対象セッションの選び方・並べ替え・件数上限は呼び出し側の関心事 として意図的に外に置いています。 なぜモジュールに切り出したかというと、同じロジックが 2 箇所にあった時期に実際に事故ったからです。 .done.json の集約範囲をセッション全体に広げる修正が session-start.sh 側にしか入らず、 turn-failure-record.sh は prompt_id スコープのまま取り残されて、いま走っているエージェントが pending から脱落する退行が生まれました。 ブリーフィングに検証できない断定を書いていた これは実装バグではなく、 文章のバグ です。 初期のブリーフィングには、こう書いていました。 この記録が出ている = 新しいセッションが開始できている = 中断の原因になった API エラーは既に解消している 一見もっともらしいのですが、成立しません。 SessionStart hook は ローカルで走り 、モデルへの API リクエストが成功したことを前提にしません。制限中でも CLI は起動できて、その時点でブリーフィングは注入されます。 しかも厄介なことに、これはハーネスが毎セッション自動で注入する文言です。**モデルにはそれを疑う手段がありません。**検証不能な事実主張を、権威ある前提として毎回渡していたことになります。 いまは事実主張だけを削って、行動指示は残しています。 中断の原因になった API エラーがまだ続いているかどうかは、この記録からは分からない。ただし「まだ制限中かもしれない」はサブエージェントへの委譲を控える理由にならない。制限が明けていれば委譲は普通に動くし、明けていなければメインセッションが自分で実装しても同じように失敗する 行動指示は事実主張に依存せずに書ける、というのが学びでした。「制限は明けている から 委譲してよい」ではなく、「明けていてもいなくても自力実装に利点はない から 委譲する」と書けば、前提が崩れても指示は生き残ります。 「提示済み」の印で台帳の主データをリネームしていた 最後は設計の筋の悪さの話です。 孤児エージェントの走査には「一度提示したら二度出さない」印が要ります。中断記録のほうは .json → .json.consumed へのリネームでやっていたので、同じ考え方で .call.json → .call.json.presented とリネームしていました。 これが良くなかった。 .call.json は リレーガード・編集ガード・中断記録の 3 つの hook が共有で読む台帳の主データ です。中断記録の .json が「消費したら役目が終わる通知」なのとは性質が違います。 当時実害が出ていなかったのは、孤児スキャンが現在のセッションを除外していて、他の 3 つの hook は現在のセッションしか見ていなかったからです。偶然です。将来どれかの hook がセッションをまたいで .call.json を読むようにした瞬間、提示済みのものだけが黙って見えなくなります。 --resume で古いセッションを開き直した場合も同じ形で顕在化します。 いまは主データを変更せず、サイドカーの .presented.json を別に置く方式です。 def presented_marker_path(call_path: str) -> str: if call_path.endswith(".call.json"): return call_path[: -len(".call.json")] + ".presented.json" return call_path + ".presented.json" GC はセッションディレクトリごと rm -rf するので、入れ子のサイドカーも一緒に回収されます。 共有される主データに、片方の読み手の都合の状態を混ぜない。 当たり前のようでいて、既存のリネーム方式を横展開した結果うっかりやってしまいました。 実際に動かしてみる このハーネスは意図的にテストで固めています。hook は普段は黙って動くものなので、壊れても気づけないからです。 uv run python -m unittest discover -s .claude/tests -t .claude/tests -v 中断記録まわりのテストだけで、 turn-failure-record に 31 本、 session-start に 27 本、共有モジュールに 13 本、GC に 6 本あります。テストが守っている性質は、テストファイルの docstring に書いています。 """turn-failure-record.sh (StopFailure hook) のテスト。 このhookが守っている性質: 1. 「.call.json はあるが .done.json がない」= 中断時に走っていたエージェント。 この判定を誤ると、再開時に完了済みの調査まで流し直してトークンを二重に捨てる。 2. 未完了の判定はセッション配下の *全* prompt_id を見る。バックグラウンドの サブエージェントは発言をまたいで生き続けるため、直近の prompt_id だけを 見ると取りこぼす。 3. 何が起きても exit 0 で、書けないときは何も残さない(fail-open)。 """ 実際に記録された JSON も見てみましょう。これは執筆中にログインが切れて中断したときのものです( rate_limit ではありませんが、記録の形は同じです)。 session_id と prompt_id は実際の値をマスクしています。 cat .claude/recovery/*.json | python3 -m json.tool { "session_id": "00000000-0000-0000-0000-000000000000", "prompt_id": "11111111-1111-1111-1111-111111111111", "error_type": "authentication_failed", "error_message": "Login expired · Please run /login", "time": 1788485303.017802, "branch": "main", "git_status_lines": [], "pending_agents": [], "pending_total": 0, "finished_agents": [], "payload_keys": [ "cwd", "effort", "error", "hook_event_name", "last_assistant_message", "prompt_id", "session_id", "transcript_path" ], "payload_preview": { "effort": "{\"level\": \"high\"}", "hook_event_name": "StopFailure" } } payload_keys と payload_preview を診断用に残しているのが効きます。実際、 error / error_details / last_assistant_message というフィールド名はドキュメントどおりでしたが、 将来ペイロードの形が変わったときに同じやり方で気づける よう、生のキー一覧の記録は続けています。実測が安定した後も消していません。 そして、 error_type にも error_message にも候補キーが埋まらなかった場合の保険として、メッセージ本文からの推定も入れてあります。 RATE_LIMIT_HINT = re.compile(r"rate limit|usage limit|429|529|overloaded", re.IGNORECASE) if not error_type and RATE_LIMIT_HINT.search(error_message): error_type = "rate_limit" rate_limit / usage limit / 429 / 529 / overloaded は、いずれも「作業が飛ぶ」という点で扱いが同じです。大まかな推定で十分、という割り切りです。 さいごに 今回は、レートリミットでの中断を StopFailure で記録して SessionStart で再開ブリーフィングとして注入するハーネスを紹介しました。そして、 それが公式機能でほぼ代替できることに、作り終えてから気づいた 話でもあります。 要点をまとめます。 まず claude --continue を試す。 サブエージェントのトランスクリプトはセッション内で永続化され、再起動後も同じセッションを再開すれば止まった場所から再開できます。今回私が自作したハーネスより多くを復元します。 hooks を書く前に、公式ドキュメントの現在地を確認する。 CHANGELOG で使いたいイベントを見つけただけでは足りませんでした。「そもそもこの問題はまだ残っているのか」を、機能側のドキュメントで確かめるべきでした。 StopFailure はディスクに書くことしかできない (stdout も終了コードも無視される)。読ませる役目は SessionStart に持たせます。 未完了の判定は .call.json と .done.json の突き合わせ 。ただしバックグラウンドのサブエージェントは発言をまたぐので、 .done.json はセッション全体で集約します。 ハーネスが毎回注入する文言に、検証不能な断定を混ぜない。 モデルには疑う手段がありません。今回の私がまさに、検証していない断定を前提に半月ぶんの実装を積み上げていました。 hook で組む「ハーネス」は、Claude 本人の判断力に頼らずに運用ルールを機械的に効かせられるのが強みです。一方で今回のように、 ハーネス自身のバグは静かに効いて、気づいたときには何セッションも損をしている という性質もあります。テストを厚めに書いておくのは、その保険としてかなり効きました。 ただ今回いちばん効いたのは、テストではなくドキュメントの読み直しでした。Claude Code は更新が速いので、半年前の「できない」が今日も「できない」とは限りません。 とはいえ、まるまる無駄だったとも思っていません。 StopFailure が stdout も終了コードも捨てること、バックグラウンドのサブエージェントがユーザーの発言をまたいで生きること、 prompt_id が中断をまたぐと食い違うこと。 このあたりは自分で組んでみるまで知らなかった ことばかりで、hook でセッションをまたぐ状態を持つときの勘どころは、そのまま次に使えます。公式に追い抜かれたのは悔しいですが、Claude Code の内側がどう動いているかを一段深く知れたのは収穫でした。 同じように hooks で何かを塞ごうとしている方は、着手前に公式ドキュメントを一周してみてください。そのうえで、それでも塞ぎたい穴が残っていたら、作ってみる価値はあると思います! ご覧いただきありがとうございます! この投稿はお役に立ちましたか? 役に立った 役に立たなかった 0人がこの投稿は役に立ったと言っています。 The post Claude Code のレートリミット中断対策を hooks で自作したら、公式ドキュメントに答えが書いてあった first appeared on SIOS Tech Lab .

はじめに こんにちは! セーフィー株式会社でサーバーサイドエンジニアをしている坂上(@Bobtaroh)です。 先日、2026年8月5日(水)19:00より、「セーフィー × カンリー AI Night #2:AI開発における社内標準化の取り組み」をオンラインで開催いたしました! 第1回(詳細はこちら!)の続きとなる第2回目の開催となりましたが、今回も多くの方にご参加いただき、またアーカイブをご視聴いただいた皆様、本当にありがとうございました。 本記事では、当日の各LT(ライトニングトーク)のハイライトや、登壇者同士の白熱したクロストークの様子など、イベントの盛り上がりをお届けしま