
Cursor
イベント
該当するコンテンツが見つかりませんでした
マガジン

技術ブログ
みなさん、こんにちは。ソリューションアーキテクトの古屋です。今週も 週刊AWS をお届けします! 10 月も後半に入り、朝晩はすっかり肌寒くなってきましたね。年末が近づくこの時期、「今年のうちに AWS 認定を取っておきたい」と考えている方も多いのではないでしょうか。 そんな方に向けて、Pearson VUE で Pearson Global Retake というキャンペーンが実施されています。対象の試験に不合格だった場合に、同じ試験を 1 回無料で再受験できるもので、AWS 認定も対象に含まれています。初回の受験は 11 月 17 日までに済ませる必要があり、無料の再受験は年明けの 2027 年 1 月 4 日から 4 月 7 日の間に受けます。利用には事前の申し込み (オプトイン) が必要で、対象外の試験もあるので、予約の前に条件を確認しておいてください。「もし落ちても次がある」と思えると、受験の一歩目が踏み出しやすくなりますね。 それでは、先週の主なアップデートについて振り返っていきましょう。 2026年10月12日週の主要なアップデート 10/12(月) Amazon OpenSearch Service がインデックスレベル暗号化をサポート Amazon OpenSearch Service で、インデックスごとに異なる AWS KMS カスタマーマネージドキーを使った保存時暗号化ができるようになりました。従来はドメイン全体で 1 つの KMS キーしか使えませんでしたが、本機能により同一ドメイン上でデータの所有者や機密性に応じてキーを分離できます。マルチテナントアプリケーションでテナントごとに専用キーで暗号化する、といった構成が 1 ドメインで組めます。OpenSearch 3.3 以降を実行する新規ドメインが対象で、東京リージョンを含む 14 リージョンで利用できます。機能自体の追加料金はなく、標準の AWS KMS と OpenSearch Service の料金で利用できます。 Amazon Bedrock AgentCore の短期メモリで取り込み・取得・ストレージのデータ量に基づく従量課金制を導入 Amazon Bedrock AgentCore Memory の短期メモリ (STM) の料金体系が、従来のイベント件数ベースの定額制 (0.25 USD/1,000 イベント) から、データ量に基づく従量課金制に変わりました。新料金は ingestion (書き込み) 1.00 USD/GB、retrieval (取得) 0.20 USD/GB、storage (保存) 0.10 USD/GB-月の 3 つのディメンションで構成されます。ingestion と retrieval は 1 イベントあたり最小 12 KB、最大 64 KB として課金され、storage は各イベントの実サイズで課金されます。小さなイベントを頻繁に書き込む会話型エージェントでは、月額コストが従来よりも抑えられるケースがあります。長期メモリ (LTM) の料金は変更ありません。AgentCore Memory が提供されるすべてのリージョンで適用されます。 AWS Lambda が Lambda Web Functions を発表 AWS Lambda に新しいコンピュート形態である Lambda Web Functions が追加されました。コードがポートをリッスンして HTTP リクエストを直接処理するモデルで、Express、Fastify、Hono などの Node.js フレームワークをアダプターなしでそのままデプロイできます (Next.js は standalone モードで、ホストとポートを指定する小さなエントリーファイルを追加すれば動作します)。1 つの実行環境が最大 128 の同時リクエストを処理し、課金はリクエスト数、アクティブ CPU 時間、実行環境のメモリ保持時間の組み合わせになります。DB や外部 API の応答を待つ時間には CPU 課金が発生しません。バージニア北部、オハイオ、オレゴン、東京、アイルランドの 5 リージョンで利用できます。 Amazon CloudFront が AWS Lambda Web Functions のオリジンサポートを開始 Amazon CloudFront のオリジンとして AWS Lambda Web Functions を直接指定できるようになりました。CloudFront を前段に置くことで、エッジでの TLS 終端、キャッシュ、ACM 証明書によるカスタムドメインを、アプリケーションコードの変更なしで利用できます。Origin Access Control (OAC) を設定すると、CloudFront 経由以外のアクセスを IAM 認証で拒否でき、CloudFront のエッジネットワークによるネットワーク層 DDoS 対策と AWS WAF によるアプリケーション層の保護を組み合わせられます。OAC は専用の署名動作により視聴者の Authorization ヘッダーをそのままオリジンへ渡すため、JWT や Cookie などアプリ独自のサインインフローは変更不要です。追加料金はなく、CloudFront 中国リージョンを除く全リージョンで利用できます。 10/13(火) Agent Toolkit for AWS でコーディングエージェントが SageMaker AI の高度な専門知識を活用可能に AWS AI/ML skill が Agent Toolkit for AWS のコアスキルとして提供されました。Kiro、Claude Code、Codex、Cursor などのコーディングエージェントが、モデルの選定、トレーニング、最適化、デプロイといった Amazon SageMaker AI の操作を自然言語ワークフローで実行できるようになります。従来 AWS Labs (awslabs/agent-plugins) で提供されていた skills とプラグインは Agent Toolkit for AWS に一本化され、今後はこちらが唯一のサポート対象の統合ポイントになります。skill は SageMaker Studio JupyterLab にプリインストールされており、追加料金なしで利用できます (エージェントが使用する AWS リソースの料金のみ発生します)。 Amazon SageMaker Studio がソーシャルサインインに対応し、新規 AI/ML 開発者の利用開始を簡素化 Amazon SageMaker Studio が、Google、GitHub、Apple の既存アカウントによるサインアップに対応しました。新規顧客は従来の AWS アカウント作成、コンソール操作、IAM 設定を行わずに、また多くの場合クレジットカード登録もなしで、設定済みの Studio 環境で基盤モデルのファインチューニング、評価、デプロイを開始できます。AWS 無料利用枠の無料クレジット (登録時に 100 USD、追加で最大 100 USD) が付与され、検証済み顧客は G5、G6、G6e、G4dn インスタンスへのデフォルト GPU アクセスをクォータ申請なしで利用できます。チームメンバーをメールで招待でき、招待された側も自分のメールアドレスでサインインして共有環境にアクセスできます。本機能は SageMaker Studio がサポートされるすべての AWS 商用リージョンで利用できます。 AWS Lambda durable functions が durable operation 数とチェックポイントペイロードの上限を引き上げ AWS Lambda durable functions の実行あたりの durable operation 数の上限が 3,000 から 30,000 に、チェックポイントペイロードサイズの上限が 256 KB から 1 MB に引き上げられました。operation 数の増加により、反復ループの拡大、長期間のポーリング、ステップ失敗時のロールバック処理など、1 回の実行でより多くの処理を行えます。1 MB のチェックポイントは Lambda 非同期呼び出し、Amazon SQS、Amazon EventBridge の最大ペイロードサイズと一致するため、これらのイベントソースから受け取ったイベント全体を 1 回の operation で永続化できます。新しい上限は durable functions が利用可能なすべてのリージョンに適用されます。 10/14(水) AWS Security Hub が優先順位付けのためのリソース重要度をサポート AWS Security Hub のエクスポージャー優先順位付けに、リソース重要度 (resource criticality) が追加されました。自動化ルールで「特定アカウントの全コンピュートリソースを Very High にする」といった明示的な設定ができるほか、設定なしでもタグとリソース名から重要度を自動推論します。重要度は Resources ページの列およびエクスポージャー検出の Impact assessment タブに表示され、ソート、フィルター、グループ化に使えます。Security Hub Essentials に追加料金なしで含まれ、全ユーザーに対して常時有効のため、有効化作業は不要です。Security Hub が利用可能なすべての AWS リージョンで利用できます。 AWS Lambda の再帰ループ検出が Amazon EventBridge カスタムイベントバスに対応 AWS Lambda の再帰ループ検出機能が、Amazon EventBridge カスタムイベントバスを経由する再帰ループの検出と自動停止に対応しました。Lambda Event Function がカスタムイベントバスにイベントを書き戻し、それが同じ関数を再度起動する構成で、同一イベントチェーンの呼び出しが約 16 回に達すると Lambda が後続の呼び出しを停止します。この機能はすべてのアカウントでデフォルトで有効であり、設定変更や追加料金は不要です。意図的に再帰を使う設計の場合は、PutFunctionRecursionConfig API で関数単位の無効化が可能です。EventBridge カスタムイベントバスが利用可能なすべての AWS 商用リージョンで利用できます。 10/15(木) AWS Resilience Hub の検出結果とテスト結果を AWS DevOps Agent でレビュー可能に 次世代 AWS Resilience Hub が AWS DevOps Agent と統合されました。レジリエンステストを実行すると DevOps Agent による調査が開始され、症状、根本原因、影響、観測された復旧アクション (Amazon Application Recovery Controller (ARC) のリージョン切り替え (Region switch) など) を含む構造化された分析結果を確認できます。また、障害モード評価 (failure mode assessment) の各検出結果から、その検出結果のコンテキストを引き継いだ状態で DevOps Agent との対話セッションを開始し、質問や調査を通じて緩和策を作成できます。利用を始めるには、Resilience Hub コンソールでサービスを選択し、サービス設定で DevOps Agent を構成します。東京リージョンでも利用可能です。 Amazon CloudFront が VPC origins の dual-stack サポートを発表 Amazon CloudFront の VPC origins が dual-stack (IPv4 / IPv6) に対応しました。これにより、プライベートサブネット内の Application Load Balancer (ALB)、Network Load Balancer (NLB)、EC2 インスタンスに対して、ビューワーからオリジンまでエンドツーエンドで IPv6 トラフィックを届けられます。従来、CloudFront から VPC origins への接続は IPv4 のみで、IPv6 でオリジンに接続するにはオリジンをパブリックサブネットに置く必要がありました。本アップデートにより、オリジンを非公開に保ったまま IPv6 のアーキテクチャ要件や規制要件を満たせます。VPC origins がサポートされるすべての AWS 商用リージョンで利用でき、追加料金はありません。 AWS Transform for full-stack Windows modernization が Aurora PostgreSQL のクロスリージョンデプロイに対応し、新たに 7 リージョンで利用可能に AWS Transform for full-stack Windows modernization が、変換後の Amazon Aurora PostgreSQL データベースを別リージョンへデプロイするクロスリージョンデプロイに対応しました。あわせて、従来のバージニア北部リージョンに東京リージョンを含む 7 リージョンが加わり、合計 8 リージョンで利用可能になりました。SQL Server の DDL ファイルをアップロードし、変換プランでターゲットリージョンを指定するだけで、スキーマ変換と Aurora PostgreSQL クラスターのデプロイを別リージョンに対して実行できます。依存する .NET アプリケーションの接続文字列や ADO.NET、Entity Framework のデータアクセスコードも同じワークフローで PostgreSQL 互換に更新されます。データレジデンシー、レイテンシー、ディザスタリカバリの要件に応じてデプロイ先を選択できるようになりました。 10/16(金) AWS Transform が Azure から AWS へのクラウドネイティブコード変換を発表 AWS Transform の .NET モダナイゼーションエージェントで、Azure SDK から AWS SDK へのアプリケーションコード変換機能の一般提供を開始しました。Azure Functions から AWS Lambda、Azure Blob Storage から Amazon S3、Azure Queue Storage から Amazon SQS への変換に対応し、Azure Cosmos DB から Amazon DynamoDB への変換はプレビューとして利用できます。エージェントがソースコード内の Azure SDK を自動検出し、アセスメントレポートとモダナイゼーションプランに変換オプションを提示するため、ユーザーは内容を確認、調整したうえで変換を実行できます。変換対象はアプリケーションコードのみで、Azure 側のクラウドインフラの移行は対象外です。バージニア北部、ムンバイ、東京、ソウル、シドニー、カナダ中部、フランクフルト、ロンドンの 8 リージョンで利用できます。 Reflection の Beam モデルが Amazon SageMaker JumpStart と AWS Trainium で利用可能に 米国の AI 企業 Reflection が初のオープンウェイトモデル Beam を公開し、Amazon SageMaker JumpStart から利用できるようになりました。Beam は総パラメータ 501B (アクティブ 23B) のスパース MoE モデルです。Reflection によると、SWE-bench Verified で 80.9% を記録するなど、コーディング、推論、エージェント系ベンチマークでオープンウェイトモデルとして高い水準の性能を持ちます。Apache 2.0 ライセンスのため、顧客は自社の AWS アカウント内でモデルを検査、カスタマイズ、運用でき、データを外部 API に送信せずにコーディングエージェントや自動化ワークフローを構築できます。あわせて AWS Trainium3 への移植と最適化も発表され、GPU 以外のコスト効率の高いデプロイ選択肢が示されました。現時点ではバージニア北部とオハイオの 2 リージョンで利用できます。 それでは、また来週お会いしましょう! 著者について 古屋 楓 (Kaede Koya) / @KaedeKoya35328 AWS Japan のソリューションアーキテクトとして、多種多様な業界のお客様をご支援しています。特定の技術やサービスに偏らず、幅広い分野のご相談に対応し、技術相談会や各種イベントにて登壇しています。好きな AWS サービスは Amazon Lightsail と Kiro で、シンプルかつ柔軟にクラウドの力を活用できる点がお気に入りです。休日は愛犬 2 匹と静かに過ごしています。

Claude Code ぶん回して仕様駆動開発を実践してみた 〜 設計書3.6万行と6つの落とし穴 〜 この記事のポイント 問題提起 背景 前提 システムの全体像 開発体制と Claude Code の使い方 設計時のぶん回し 設計書を Fix してから実装する 依頼は「まず既存の仕組みを調べて」から始める 選択肢は「影響範囲」の列を立てて比べる 決まったことは設計書の冒頭とメモリに残す アーキテクチャ選定で分かったこと 画面設計:Excel と MD3 の方針だけで作る 実装時のぶん回し 実装計画も、人間がレビューしてから走らせる テストは先に書かせ、失敗を見てから実装させる OpenAPI と design.md で「正」を分ける インフラ:検証環境と本番環境の差異に苦戦 新本番環境想定の負荷試験をやり切る アプリ動作確認:エミュレータを Claude Code に操作させる 実装計画に「セルフフィードバック」を組み込む Crashlytics の調査 問題点と解決策 問題点 1:尤もらしい誤りと「存在しない懸念」が紛れ込む 解決策 1:「推測」と「確定」を分けて書かせ、出典を残させる 問題点 2:AI は足し算が得意で、引き算が苦手 解決策 2:方針とスコープで「引き算」を仕組みにする 問題点 3:ドキュメントが膨大になり、人間のレビューが追いつかない 解決策 3:人間が読むもの(design.md)と AI が読むもの(plan.md)を分ける 問題点 4:設計書と実装がズレていく 解決策 4:実装結果を設計書に書き戻すまでを「完了」にする 問題点 5:リポジトリやセッションをまたぐと前提が抜け落ちる 解決策 5:共有メモリと HANDOFF.md でコンテキストを受け渡す 問題点 6:Git 操作で作業ツリーやブランチ運用を壊しかける 解決策 6:Git のルールを CLAUDE.md に明文化し、コミットは人間が握る まとめ 問題提起について 誰が読んでも共通のドメイン知識を持てる product-docs 最後に こんにちは、開発本部 開発2部 RetailHUB NetSuperグループに所属するホーク🦅アイ👁️( @every_hawk_eyes )です。本記事で紹介するプロジェクトでは、エンジニアリーダーとしてフロントエンド・バックエンド・インフラ・アプリ開発のすべてに関わりながら、プロダクトマネジメントも少し担っていました。 この記事のポイント 2026 年 6〜8 月の 3 か月間、3〜7 名のチームで、ネットスーパーの Server API、AWS基盤、ピッキングアプリを、Claude Code を中心に新規開発 設計書を Claude Code に書かせ、人間がレビューで Fix してから実装する、仕様駆動開発(SDD)に近い進め方をとった。1 つの機能だけで設計書・計画書は約 3.6 万行に達し、ボトルネックは人間のレビューへ デザイナー不在の中、注釈付き既存画面スクショと Material Design 3 の方針だけでアプリ開発 AI の尤もらしい誤り、足し算の設計、膨らむドキュメント、設計書と実装のズレ、コンテキストの断絶、Git 事故という 6 つの落とし穴を、解決策と併せて紹介 問題提起 AI に任せてもそれなりのものが作れる時代でも、平準化されないエンジニアの価値とは、 AI と質疑を重ねて設計を詰め切る力と、チーム内議論での発言力・決断力ではないか AI の尤もらしい誤りを疑うためのドメイン知識とシステム全体の理解を得るには、 誰が読んでも共通のドメイン知識を持てるドキュメント整備が肝要なのではないか 背景 弊社では Claude を非エンジニアも含めた全社に展開しており、我々のチームでも今年 3 月に Cursor から Claude Code へ移行しました。 2026 年 6〜8 月には、新しい小売チェーン向けにネットスーパーを立ち上げる新規開発がありました。Server API、AWS インフラ、店舗の作業者が使う Android のピッキングアプリまでを、最小 3 名、いちばん多い時期でも 7 名(1 か月間のみ)で作る必要があり、アプリのデザイナーもいません。そこで、設計から実装・テスト・障害調査まで、Claude Code を「ぶん回す」前提で進めました。 本記事では、うまくいったやり方に加えて、 現場で実際に起きた問題点と、それに対する解決策について を紹介します。 前提 システムの全体像 システムの全体像。既存の小売は、別のクラウドサービスの VM で動くネットスーパー本体(PHP)と DB を使う。新規小売は、AWS に移したネットスーパー本体(PHP / ECS Fargate)と RDS を使う。両方の本体から Go の Server API を呼び出し、Server API は両方の DB を読み書きする。ネットスーパーから独立したピッキングシステムは、Server API から注文データを受け取って Aurora DSQL に保存し、Server API へは EventBridge のカスタムバスと API Destination で非同期に連携する ネットスーパー本体は、別のクラウドサービスの VM で長年動いてきた PHP のシステムです。本体は極力改修しない方針で、新しい処理は Go の Server API に寄せています。今回は、主に次の 2 つの対応が必要でした。 インフラを AWS に 1 本化するための、ネットスーパー本体の AWS へのマイグレーション。今回の新規小売が、移行先の AWS で本番を立ち上げる最初の小売になった(9 月 1 日にローンチ) ネットスーパーとは独立したプロダクトとして開発しているピッキングシステムに、注文単位でピッキングする新モードを追加する開発 呼び出しの向きは「ネットスーパー本体 → Server API → ピッキングサーバー」を基本とし、逆向きは EventBridge 経由の非同期に限っています。1 つの機能が 4〜5 リポジトリにまたがる構成です。 開発体制と Claude Code の使い方 項目 内容 人数 最小 3 名〜最大 7 名(7 名体制は 1 か月間のみ)。インフラは専任を置かず全員が兼務 設計書 product-docs(Markdown の設計書を GitHub で管理するリポジトリ。名前は本記事での仮のもの) デザイナー 不在(Figma などのデザインツールも不使用) Claude Code VSCode 拡張版やターミナル経由。プラグインは superpowers を中心に使用 Claude Code は次のように設定して使いました。 メインのセッションは、その時点の最新の上位モデルに、Effort を Extra high にして実行していた。サブエージェントのモデルは特に指定せず、Claude Code の既定に任せました 2026 年 8 月 14 日に Auto モードが default 化されてからは、常に Auto モードでプロンプトを実行してました。それに合わせて、以前の記事 で紹介した Hooks による macOS の通知は、Claude Code から質問が来たとき(AskUserQuestion)だけ鳴るように変えました それまでは「Edit automatically」で使いながら、 .claude/settings.json の許可ルールを都度追加して整えてきたので、Auto モードに切り替えることに不安はありませんでした ツールの構成や挙動は、2026 年 6〜8 月時点のものです。 設計時のぶん回し 設計書を Fix してから実装する 今回いちばん効果があったのは、 いきなりコードを書かせない ことでした。複数リポジトリにまたがる機能をそのまま実装させると、仕様の解釈違いや影響範囲の見落としが後から大量に出てきます。そこで、superpowers のワークフローに乗せて、次の流れで進めました。 ① 要件と関連資料を渡し、「まず既存の仕組みを調べて」と頼む ② brainstorming:コード調査 → 質問 → 選択肢の比較 → 人間が方針を選ぶ ③ 設計書(DD)を書かせ、チームがレビューして Fix する ④ writing-plans:実装計画(PD)を実装リポジトリごとに作らせ、人間がレビューする ⑤ TDD とタスクごとのセルフレビューで実装させる ⑥ 実装で判明した差分を DD / PD に書き戻させる これはいわゆる仕様駆動開発(SDD)です。Birgitta Böckeler 氏の整理でいえば、実装後も設計書に書き戻して保守に使い続ける「spec-anchored」に近い運用です。superpowers の基本のワークフローとの違いは、設計書を専用のリポジトリに置いてチームでレビューすることと、実装計画を実装リポジトリごとに分けることです。 参考: Understanding Spec-Driven-Development: Kiro, spec-kit, and Tessl (Birgitta Böckeler 氏、2025 年 10 月 15 日。SDD を spec-first / spec-anchored / spec-as-source の 3 段階に整理しています) 参考: obra/superpowers (GitHub。README の「The Basic Workflow」に各スキルの役割が書かれています) AI に任せるのは「調べる・書く」まで、「決める」のは人間 と線を引き、設計書も実装計画も、人間が OK を出すまで次の工程に進ませないことがポイントです。 依頼は「まず既存の仕組みを調べて」から始める 「こう作ってほしい」と実装方法から指示するより、 先に既存の仕組みを調べさせる ほうが、既存の作りに沿った無理のない案が出てきます。 選択肢は「影響範囲」の列を立てて比べる 方針を決める前に、2〜3 個の選択肢を「処理の流れ・メリット・デメリット」付きで並べさせ、人間が選びます。判断が割れる論点は、ここでチームでも議論します。比較の表には 変更対象の影響範囲 の列も必ず立てさせています。「1 行追加するだけ」の改修案が、実は 10 以上の小売が共有し、毎日使われる画面への変更だったことがあるためです。 決まったことは設計書の冒頭とメモリに残す 議論で決まったことがチャットに埋もれていると、AI は次のセッションでそれを参照できません。設計書の冒頭に「決定事項サマリー」を置き、レビューで受けた指摘は「なぜ」と「次からどうするか」を付けて Claude Code のメモリに残すようにしました。こうしておくと、一度受けた指摘を毎回言い直す必要がなくなります。 アーキテクチャ選定で分かったこと EventBridge を使った 2 つの仕組み(バッチの起動と、ピッキングサーバーからの非同期連携)は、どちらも選択肢を並べて比べ、 採用しなかった案とその理由 を設計書に残しました。その中で分かったことは次の 3 つです。 前提から見直す。NAT Gateway の新設コストを避けるためにバッチのタスクをパブリックサブネットに置いていたが、見直すと NAT Gateway はすでにあり、そもそもの前提が成り立っていなかった 非同期にするなら、受け手の作法まで決める。EventBridge の API Destination は応答待ちが最大 5 秒で、リトライするのは 5xx と一部の 4xx だけなので、受け手は 5 秒以内に返し、再送しても直らないエラーはリトライされない 4xx で返す。同じイベントが何度届いても結果が変わらないようにもしておく 非同期がいつも正解ではない。ECS のタスク起動に 1 分ほどかかるため、データ連携の開始時に台帳を作る処理は同期にした 参考: Amazon EventBridge のターゲットとしての API 送信先 (AWS ドキュメント。5 秒のタイムアウトと、リトライするエラーコードの一覧が載っています) 画面設計:Excel と MD3 の方針だけで作る デザイナーもデザインツールも使わず、インプットは既存アプリのスクショに要望の吹き出しを描き足した Excel と、Material Design 3(MD3)に沿うという方針だけでした。Claude Code は画像を読めるので、スクショを渡して画面ごとの設計書に MD3 のコンポーネント、色・文字のトークン、アクセシビリティまで書かせ、アプリ開発エンジニアがレビューしてから実装しました。これでデザイナー不在でも「エンジニアのなんとなくの見た目」にはなりませんでしたが、 現場の作業者が使う業務アプリ だから成立した面も大きいです。 実装時のぶん回し 実装計画も、人間がレビューしてから走らせる 設計書が Fix したら、superpowers の writing-plans で実装計画 plan.md を作ります。作業を 1 ステップ 2〜5 分の単位に分け、ファイル・コード・テストの方法まで書く方針なので、1 本で 2,000 行を超えることも珍しくありません。plan.md も 人間がレビューしてから実装に入ります 。plan.md を書き終えるなり実装を始めさせると、ファイルの数・タスクの順序・コミットの粒度といった、こちらの方針が反映されるべき判断を後から直すコストが大きいためです。 テストは先に書かせ、失敗を見てから実装させる AI は「テストが通るように実装を寄せる」だけでなく「実装に合わせてテストを直す」こともやりがちなので、 先に失敗を見る 手順を挟むことが大事でした。 OpenAPI と design.md で「正」を分ける API の型は OpenAPI、業務的な意味は design.md を正とすることで、サーバー担当とアプリ担当が I/F だけ先に合意し、それぞれ Claude Code で並行して実装を進められました。 インフラ:検証環境と本番環境の差異に苦戦 移行先の AWS の本番環境は、Claude Code に 今春既に構築済の検証環境 の Terraform を棚卸しさせ、「検証環境 のこのリソース → 本番ではこの名前・この設定で作る」という対応表を設計書にまとめさせたうえで、約 2 週間で構築しました。この期間は単に AWS リソース作成だけで終わらず、セキュリティ対策や、本番環境特有の WEB アプリケーション側の設定ファイルの設定差異を調整する作業も行いました。 新本番環境想定の負荷試験をやり切る ローンチ前の負荷試験を1人でやり切る必要があったためここでも Claude Code をぶん回してやり切りました。 目標値は推定ではなく、既存の小売の実アクセスや過去の注文実績データから出しました 環境はコスト節約のため AWS リソース適用を 3 モードで切り替えられるように工夫しました ワーカーの枯渇を見逃さないように外部依存のモックには本番相当の遅延を入れるようにしました ボトルネックは Web ではなく DB という結果が得られ、インデックスの欠落を見つけることができました アプリ動作確認:エミュレータを Claude Code に操作させる 画面をまたぐ動作確認は、Claude Code に Android エミュレータを adb で操作させ、スクリーンショットを見て判定させました。弊社のテックブログには、iOS シミュレータと Maestro MCP で試した記事 もありますが、今回は MCP を使わず素の adb です。カメラを使う画面も、エミュレータの仮想カメラに QR コードの画像を貼れば、実機なしで確認できます。一方で、ラベルプリンターやハンディ端末のスキャナーはエミュレータでは確かめられないので、widget テストと人間による実機確認で補いました。 参考: カメラのサポート (Android Studio のドキュメント。エミュレータの仮想シーンに QR コードなどの画像を取り込む手順が載っています) 実装計画に「セルフフィードバック」を組み込む 実装計画の最後には、ブランチ全体の差分をレビューさせるタスクを毎回入れ、 設計書に書かれていない実装上の判断 (失敗時の扱い、エッジケース、競合、再試行など)を重点的に見させています。人間のレビュー指摘が、設計書で合意済みの部分よりもこうした隙間に集中していたためです。このレビューで、「何も選ばずに適用すると全件分の重いリクエストが飛ぶ」という設計書自体の欠陥が見つかったこともあります。 Crashlytics の調査 Firebase MCP 経由で Crashlytics の FATAL を調べさせると、 別々に見えていた 3 件(計 69 events)が、1 つの共通実装に起因している ことを突き止めてくれました。 問題点と解決策 ここからが本題です。3 か月ぶん回してみて実際に困ったことと、取り入れた解決策を組にして紹介します。 問題点 1:尤もらしい誤りと「存在しない懸念」が紛れ込む AI が書いた設計書は体裁が整っていて、それらしく読めてしまいます。しかし実際のレビューでは、指摘に対して次のような回答が返ってくる場面がありました。 AI が出したけど誤っていた内容で、削除するのを失念していました。 AI が「こういう問題が起こりうる」と言い始めて、調査したらそんなものはなかった、というやり取りがあって、そのやり取りをわざわざ設計書に入れてしまっていました。 インフラでも、EFS のバーストクレジットが尽きるまでの日数や、試験環境の維持費(月 $3〜20 → 実測で月 $1.3)の見積もりが、尤もらしい根拠付きで大きく外れていました。AI は「知らないこと」を知らないとは言わず、それらしく埋めてしまいます。そして 書いた本人も AI の出力をすべて把握しきれていない まま PR が出てしまう、というのが一番怖いところでした。 解決策 1:「推測」と「確定」を分けて書かせ、出典を残させる 「 事実と推測を区別する 」をメモリにフィードバックとして残す 設計書には「未確定事項」の節を設け、確定していないことはそこに書かせる 決定事項には、いつ・どの議論で決まったかを添えさせる AI との試行錯誤の経緯は設計書に書かせない。残すのは 決まった結論と、その理由 だけ 業務の事実確認が必要な設計書は、業務を知るメンバーを必ず Reviewer に入れる 加えて、PR を出す前に「 この設計書の内容を、自分の言葉で説明できるか 」を作成者自身が確かめることが大事だと感じています。 問題点 2:AI は足し算が得意で、引き算が苦手 AI に設計させると、「この問題も起こりうるので対策を」「ここも新規 API を作って」と、機能と考慮事項がどんどん足されていきます。たとえばパッキング完了の書き戻しの設計書は、当初「受け取った側がピッキング結果を取りに行く API を新設する」案でした。これにレビューで「本当に新規で実装する必要がある? EventBridge にリクエストボディで渡せばいいのでは?」と指摘が入り、API を新設せずに済みました。AI は、工数や運用コストの観点で「そもそも作らなくていいのでは」と 引き算 をするのが苦手で、このレビューはまさにそれを人間が担った例です。 解決策 2:方針とスコープで「引き算」を仕組みにする 「無改修で済む案があるなら、既存コードを直す案より優先する」をメモリに残し、AI の提案の前提にする 判断が割れる論点は、設計書より先に選択肢比較を作らせ、影響範囲の列を見て人間が決める 設計書の冒頭には「スコープに含むもの」だけでなく「 スコープ外 」を必ず書かせ、外した論点は「残課題」の節に担当者付きで残す 「やらないこと」を書く場所をあらかじめ用意しておくと、AI が出してきた懸念を「今回はやらない、でも忘れない」と判断しやすくなります。 問題点 3:ドキュメントが膨大になり、人間のレビューが追いつかない AI は疲れないので、設計書も計画書もいくらでも書けます。設計書の PR は 3 か月で 68 本とリポジトリ別で最も多く、注文別ピッキング関連だけで設計書・計画書は 約 3.6 万行 、最も大きい設計書 PR は 1 本で 追加 12,670 行 に達しました。 人間がこれをすべて精読するのは現実的ではなく、「書いてあるけど誰もちゃんと読んでいない」箇所から、問題点 1 の誤りがそのまま素通りしてしまいます。SDD のツールを試した Böckeler 氏も「正直、これだけの Markdown ファイルより、コードをレビューしたい」と書いています。SDD はレビューのボトルネックを消すのではなく、コードから設計書という上流へ移すのだと思います。 解決策 3:人間が読むもの(design.md)と AI が読むもの(plan.md)を分ける ドキュメント 主な読み手 内容 人間のレビュー design.md(設計書) 人間 何を・なぜ作るか(業務的な意味、方針、影響範囲、未確定事項、非ゴール) しっかり読んで議論する plan.md(実装計画) AI どうやって作るか(ファイル単位のタスク、テスト、コマンド) ファイルの数・タスクの順序・コミットの粒度を中心に見て、OK を出してから実装させる 人間のレビュー力は有限なので、精読の優先度を design.md に置き、設計書は画面・サブ機能の単位に分けて 1 本の PR を小さく保つようにしました。実際、レビューの往復が多かった設計書 PR の上位 4 本は、 いずれも追加 400 行未満 でした。 PR が大量にある中、具体的なレビュー方針は次のように分けて実施しました。 設計書(DD) :議論すべき論点や、Fix が必要な未決事項を残した状態があっても PR を出し、チームで決めきりました 実装(編集量が大量ではないもの) :今まで通りの担当 Reviewer が全て目視でレビューをしました 実装(編集量が多いもの) :AI にレビューさせました。ただし任せきりにはせず、結果をまず Reviewer へ報告させ、その内容を吟味し AI と会話して、コメント投稿させていました 問題点 4:設計書と実装がズレていく 実装して初めてわかる仕様の穴は、必ず出てきます。実装中に Claude Code が「計画にない判断」をして解決すると、それが設計書に戻ってきません。設計書が古くなると、次の設計で AI がその古い前提を読み込んでしまい、設計駆動の良さが逆に仇になります。 解決策 4:実装結果を設計書に書き戻すまでを「完了」にする 実装が終わったら「計画からの逸脱」「実装で判明した仕様の穴」「残課題」を設計書に追記するところまでを、タスクの完了条件にする 設計書の冒頭にステータス欄(「実装済(日付)」「未リリース」など)を置き、実装のたびに更新させる なぜ計画から外れたかを一番よく知っているのは、実装したセッションの Claude Code なので、その場で書き戻させるのが最も安上がりです。 問題点 5:リポジトリやセッションをまたぐと前提が抜け落ちる 1 つの機能が複数のリポジトリにまたがるため、A リポジトリで決めたことを B リポジトリの Claude Code セッションは知りません。長い作業では、途中でコンテキストが要約されて細部も落ちます。開発人数が増減する中で、人間同士の引き継ぎに加えて「AI への引き継ぎ」も必要になりました。 解決策 5:共有メモリと HANDOFF.md でコンテキストを受け渡す 置き場所 スコープ 内容 CLAUDE.md 全リポジトリ共通 / リポジトリ 前提・ルール(Git の禁止事項、ドキュメントの置き場所など) メモリ リポジトリ レビューで受けた指摘や過去の経緯(「なぜ」と「次からどうするか」付き) 共有メモリ リポジトリ横断 他リポジトリに影響する変更(API 仕様、DB スキーマ、インフラ、設計判断など) HANDOFF.md 作業単位 セッションをまたぐ作業の引き継ぎ(いまの状態、次にやること、引き継ぎプロンプト) 共有メモリには、作業完了時に Skill で「影響先」「内容」「対応が必要なこと」を書き出させ、関連リポジトリで作業を始めるときに読ませています。「設計書のここがまだ実装に追従していない」といった申し送りも書かせているので、問題点 4 のズレを追跡する台帳にもなります。セッションの残りが少なくなったら、その時点の状態を HANDOFF.md に書き出させてから新しいセッションに切り替えると、細部が落ちる前に区切れます。 問題点 6:Git 操作で作業ツリーやブランチ運用を壊しかける AI は良かれと思って Git を操作します。設計書リポジトリの master への直接コミット、並行して動いていた別セッションの作業とぶつかるブランチの切り替え、別ブランチの中身を読むつもりの git checkout <ref> -- . で未コミットの 27 件のローカル変更を消す、ということが実際に起きました。未ステージの変更は Git では復元できず、残る手段は VS Code のローカル履歴だけです。 解決策 6:Git のルールを CLAUDE.md に明文化し、コミットは人間が握る ## 作業ツリーを壊さない(全リポジトリ共通・最優先) - 調査・参照のためにユーザの作業ツリーへ書き込むコマンドを実行しない。 他コミットの内容は ` git show <ref>:<path> ` / ` git worktree add ` などで読む。 - 明示的な GO なしに実行禁止: ` git checkout -- . ` / ` git restore ` / ` git reset --hard ` / ` git clean ` / ` git switch ` / ` git stash ` - 作業ツリーには常に未コミット変更がある前提で動く。触れる前に ` git status ` を見る。 あわせて、 git add -A は使わない、設計書リポジトリのコミット・push・PR は人間が行う、並行作業は git worktree add でディレクトリを分ける、といったルールもメモリに残しています。「AI を信用しない」のではなく、 AI が壊せない構造にしておく のがポイントです。 まとめ 3 か月間、少人数のチームで、Server API・インフラ・Android のピッキングアプリまでを、Claude Code をぶん回して開発しました。デザイナー不在でアプリを作り切れたのも、AWS へのマイグレーションと並走しながら本番構築から負荷試験までを回せたのも、AI 駆動ならではだと思います。 一方で、ぶん回してみてわかったのは、 AI 駆動開発のボトルネックは AI ではなく、人間のレビューと意思決定 だということです。AI は調べて書くのは圧倒的に速いですが、尤もらしい誤りを混ぜ、足し算で膨らみ、決めたことを忘れ、ときには Git を壊します。だからこそ、 設計書を先に書き、人間がレビュー・議論して Fix してから実装する 人間が読むもの(design.md)と AI が読むもの(plan.md)を分ける 決めたこと・やらないこと・ズレたことを、AI が読める Markdown に残し続ける AI が壊せない構造(ルールと worktree)を先に作っておく という「 人間が決めて、AI がぶん回す 」ための仕組みづくりが、結果的に一番の生産性向上につながりました。 問題提起について AI に任せきっても、それほど悪くないものができあがってしまうくらい、モデルの精度は高くなっています。その中で、エンジニアの存在意義や能力の差が平準化されるのでは、という危惧もあります。ただ、今回の開発プロジェクトを振り返ると、私は 決してそうではない と実感しています。理由は 2 つあります。 AI と設計を詰め切る力は、一朝一夕では身につかない :superpowers の brainstorming で AI と質疑を繰り返し、設計を Fix させる力は簡単には身につかないと思います。その議論をチームで行うときの発言力や決定力にも、差が大きく出てくるはずです AI を疑うには、ドメインとシステムの理解が要る :ハルシネーションによる誤りや、尤もらしい実装が出てきたときに、まず疑ってセルフフィードバックできることが重要です。そのためには、プロジェクトのユビキタス言語やドメイン知識、システム全体の仕様をしっかり理解しておかなければなりません 誰が読んでも共通のドメイン知識を持てる product-docs 設計書を置いている product-docs は、AI、エンジニア、問い合わせ担当、セールス担当の 4 種の読み手に役立つことを目指したリポジトリです。Markdown を中心に、Claude Code を通して誰が読んでも共通のドメイン知識を持てるよう、都度書きためています。書き足しているのはエンジニアなので設計書が多いですが、既存システムの仕様やアーキテクチャをまとめたドキュメントもあります。 このリポジトリをチームでフル活用したおかげで、ドメイン駆動での開発が円滑に進み、スポットで参加したエンジニア 3 名にもパフォーマンスを発揮してアウトカムを出してもらえたのではないかと感じています。 最後に エブリーでは、ともに働く仲間を募集しています。 テックブログを読んで少しでもエブリーに興味を持っていただけた方は、ぜひ一度カジュアル面談にお越しください! corp.every.tv

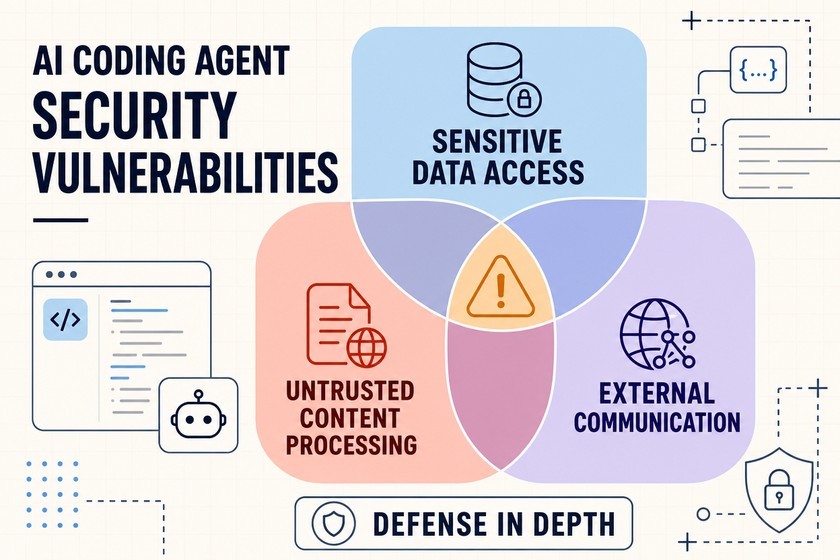
こんにちは。クラウドエース株式会社 第一開発部の木京です。 7月末の Google Cloud Next Tokyo(2026/7/30・31)に参加しました。 この記事では、各セッションの要約ではなく、会場を回って気になった2点と、そこから持ち帰ったことを整理します。 この記事の対象読者 AIツールを入れた後、何を確認すればよいか迷っている方 新しい技術を試すとき、セキュリティをどこから考えるか知りたい方 イベントでの所感を、自分の仕事に持ち帰りたい方 先に結論 AI活用は、ツールの名前を比べるより、何の仕事に使うか・誰が責任を持つか・効果をどう測るかを見る セキュリティ

動画
該当するコンテンツが見つかりませんでした
書籍
該当するコンテンツが見つかりませんでした





